8月26日、ServeTheHomeが「NVIDIA's Groq 3 LPU Accelerators for Heterogeneous AI Compute at Hot Chips 2026」と題した記事を公開した。この記事では、NVIDIAがGroq買収で得たLPU(Language Processing Unit)チップをVera Rubinラック群に統合し、AIトークン生成のデコード段階における低レイテンシ性能を大幅に引き上げる取り組みについて詳しく紹介されている。
NVIDIAがGroqのLPUを「自社製品」として発表するという異常事態
Hot Chips 2026でNVIDIAは、Vera CPU・Rubin GPUに続く3本目の発表として、LPU(Language Processing Unit)を取り上げた。ただし、この発表には独特の背景がある。NVIDIAは現時点でLPUを自社製造していない。LPX(Language Processing accelerator eXtended)ラックに搭載されているLPUは、NVIDIAが買収プロセスを進めているGroqのチップだ。Groqの主要エンジニアの大半がすでにNVIDIAに移籍しており、チップのプロモーションはNVIDIAが担う形になっている。
これはある意味でアクワイハイア(acquihire:人材獲得目的の買収)の生々しい現場だ。NVIDIAによるGroq買収は2025年に発表されており、買収規模の詳細は非公開とされている。Hot Chips会場でGroqチーム出身のエンジニアがNVIDIAの立場で発表するという、なかなか見られない構図が生まれた。発表者は「ここで発表できるのは夢のよう」とコメントしたという。
GPUとLPUの役割分担:なぜLPUが必要なのか
NVIDIAのVera Rubinスタックにおいて、GPUとLPUは異なる役割を担う。
- GPU(Rubin):プリフィル(Prefill)処理に強い。入力トークンを一括処理する段階で真価を発揮する。
- LPU(Groq 3):デコード処理に特化。モデルが次のトークンを1つずつ生成していく段階で、レイテンシを最小化する。
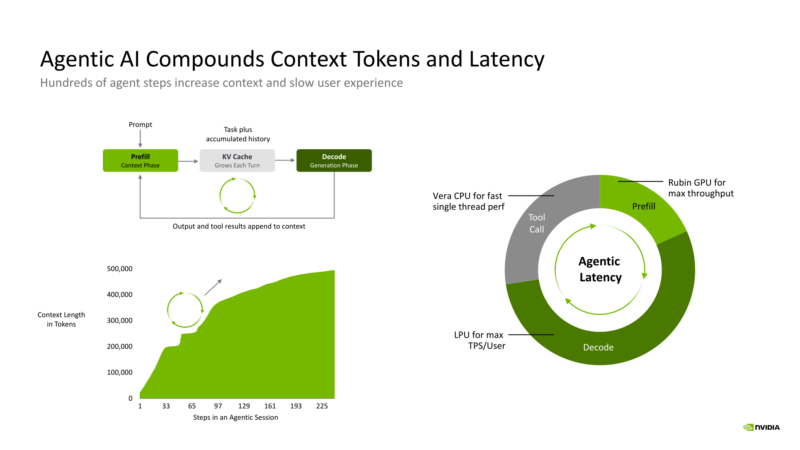
LLM推論においてデコードは全処理時間の大部分を占める。特にエージェント型AIでは大量のコンテキストトークンを扱うため、デコード速度の遅さがボトルネックになりやすい。LPUが対処するのはまさにここだ。
実益の観点から言えば、LPUの導入はユーザー体験に直結する。チャットボットやコーディングアシスタントでレスポンスが素早く返ってくるか、もたつくかの差は、このデコード段階の速度に左右される。GPUはプリフィルに最適化されているがゆえに、デコードでは帯域幅効率が低下しやすい構造的な弱点を抱えており、LPUはその弱点を専用設計で補う役割を果たす。
NVIDIAが示したパフォーマンスカーブでは、Rubin GPUのみの構成ではユーザーあたりのインタラクティビティを上げようとすると(=レイテンシを下げようとすると)スループットが急落する様子が示されている。LPXラックを追加することでこの曲線が大幅に改善され、Groqチームはこれを「ludicrous mode(狂気モード)」と表現している。
LPUアーキテクチャの核心:完全決定論的チップ
Groq 3 LPUの設計で最も特徴的なのは、完全決定論的(fully deterministic)であるという点だ。分岐(branching)もその他の非決定論的要素も一切存在しない。
この設計思想がもたらす連鎖的な帰結は大きい:
- 命令スケジューリングはすべてソフトウェア(コンパイラ)が担う。ハードウェア上にスケジューラを搭載する必要がないため、ダイ面積を他の用途に使える。
- ネットワーク制御もコンパイラが管理。ハードウェアのフロー制御やバーチャルチャネルは持たず、設計をシンプルに保っている。
- 各チップがプロセッサとルーターを兼ねる。何千ものチップが連携し、論理的に「1つの巨大なLPUコア」として振る舞う。
言い換えれば、「ハードウェアをシンプルにする代わりに、コンパイラに頭を使わせる」設計だ。これにより、演算資源の無駄が減り、デコード専用チップとしての効率が最大化される。
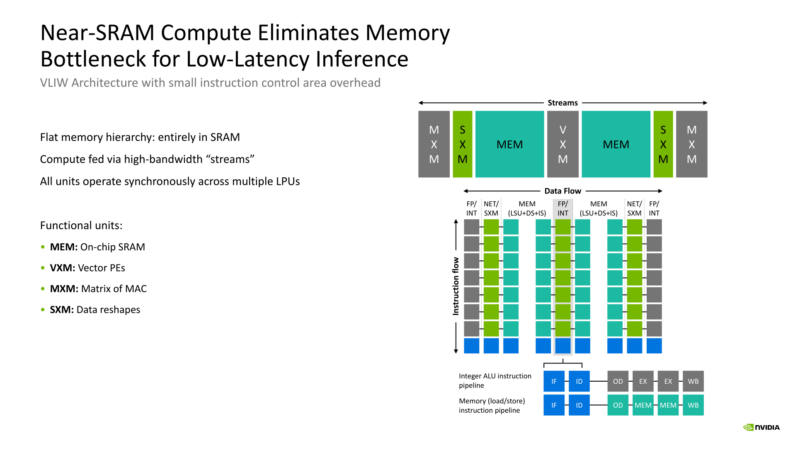
また、コンピュート素子のすぐ近くに大容量SRAMを配置する「Near-SRAM Compute」構造が、低レイテンシの要となっている。モデルの重みをチップ内のSRAMに収め、外部メモリへのアクセスを最小限に抑えることで、トークン生成を高速化する。この構造は、外部HBMへの往復レイテンシがボトルネックになりがちなGPUアーキテクチャとは対照的なアプローチだ。
LPXラックのスペック
1ラックあたりの主要スペックは以下のとおりだ:
| 項目 | 値 |
|---|---|
| LPU数 | 256基 |
| オンチップSRAM合計 | 128GB |
| 総SRAMバンド幅 | 40PB/秒 |
| FP8演算性能 | 315 PFLOPS |
| デコード性能(31Bモデル) | 11,000トークン/秒 |
31Bパラメータモデル(Gemma 4)で1ラックあたり11,000トークン/秒というデコード性能は、NVIDIAが今週Artificial Analysisに依頼して公開した第三者ベンチマークでも確認されている。そのベンチマークでは、次点の競合と比較して4倍のトークン出力レートを達成したとされている。なお、この比較対象はベンチマーク上で名指しされておらず、どの製品・チップを指すかについては現時点で確認できていない。
製造面ではNVIDIAのMGXラックアーキテクチャを採用しており、量産性と信頼性を担保している。MGXはNVIDIAのエコシステム全体で標準化・検証済みのハードウェア規格だ。
エージェント型AIが引き寄せたヘテロジニアス構成
NVIDIAはHot Chips 2026の全セッションを通じて一貫して「エージェント型AIは史上最も複雑なコンピューティングワークロード」と位置づけている。プリフィルとデコードで最適なハードウェアが異なるという現実が、GPU+LPUのヘテロジニアス(異種混在)構成を必然的に生み出した格好だ。
Groq 3 LPUの発表は、前日にNVIDIAがLPXラックの第三者ベンチマークを公開したタイミングと合わせて行われており、意図的な情報展開であることは明らかだ。
詳細はNVIDIA's Groq 3 LPU Accelerators for Heterogeneous AI Compute at Hot Chips 2026を参照していただきたい。