9月15日、RuntimeWireが「Reward AI launches OM-1 to run one policy across robot bodies」と題した記事を公開した。Reward AIが9月14日に発表したロボット基盤モデル「OM-1」は、ロボット固有のデータを一切使わず、人間の動作データのみを学習源として、異なるボディの複数ロボットを単一ポリシーで制御するという意欲的な設計を掲げる。「ハードウェアが変わるたびに再学習が必要」というロボット学習の常識を崩しうる発表として、業界の注目を集めている。
「ロボットごとに再学習」という常識を崩す
ロボット学習における高コストな制約の一つが、ハードウェアをまたぐポリシーの移植性のなさだ。あるロボット向けに訓練したポリシーは、別のロボットで動かすために新たなデータ収集と再訓練を必要とすることが多い。
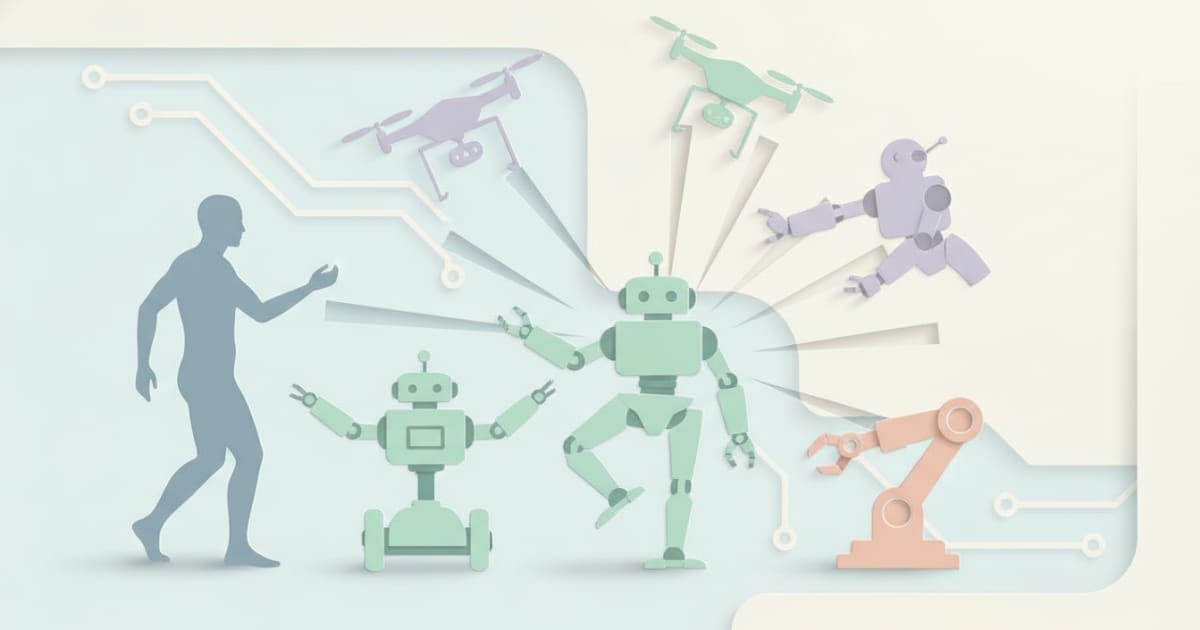
OM-1はこの問題に正面から挑む。同社の共同創業者Zipeng Fu(@zipengfu)とChen Wang(@chenwang_j)は、卓上アーム・産業用システム・ヒューマノイドを問わず、ロボット固有のファインチューニングなしに単一モデルで制御できると主張している。
両創業者はスタンフォード大学のロボティクス研究を出自に持つ。FuはMobile ALOHA(人間のデモンストレーションから学習する低コストモバイルマニピュレータ)やRobot Parkour Learningに携わり、Google DeepMindでも研究を行った。WangはDexCap——手首・指の動作をポータブルに収集するモーションキャプチャシステム——を主導し、同じくGoogle DeepMind・Nvidia・MIT CSAILで研究職を経験している。OM-1はこの2つの研究系譜を商用スケールで統合したものだと言える。
アーキテクチャの要点:人間の動作を「共通インターフェース」にする
OM-1の核心は、人間の動作データを唯一の学習源とする点にある。
同社が開発した専用ウェアラブルデバイス「Omnibody Hand」は7自由度を持ち、ピンチ・物体の向き変え・精密把持と力把持の切り替えといった操作に対応する。装着した人間がタスクを自然に実行する間、以下のデータを記録する:
- カメラ映像
- 触覚フィードバック
- 近接センサーの計測値
- 手軌跡(トラジェクトリ)
これらをOM-1に入力すると、モデルは動作方向・速度・力・把持タイミングを出力する。各センサーストリームはそれぞれのネイティブサンプリング周波数を維持しており、触覚や動作の高速信号をカメラのフレームレートに落とすことなく保持している点が設計上の特徴だ。
訓練データにロボットデータは一切使わない。テレオペレーション(遠隔操作)データも、ロボット自身の経験データも含まれない。人間のデモンストレーション映像・センサー記録から直接ロボットアクションを生成する設計だ。
その上で、各ロボット固有の動力学・遅延・物理制約の吸収は、強化学習コントローラーが担う。これはOM-1とは別にシミュレーション環境で訓練される低レベル制御モジュールであり、高周波でロボットの関節や駆動系を直接操作する役割を持つ。OM-1が「何をするか(タスクレベルの動作)」を出力し、強化学習コントローラーが「どう動かすか(ハードウェアレベルの制御)」に変換するという階層構造になっている。
また、収集したデモンストレーションをプレトレーニング用とポストトレーニング用に分割しない。全記録を同一のポリシー学習プロセスに投入し、将来の別ハードウェアにも再利用できる。つまり、データの価値がハードウェアに依存しない設計になっている。
デモで示した能力と、まだ示されていないもの
ローンチスレッドでは、以下のタスクをリアルタイム映像で公開している:
- 洗濯物の折り畳み
- 4本腕によるスマートフォンの梱包
- バーテンディング
- 冷蔵庫の開閉
- ラッチ付きイーサネットケーブルの抜き差し
Reward AIは「新タスクの学習に必要なデモンストレーションは30分未満」と主張している。また、一方のアームが失敗した際の補正、動作の再試行、環境変化時の中断といったリカバリー挙動も備えると説明する。生産現場でのサイクルタイムと自律復旧はロボット導入の実用性に直結するため、この点の主張は重要だ。
定量データとして公開されているのは1件:電磁トラッキングと視覚慣性トラッキングの比較で、最高速度時の平均オーバーシュートエラーを24.9mmから9.5mmに低減したとしている(8速度×10回の内部テスト平均)。ただしこれはデータ収集ハードウェアの精度指標であり、OM-1のタスク成功率を示すものではない。
現時点でのエビデンスは同社が公開したデモと技術的説明に限られる。未知のロボット・環境・長時間稼働における再現性は、今後の検証を待つ必要がある。
ロボット学習の文脈での位置づけ
クロスエンボディメント学習は新しい概念ではない。Open X-Embodimentのように複数ロボット種のデータを標準化して共同学習するアプローチもすでに存在する。Reward AIのアプローチはより絞り込んだ賭けだ——「ロボットデータを集めるのではなく、人間のデータを一度だけ集め、制御スタックが各機械に変換する」という構造である。
この変換が安定して機能するなら、メーカーがハードウェアを変更してもそれ以前に蓄積したデータを捨てずに済む。「one model, any body」という掛け声の商業的な前提は、ロボットを交換可能なインフラとして扱い、人間の行動データセットを耐久資産とみなす点にある。
詳細はReward AI launches OM-1 to run one policy across robot bodiesを参照していただきたい。