9月19日、The Decoderが「Google Deepmind's Dream-RSI helps AI agents improve by "dreaming" about past attempts」と題した記事を公開した。AIエージェントが探索を重ねるたびに「賢くなる」自己改善は長年の研究テーマだが、従来のアプローチでは戦略を評価するたびに高コストなライブ実行を繰り返すという根本的なボトルネックがあった。Google DeepMindが提案したDream-RSI(Recursive Self-Improvement:再帰的自己改善)は、実行済みの探索履歴を仮想的に「再体験」することでこの問題を回避し、試行回数を大幅に削減する。
「夢で復習する」ことで試行回数を激減させる
AIエージェントが複雑なタスクをこなす際、どのアプローチを試し、どれを諦めるかという「探索」の判断が、成否を大きく左右する。探索戦略を固定すれば柔軟性がなく、同じ失敗を繰り返す。かといって実行中に戦略を適応させようとすれば、戦略の評価のために何度も高コストなライブ実行を繰り返す必要がある。
Dream-RSI(Recursive Self-Improvement:再帰的自己改善)は、この問題を別のアングルから解決する。着想のカギは「記録済みの探索履歴を使って、仮想的に別の戦略をテストする」ことだ。
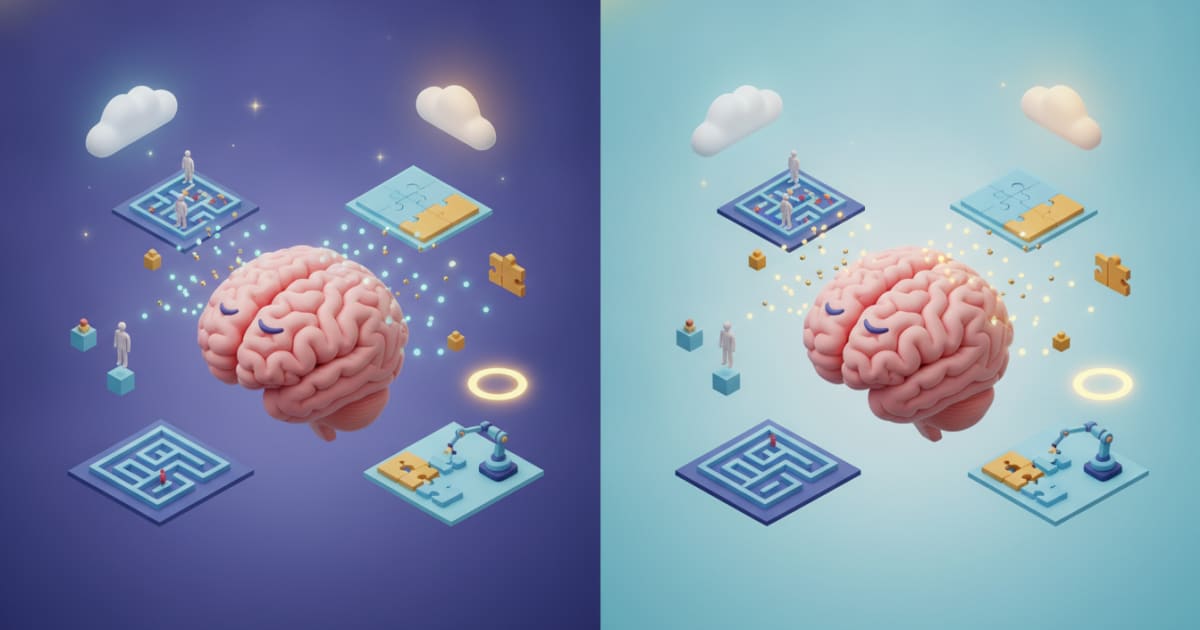
具体的には、エージェントが1回のライブ探索を行う際、試みた内容とその結果をすべてツリー構造で記録する。その後、実際にモデルや評価器を動かすことなく、記録済みの結果に対して何千もの代替戦略をシミュレーションできる。研究チームはこの過程を「ドリーミング(dreaming)」と呼ぶ。エージェントが過去の探索を夢の中で何度も再体験し、最適な戦略を選び出すイメージだ。
論文中ではこれを「初めて訪れた街で道に迷い、行き止まりを経験した後、その頭の中の地図を使えば、実際に歩き回らなくても別ルートを検討できる」という比喩で説明している。

▲ リプレイシミュレータの概念図。記録済みのツリーに対して複数の戦略を当てはめ、品質・コスト・レイテンシを軸に評価する。

▲ Dream-RSIの全体サイクル。ライブ実行は1回だけで、残りのループはシミュレーション上で完結する。
この「ライブ探索→ドリーミング→戦略更新」のループが繰り返される。重要なのは、変わるのは探索戦略だけであり、ソリューションを生成するモデル自体には手を加えない点だ。
数字で見る効果:試行550回→317回、競合比160倍の効率
研究チームはGemini 3.1 ProとGemini 3.7 Flashを使い、3つの分野・8つのタスクでDream-RSIを検証した。
※編集部の考察:「Gemini 3.1 Pro」は本稿執筆時点(2026年9月)で元記事に記載されたモデル名をそのまま引用している。名称に疑義がある場合は元記事および公式発表を参照されたい。
ゲノミクスや金融で使われる統計計算の高速プログラムを書くタスクでは、Gemini 3.1 Proを使った場合、平均実行時間が3,587ミリ秒から2,931ミリ秒に短縮され、試行回数は550回から317回に減少した。さらに比較対象となった既存手法SimpleTESが51,200回の実行を必要としたのに対し、Dream-RSIは317回で同等以上の結果を出した。
GPUカーネル最適化タスクでは、2つのタスクで同じ性能を最大2.43倍少ない実行回数で達成し、別の2つのタスクでは同じ予算内で最大2.09倍の性能向上を実現した。

▲ GPUカーネル4タスクにおける実行回数対性能の比較。Dream-RSI(実線)が固定探索(破線)を上回るペースで改善していく。
また、学習された戦略の振る舞いも興味深い。性能が向上している間は試行回数を絞り込み、改善が頭打ちになると探索量を自動的に増やす。その結果として再びスコアが伸びる、という動的な調整が確認された。

▲ ConvDivタスクにおける動的な探索量調整の様子。改善が停滞すると自動的に探索を広げ、突破口を探る挙動が確認できる。
「明示的な指示」は逆効果になる場合もある
研究チームはリプレイデータの別の使い方として、探索履歴を要約してエージェントへの指示として与える方式も検証した。しかし、あるGPUタスクでは指示あり版が指示なし版を下回る結果となった。
指示が具体的すぎると探索空間が狭まり、より広い範囲のアプローチが試されなくなる可能性があると研究チームは指摘している。これはGoogle Researchが別途提案したWikiSkill(失敗・成功をWikiに記録して再利用可能な指示に変換する手法)との興味深い対比でもある。WikiSkillが「言語化された知識の蓄積」を重視するのに対し、Dream-RSIは「戦略の暗黙的な最適化」を優先する設計思想といえる。
再帰的自己改善(RSI)の競合研究との位置づけ
再帰的自己改善(RSI:Recursive Self-Improvement)は近年急速に注目を集めており、AnthropicのCEO Dario Amodei氏がAI研究のペースへの警戒を発言した背景の一つでもある。
Dream-RSIはこの分野のいくつかの関連研究と比較できる。
- **AlphaEvolve**(Google DeepMind、2025年):Gemini Flashがコードを生成し、Gemini Proが評価、進化的アルゴリズムが選択する枠組み。Dream-RSIはこの一段上で探索戦略そのものを最適化する。
- **AutoTTS**:コーディングエージェントが模擬環境でアルゴリズムを探索し、推論パスの開始・展開・打ち切りを制御する手法。
- Hyperagents(Meta):エージェント自身が自己改善のメカニズムを書き換えられる、より踏み込んだアプローチ。
コードと詳細はGitHubで公開されている。
詳細はGoogle Deepmind's Dream-RSI helps AI agents improve by "dreaming" about past attemptsを参照していただきたい。