11月20日、OpenAIが「Can AI help scientists identify promising drug candidates?」と題した記事を公開した。AIモデルが創薬の中核的な推論タスクをどの程度こなせるかを測る新ベンチマーク「MedChemBench」の公開について詳しく紹介されている。
MedChemBenchとは何か
MedChemBenchは、医薬品化学(medicinal chemistry:薬として機能する分子の設計・最適化を扱う化学分野)の研究から抽出した99問の問題でAIモデルを評価するベンチマークだ。117本の論文・特許と761種の分子構造を元に構築されており、モデルには研究プログラムのある時点で得られる情報(生物学的ターゲット、研究目標、既存の化合物データ、実験結果の一部)が与えられる。
分子構造の表現には、原子と結合を文字列で符号化するSMILES記法やIUPAC名といった形式が化学情報学では広く使われており、AIモデルがこれらの表記を正確に解釈できるかもベンチマークの評価対象となっている。ベンチマークの詳細はOpenAIが公開予定のプレプリント(arXivでの公開が告知されている)でも共有される予定だ。
評価は以下の4カテゴリに分かれる:
- 分子構造の再構築:図や化学基から原子結合・立体化学を正確に組み立てられるか
- 科学的推論:供与された証拠をもとに、化合物選択の理由などを説明できるか
- ランキング・選択:要件に合った化合物を正しく選べるか
- 物性予測:測定値・計算値の数値カテゴリと一致する予測ができるか
なお、MedChemBenchは創薬AIの能力評価を目的としたベンチマークとして新たに設計されたものであり、分子特性予測の汎用ベンチマークとして広く参照されてきたMoleculeNetとは評価の切り口や問題構成が異なる。MoleculeNetが分子の物性予測に特化しているのに対し、MedChemBenchは実際の創薬研究の文脈に即した複合的な推論能力を問う点が特徴だ。
創薬AIが直面するコアな難しさ
創薬において一番厄介なのは、ある物性を改善すると別の物性が悪化するトレードオフだ。例えば「標的タンパク質への結合力が強い化合物」が「体内での吸収率が低い」「肝臓で速く分解される」という問題を抱えることは珍しくない。
MedChemBenchはこの現実を問題に組み込んでいる。例えばPRMT5の阻害剤に関する問題では、3つの関連化合物について以下を同時に予測させる:
- 細胞内でのPRMT5阻害の強さ
- 細胞膜透過性
- 肝酵素による分解速度
PRMT5(Protein Arginine Methyltransferase 5)はアルギニンのメチル化を触媒する酵素であり、複数のがん種で過剰発現が確認されていることから、がん創薬ターゲットとして近年注目を集めているタンパク質だ。正解データは実験結果から来ており、化合物23は細胞内阻害が強く、化合物24は透過性と代謝安定性で優位、というトレードオフが実際に存在する。モデルは構造と実験証拠を接続してこの挙動を予測しなければならない。
分子構造の再構築——モデル間の差が最も出た領域
推論の前提として、モデルはまず「どの分子を扱っているか」を正しく認識する必要がある。化学構造式には原子結合・環構造・立体化学が符号化されており、これを正確に読み取れるかがテストされる。
記事中の具体例では、中央構造と2つの置換基から18員環を持つ分子を組み立てる問題が示された。結果は以下の通りだ:
- GPT-6 Astra(xhigh設定):10回中10回正解
- GPT-5.6 Sol:全滅。15員環(小さい環)を生成
- GPT-5.6 Luna:全滅。分子を2つの断片に分割してしまった
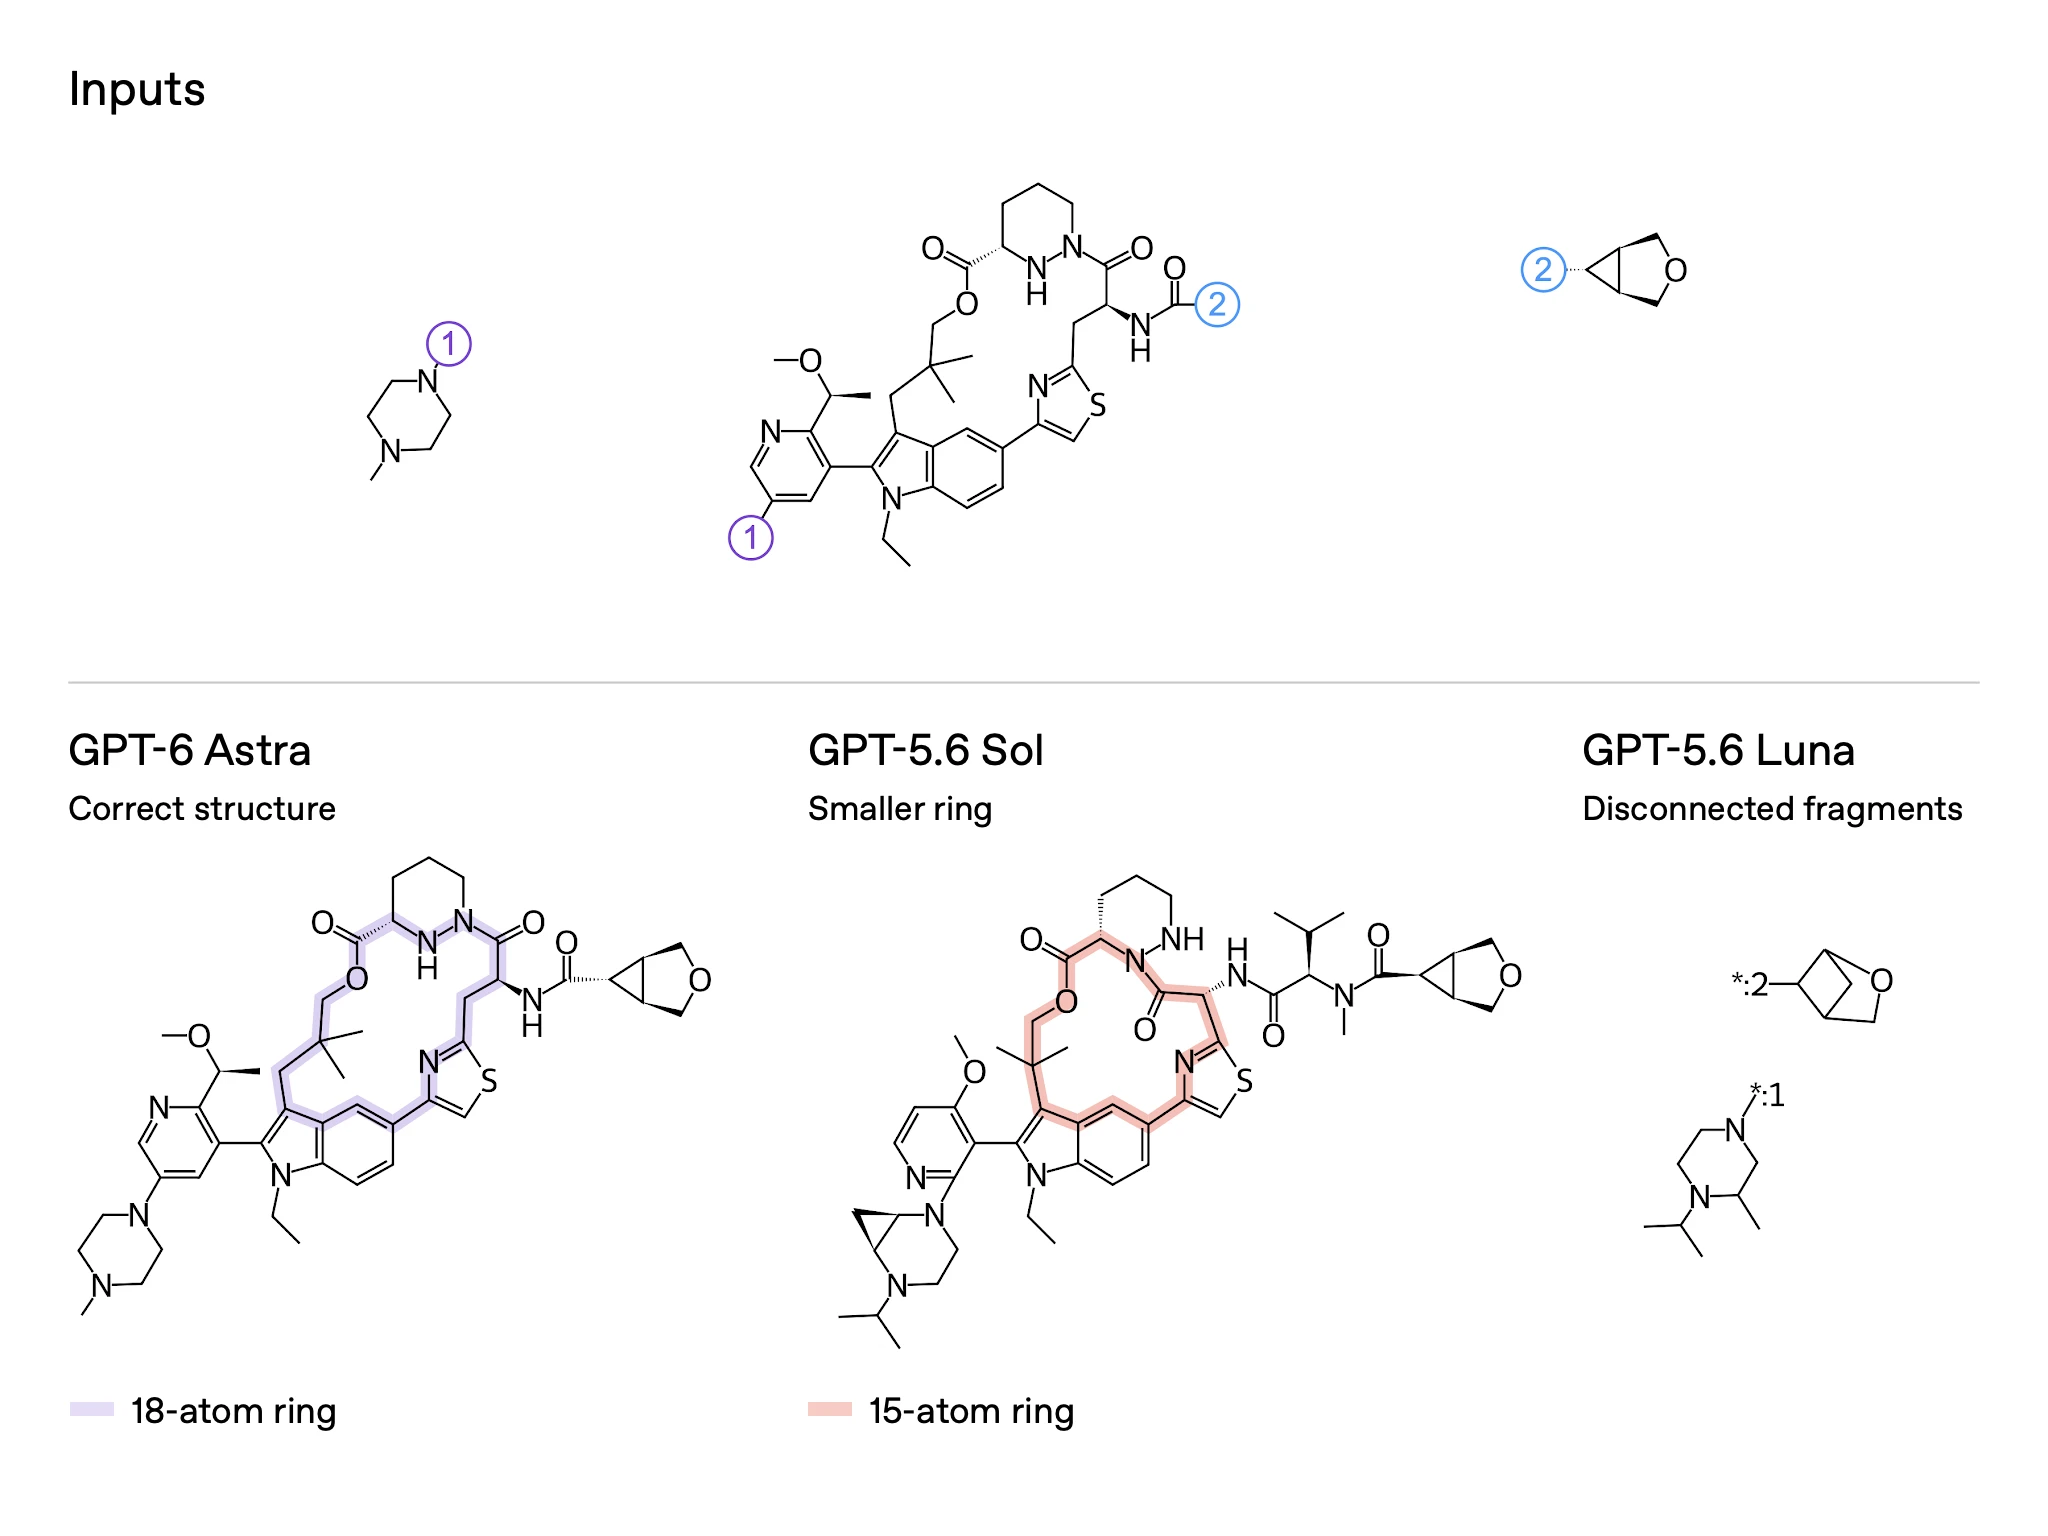
環のサイズが変わると、それはもう別の分子だ。推論の前段階でこのミスが発生すると、以降の物性予測はすべて無意味になる。モデルが返すSMILES文字列の環原子数が1つ違うだけで、物理的・生物学的性質はまったく異なるものになりうる。この領域でのモデル間差は、ベンチマーク全体を通じて最も顕著だった。
モデル別スコア
11モデルを複数の推論努力設定で評価した結果、xhigh設定での全体スコアは以下の通りだ:
| モデル | xhigh スコア |
|---|---|
| GPT-6.2 Astra | 84.5% |
| GPT-6 Astra | 83.3% |
| GPT-6.1 Sol | 82.0% |
| GPT-5.6 Sol | 58.2% |
※上記モデル名は元記事の表記をそのまま転記している。公式モデルページ等での正式名称は元記事および関連発表を参照のこと。
GPT-6 Astraはmax effort設定で83.8%。構造再構築では95.4%のクレジットを獲得した一方、化合物選択・数値予測は約半分にとどまり、まだ大きな改善余地がある。推論設定を高めるとスコアは上がるが、モデル間の差は縮まらなかった。上位モデルと下位モデルの間には26ポイント以上の開きがあり、モデルの世代・アーキテクチャの差がそのままベンチマーク成績に反映された形だ。
注意すべき限界
OpenAI自身が記事内で明示しているが、この結果は「AIが新薬を発見できる」「実験室での意思決定を改善できる」ことを証明するものではない。各問題への回答はツールなし・フィードバックなし・1回限りの単発推論であり、訓練データに元論文が含まれていた可能性も排除できない。あくまで「過去の実験データからの推論能力」の評価だ。
また、実際の創薬プロセスでは、ここで評価された個別タスクに加えて、実験設計・仮説立案・結果解釈のサイクルが繰り返される。MedChemBenchのスコアはその一断面を切り取ったものに過ぎない点は念頭に置くべきだろう。
まとめ
MedChemBenchは、AIが創薬のどの推論ステップをこなせて、どこで詰まるかを構造化して可視化する。特に「分子構造の正確な認識」と「複数物性の同時予測」というギャップが数値として浮き彫りになった点は、今後の研究方向を絞るうえで参考になる。ベンチマーク問題セットはOpenAIから公開される予定であり、外部研究者による再現評価や追試も期待される。
詳細はCan AI help scientists identify promising drug candidates?を参照していただきたい。