8月25日、Databricksが「How Databricks Uses AI to Accelerate Incident Investigation」と題した記事を公開した。この記事では、LLMを活用したAIエージェント「AI SRE」によってインシデント調査を自動化した実践事例について詳しく紹介されている。
問題の本質は「ツール不足」ではなく「シグナルの接続」だった
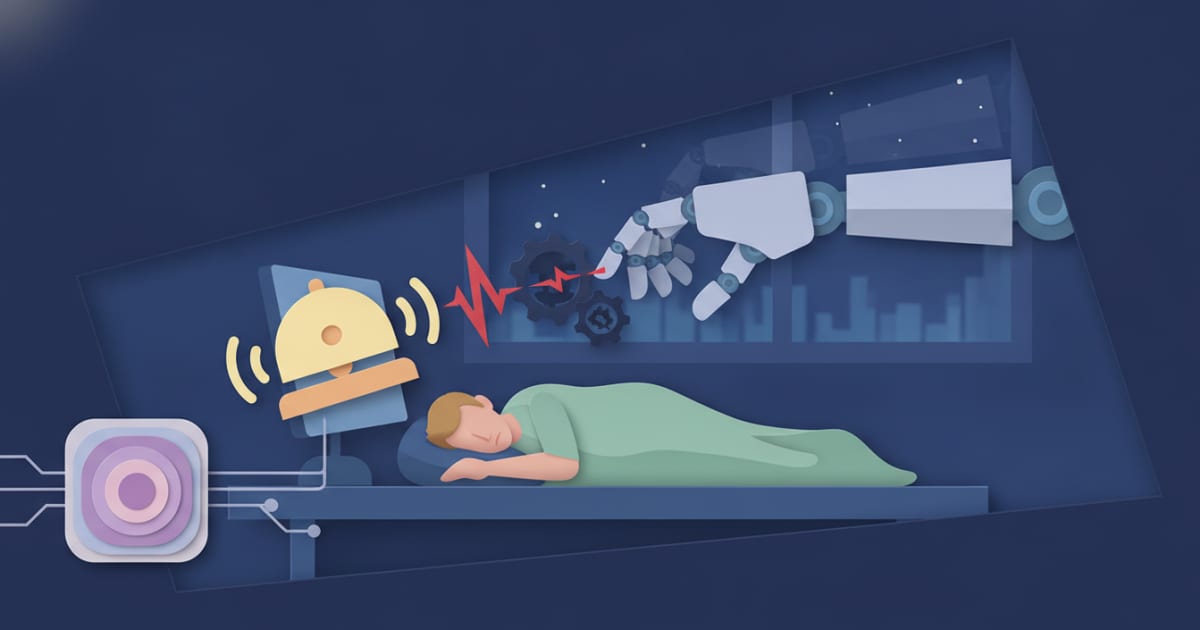
Databricksは現在、1,500以上のKubernetesクラスター、70以上のリージョン、3つのクラウドにまたがって数百のマイクロサービスを運用している。これだけの規模になると、深夜2時のオンコール対応は過酷だ。
記事の核心はここにある。ダッシュボード、ログ、デプロイ履歴、フィーチャーフラグ、インフラ状態——ツールは揃っていた。問題は、それらのシグナルを「つなぎ合わせる作業」が全てオンコールエンジニアの頭の中にしか存在しなかったことだ。
Databricksのチームがエンジニアへのインタビューやポストモーテムの分析を重ねた結果、一貫して3つのパターンが浮かび上がった:
- 調査時間の60〜80%はコンテキスト収集に費やされている。 根本原因の特定自体は、正しいシグナルが揃えば速い。問題は「揃えるまで」だ。(※元記事ではこの割合をコンテキスト収集フェーズに限定した数値として示している)
- ノウハウが特定の専門家に集中している。 そのエキスパートが不在のとき、調査は急激に遅くなる。ランブック(手順書)は存在するが陳腐化しており、新しい障害モードには対応できない。
- プラットフォーム障害がアプリ層から見えない。 クラウドやネットワークの大規模障害が原因でも、アプリ層を調べるエンジニアはそれに気づかず、的外れな仮説を追いかけることになる。
AI SREの仕組み:3トラックの並列調査
この分析から生まれたのがAI SREだ。インシデントが発火した瞬間、エンジニアがラップトップを開く前から動き始める。
起動直後、AI SREは3つの調査トラックを並列実行する:
1. プラットフォームヘルスチェック
クラウドインフラ、ネットワーク、上流依存サービス(DB、メッセージキュー等)の状態を確認する。これだけで「アプリのバグを30分追っていたら実はインフラ障害だった」というケースを早期に排除できる。
2. サービスレベル分析
対象サービスのログ・メトリクス・トレースを収集し、最近のデプロイや設定変更と照合する。「CPUが高い」ではなく「午前2時47分にCPUが3倍に急騰し、バッチサイズを変更したデプロイと時刻が一致する」という粒度で異常を説明する。
3. ランブック実行(チーム固有の専門知識を反映)
各チームは自分たちの既存ランブックをアジェンティック・ランブックとして変換できる。コードベース、オブザーバビリティデータ、過去のインシデント履歴を参照しながら、ドメインエキスパートが実施するような手順を自動的に実行する。
エンジニアがSlackのアラートを確認する頃には、「何が壊れたか・何が変わったか・ランブックでは何を確認すべきか」が一画面に集約されている。
アーキテクチャ:4層に分けた理由
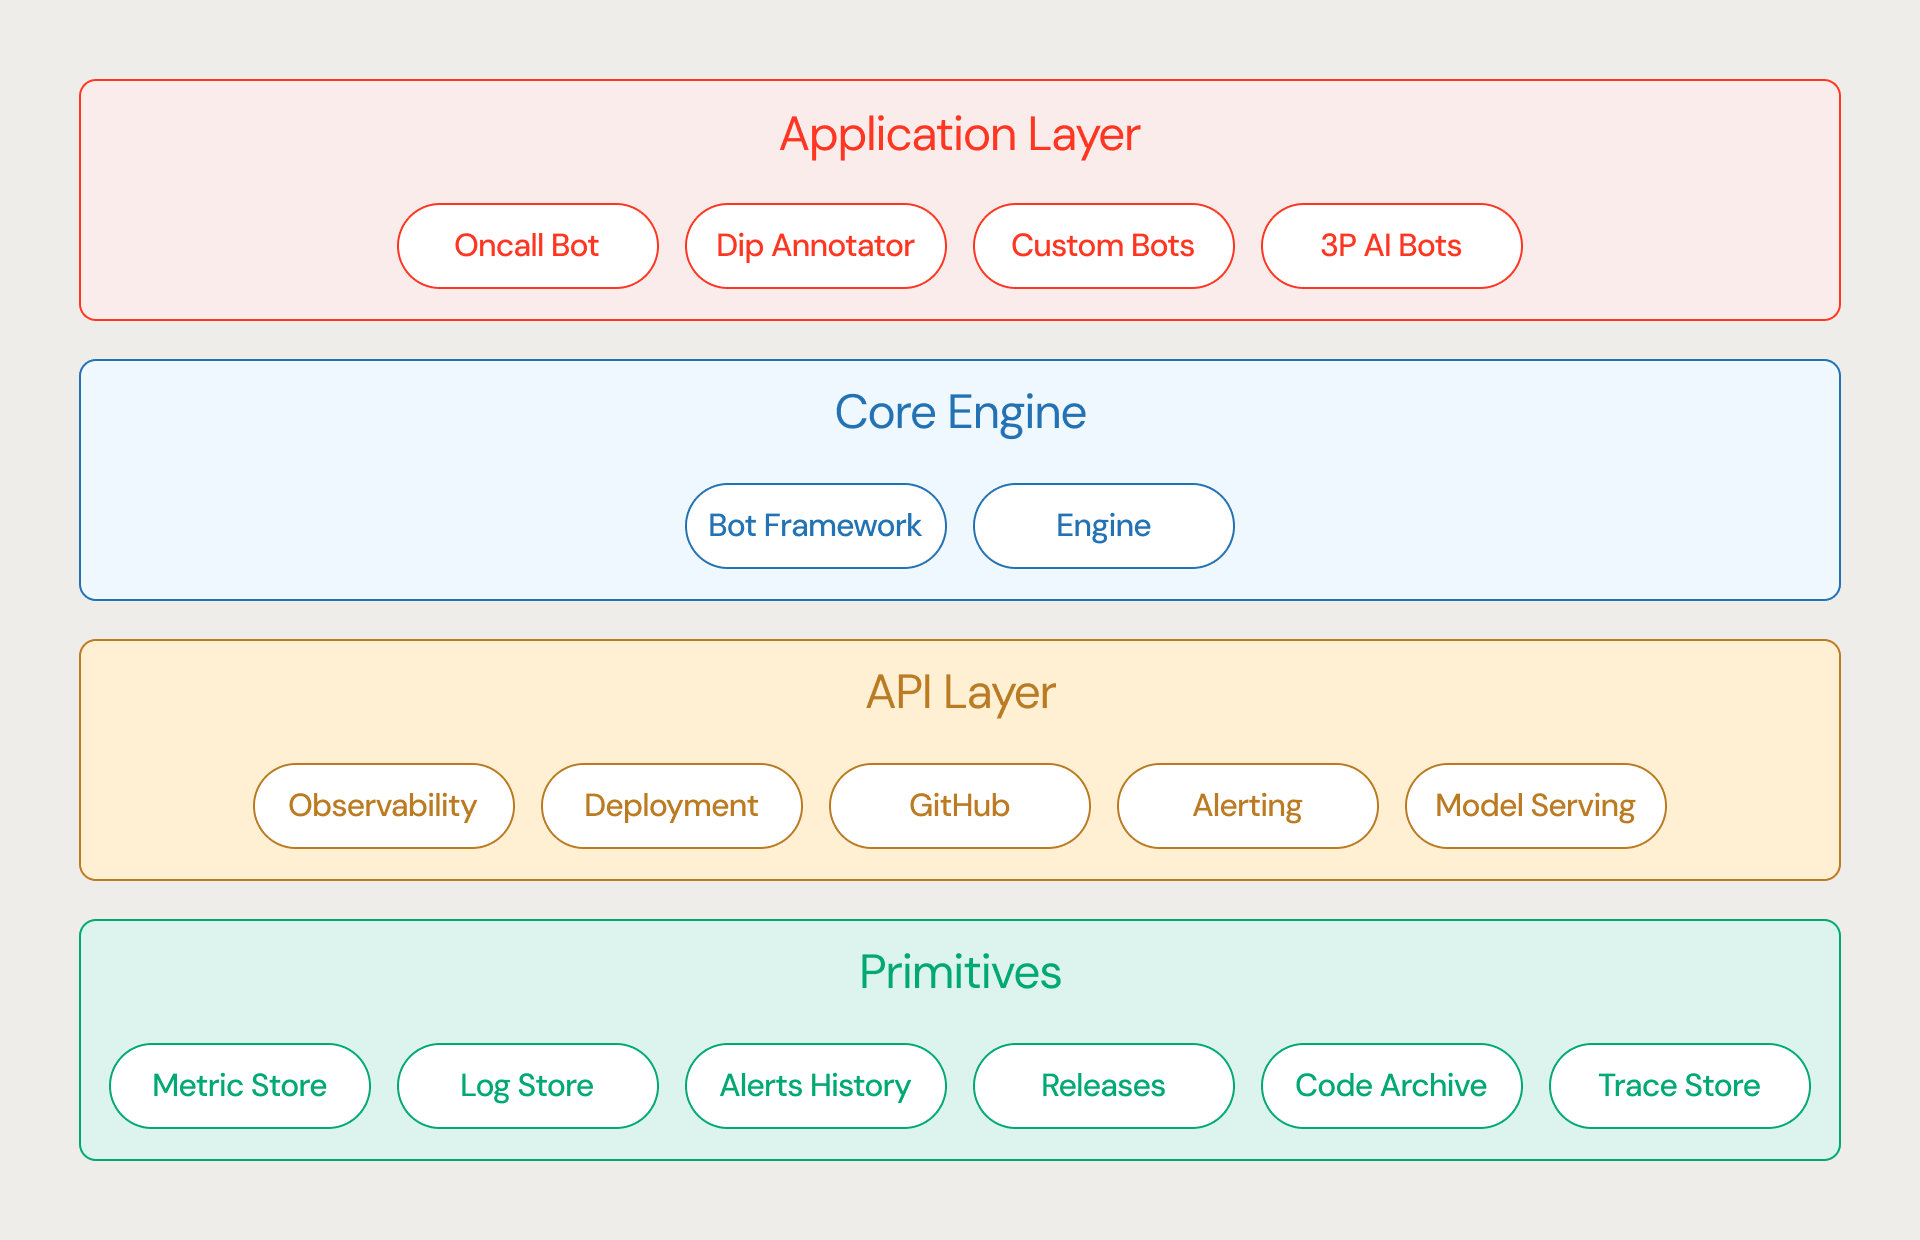
AI SREは4層構造で設計されている:
- Primitives層:メトリクス、アラート、ログ、リリース情報などの生データ。既存システムをそのまま「信頼できる情報源」として扱う。
- API層:Observability API、Deployment API、Alerts APIとして統一インターフェースを提供。認証・レート制限・データ正規化を担う。「生のインフラ」を「デバッグ可能なインフラ」に変換する層だ。
- Core Engine:並列実行、結果の相関付け、LLMによる統合を担うオーケストレーション層。Databricks内製のボットも、外部チームが構築するカスタムボットも同じ基盤で動く。
- Application層:実際のトリアージボットやサードパーティツールが動く層。
この分離により、データアクセスとオーケストレーションを独立して改善できる。また、API層を再設計した背景として記事が指摘している点は興味深い。エージェントは人間とは異なるクエリパターンを持つ——エンドポイントをバースト的に叩き、並列でチェックを走らせ、疲れを知らない。人間向けに設計されたAPIをそのまま開放すると、監視・アラート基盤自体をダウンさせるリスクがある。
信頼を得るための3原則
LLM駆動のエージェントをインシデント対応に使うには、「信頼性」が最大の課題になる。Databricksが採用した原則は明快だ:
- オープンな推論より決定論的チェックを先に走らせる。 LLMはあくまで結果を説明・統合する役割で、データ収集の判断をモデルに委ねない。
- 根拠をトレース可能にする。 AI SREが示す全ての結論は、具体的なメトリクス・ログ行・デプロイ差分にリンクされる。監査できない推薦をオンコールエンジニアは信用しない——これは妥協しなかった点として明記されている。
- グレースフルデグラデーション。 確信を持って根本原因を特定できない場合、AI SREはそれを明示した上で収集済みの証拠を提示する。
導入効果
現在AI SREはDatabricks社内の150以上のチームで稼働しており、週間アクティブユーザー250人以上が1日2,000件以上の調査を実施している。元記事では調査あたりの時間短縮効果についても言及されているが、具体的な削減時間は定量的な数値として明示されていないため、ここでは規模感の数字にとどめる。
得られた教訓
記事が最後に挙げる3つの教訓は、同種のシステムを構築しようとするチームにとって参考になる:
- チームに専門知識のオーナーシップを持たせる。 中央集権的なエージェントが全チームのドメイン知識を抱えようとすると、必ず陳腐化する。アジェンティック・ランブックを各チームが所有・更新する構造にしたことで、プラットフォームはボトルネックにならずに拡張できた。
- モデルより先にコンテキスト層を作る。 プロンプトエンジニアリングより、エンジニアが実際にどう調査するかを観察する時間の方が長かった。その投資が「チャットボット」ではなく「コンテキストを組み立てるエージェント」という正しい設計につながった。
- エージェントへのガードレールは人間以上に重要。 上述のAPI層再設計がその具体例だ。
次のステップとして、調査フェーズを超えた「ガイド付き緩和措置」(診断だけでなく修正アクションの支援)と、過去インシデントのパターンを活用した予防的な問題検知への投資を予定しているという。
詳細はHow Databricks Uses AI to Accelerate Incident Investigationを参照していただきたい。