8月24日、Asif Razzaqが「Generalist AI Releases GEN-1.5: A Robot Foundation Model That Learns New Tasks From One 3–12 Second Demo」と題した記事を公開した。この記事では、Generalist AIが発表したロボット基盤モデル「GEN-1.5」が、わずか3〜12秒のデモ1本からロボットの新タスク学習を実現する仕組みについて詳しく紹介されている。
Generalist AIとは何者か
Generalist AIは、汎用ロボット基盤モデルの開発を掲げるスタートアップだ。ロボット基盤モデルの領域では、Physical Intelligenceのπ0やCohere出身研究者が立ち上げたOctoなどが知られているが、Generalist AIはその中でも「in-context学習によるゼロショット適応」を主軸に据えている点で独自のポジションを取る。同社はGEN-1.5を、家庭・倉庫・工場の3領域にまたがる実環境データを用いた8ヶ月以上の継続的な事前学習によって開発しており、現在は自社ロボットフリートとデータエンジン上で運用している。
勾配更新ゼロで59%の成功率——何が起きているのか
GEN-1.5の最大の特徴は、ファインチューニングも勾配更新も一切なしで新しいタスクを実行できる点だ。
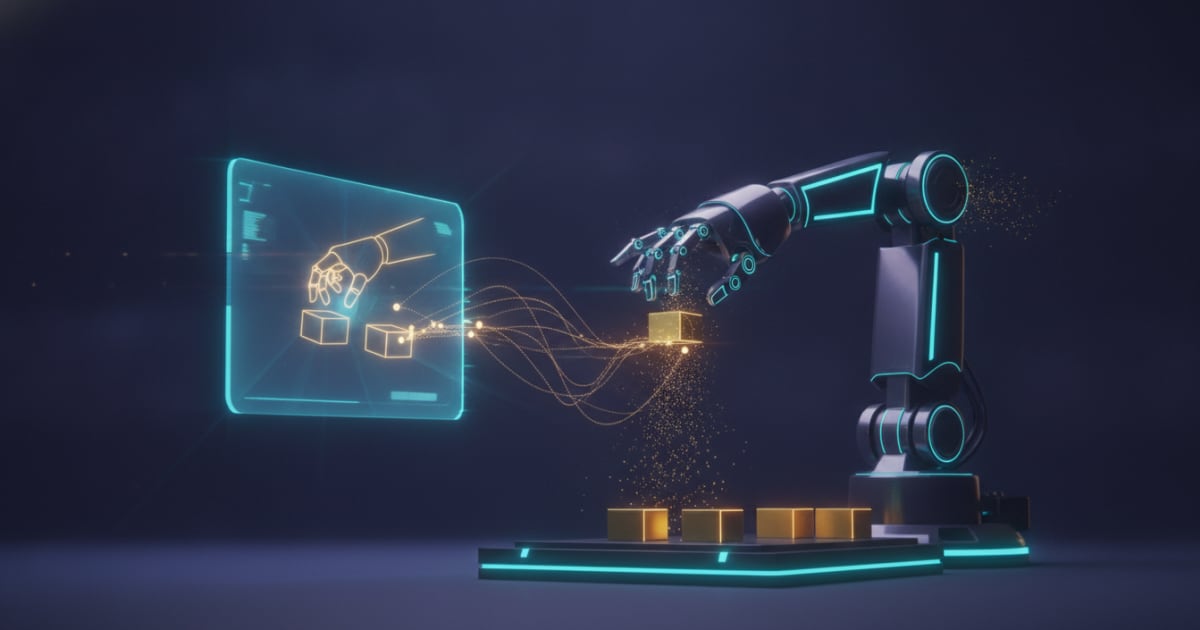
仕組みはシンプルだ。センサーストリームとアクション軌跡で構成された3〜12秒のセンサーモーター記録を、モデルが保持する30秒のコンテキストウィンドウにドラッグ&ドロップで挿入する。あとはモデルがそのままタスクを実行する。
Generalist AIはこの機構を「physical prompting(物理プロンプティング)」と呼んでいる。LLMにおけるin-contextプロンプティングのロボット版と考えると分かりやすい——テキストの代わりに、センサーとアクションの時系列データをプロンプトとして与える仕組みだ。
興味深いのは、この能力が意図的に設計されたものではないという点だ。アーキテクチャへの変更もなく、メタ学習ループも、in-context学習を促進する補助的な学習目標も設けていない。家庭・倉庫・工場で収集した物理インタラクションデータを使った8ヶ月以上の継続的な事前学習から自然発生した能力だという。GPT-3においてfew-shotプロンプティング能力がスケーリングから出現したのと同じ構図だ。
数字の中身
10種類の多様なマニピュレーションタスクで評価した結果は以下の通りだ。
| 条件 | 成功率 |
|---|---|
| one-shot in-contextのみ(勾配更新なし) | 59%(±10%) |
| 5分のデータで10ステップのみ微調整 | 83%(±9%) |
| 1分のデータで1ステップのみ微調整 | 66.5% |
この59%という数字は、同一モデルにプロンプトなしで同タスクを実行させた場合との比較ではなく、従来のロボットポリシー適応手法が要求する多大な学習コストを前提とした文脈で評価されている点に留意が必要だ。従来手法では一般に数万回の勾配ステップが必要とされてきたところ、GEN-1.5の10ステップ微調整ではモデルの重みの変化量が0.15%未満に留まる。Generalist AIはこれを「モデルがすでに持っている知識を再編成しているだけ」と解釈しており、test-time trainingの極端な低データ版として位置づけている。
3つの転移結果
元記事が特に挙げている転移学習の結果が興味深い。
合成汎化(Compositional generalization):独立して録画した2つのプロンプトをコンテキストに並べると、モデルはその間をつなぐ動作(再配置、把持し直し、エラー回復)を自律的に生成する。どちらのデモにも含まれていない動作だ。
ゼロショットのsim-to-real転移:シミュレーション環境で録画したデモが、実機ロボットへのプロンプトとして機能する。事前学習データにシミュレーションデータは一切含まれていないにもかかわらずだ。
人間からロボットへの模倣:人間が自分の手でロボットのカメラの前でデモを行い、モデルがロボットの手でそれを再現する。
また、軽微な微調整後の汎化として、「ブロックをボウルに掃き入れる」タスクを5分学習したモデルが、バナナを即席のブラシとして使ったり、ちりとりでブロックを持ち上げてダンプしたりする動作を自発的に生成したことも報告されている。
現時点での位置づけ
現時点では研究リリースであり、デプロイ可能なプロダクトではない。 公開された重みもAPIも存在せず、利用には直接パートナーシップの締結が必要だ。GEN-1.5はGeneralist AI自身のロボットフリートとデータエンジン上で動作している。
評価対象のタスクはいずれも比較的単純かつ短い時間軸のものであり、Generalist AI自身もその点を明示している。ただし、one-shotによる物理スキル学習がスケールから出現した例として、同社が把握する限り初のモデルだという主張は注目に値する。
詳細はGeneralist AI Releases GEN-1.5: A Robot Foundation Model That Learns New Tasks From One 3–12 Second Demoを参照していただきたい。