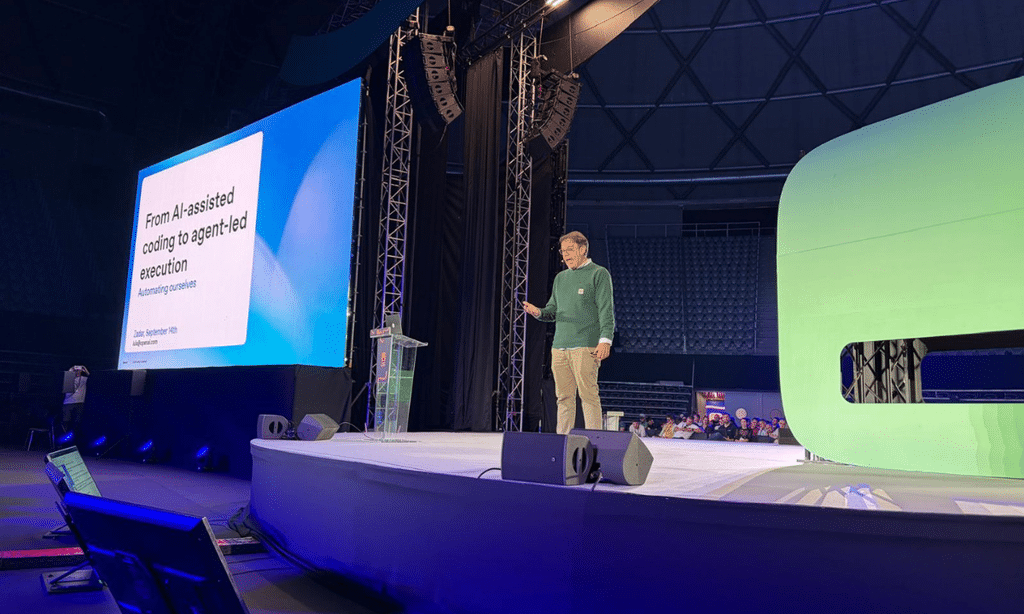
9月14日、Shift Magazineが「OpenAI Says the Real Work in AI Coding Is Building the System Around It」と題した記事を公開した。この記事では、OpenAIのForward Deployed EngineerであるLuis Velascoが提唱する「AIコーディングの本質はエージェントを支える周辺システムの設計にある」という考え方について詳しく紹介されている。
AIエージェントが実務に浸透するにつれ、「何を作るか」よりも「エージェントが正しく動くための環境をいかに整えるか」がエンジニアの競争力を左右するという議論が活発化している。OpenAIやAnthropicをはじめとする各社がエージェント関連の機能・APIを相次いで発表するなかで、Velascoの主張はその潮流を実務レベルで具体化したものとして注目に値する。
「メタソフトウェアエンジニアリング」という新しい領域
OpenAIのForward Deployed Engineer(FDE)であるLuis Velascoは、エンジニアリングが新たな段階に入りつつあると述べる。FDEとは、顧客の現場に深く入り込み、AIを実業務に組み込むための技術支援を担う職種だ。製品開発側とユーザー側の橋渡し役として、実装の最前線に立つ。
そのVelascoが提唱するのがメタソフトウェアエンジニアリング——AIエージェントそのものを作るのではなく、エージェントが正しく動くための周辺システムを設計することを指す。
コンテキスト、ツール、スキル、制約、評価の仕組み。これらをエージェントに与えるシステムを構築することが、これからのエンジニアの主な仕事になるというのがVelascoの主張だ。
最も難しいのは「コンテキストの再現」
コードベースの自動化は比較的やりやすい。構造が明確で、コンパイルやテストで結果の良否を判断しやすいからだ。しかしビジネスワークフローはもっと厄介だとVelascoは言う。
ビジネスワークフローでは、コンテキストが人やシステムに断片的に散らばっている。Slackのメッセージがある決定の背景を説明し、レガシーシステムがデータの状態を保持し、熟練の同僚だけが誰も書き残さなかった部分を知っている。自動化しようとしている作業は、そのすべてに依存している。
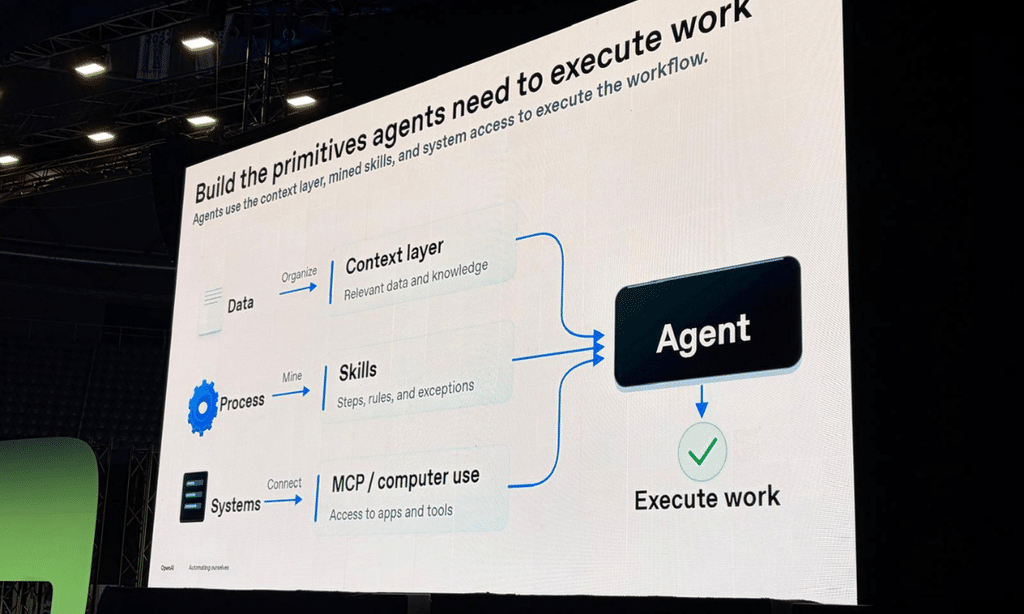
エージェントが仕事をこなすには、エンジニアがまずその仕事が行われるコンテキストを再構築しなければならない。Velascoはこれを3つの要素に分類する:
- データ:意思決定に必要な情報とドメイン知識
- プロセス:ルール、例外、タイムライン
- システム:適切な権限を持ってアクセス可能なアプリやAPI
実例として示された保険金請求のワークフローでは、エージェントがメールと添付ファイルを読み込み、複数のアプリを横断して情報を確認し、請求を検証して示談金を算出し、返答を用意するまでを22秒で完了した。従来は20〜30分かかっていた処理だ。
スケールすると別の問題が生まれる
1つのエージェントが1つのワークフローを完了させることはできた。だがスケール時に本当の課題が現れる。
エージェントが並列で動き始めると、ワークフローが互いに依存し合い、あるエージェントの出力が別のエージェントの入力になる。Velascoはこう説明する。
これは、コンテキストを共有するエージェントとサブエージェントの構成か、エージェントが共有状態を読み書きできる独立した環境で対処できる。その状態があることで、どこまで完了したかを把握し、次に何をすべきかを判断できる。
必要になるのはキュー、ワーカープロセス、チェックポイント、成果物ストア——クラッシュから回復でき、同じタスクを二重実行しない耐久性のある実行環境だ。
さらに大規模な例として、512エージェントを使ったCPU設計の実験が紹介されている。元記事によればこれはOpenAI社内での実験事例として紹介されたものだ。キャンペーンコントローラーが目標と予算を各CPUドメインに割り振り、バグ候補を探すエージェント、その結果に異議を唱えるクリティックエージェント、再現検証を行うエージェントがそれぞれ役割を担った。4日間の実行で約1.4テラバイトのデータを処理し、問題が本番環境に到達する前に検証エンジニアへ共有できるエビデンスを生成した。
モデルを変えなくてもシステムは賢くなる
Velascoのアプローチで特に実務エンジニアに刺さるのが、この点だ。モデル自体を更新しなくても、周辺システムを改善することで全体の性能を上げられるという考え方である。
ベテラン社員は入社時と基本的な知性は変わらないかもしれないが、何年もの経験を経て、システムのこと、よくある失敗パターン、細かなコツを知っている。それが彼らをより有能にしている。
エージェントにとって、その「経験」はモデルの周辺システムに蓄積される。成功した実行はどの挙動を強化すべきかを示し、失敗は改善点を示し、人間による修正はエージェントのスキルのギャップを明らかにする。
具体例として示された税務申告エージェントでは、初回は必要フィールドの約**25%しか埋められなかったが、6週間の繰り返し実行・評価・スキル更新を経て約90%**まで到達した。
エンジニアの役割は消えないが、変わる
より多くの実行がエージェントに委譲されるにつれ、エンジニアはシステムの設計と改善に多くの時間を使うようになる。ただし、エンジニアリング自体がなくなるわけではない。目標の設定、トレードオフの判断、人間の介入が必要な箇所の決定は引き続き人間の仕事だ。
Velascoはこう締めくくる。
私たちが作りうる最も価値の高いソフトウェアの成果物は、コードベースそのものではなく、コードを体系的かつ再現可能な形で生み出せる「意図・制約・評価のシステム」かもしれない。
ソフトウェアエンジニアリングの次の章は、コードを囲むシステムを作ることだ。
詳細はOpenAI Says the Real Work in AI Coding Is Building the System Around Itを参照していただきたい。