9月16日、AMD ROCmブログが「DFlash Speculative Decoding on AMD Instinct MI355X: Up to 5× Faster Qwen3.5 Inference」と題した記事を公開した。AMD Instinct MI355X上でブロック拡散型の投機的デコード手法「DFlash」をvLLM経由で動作させ、Qwen3.5推論を最大5倍高速化した検証結果を詳しく紹介している。
なぜ今、投機的デコードなのか
LLM推論の単一リクエストレイテンシは、計算量ではなくウェイトの転送速度(メモリ帯域)に律速される。1トークン生成するたびに大規模モデルの全重みをGPUメモリから読み出す必要があるためだ。
**投機的デコード(Speculative Decoding)**はこのボトルネックを回避する手法で、小さな「ドラフトモデル」が複数トークンを先読み提案し、大きな「ターゲットモデル」がそれを1回の並列パスで検証・採択する。複数トークンをまとめて確定できれば、ターゲットモデルの検証コストを分散できる。
ただし従来のドラフト手法(EAGLE系や、Qwen3.5に内蔵されているMTP: Multi-Token Prediction)は自己回帰型——トークンを1つずつ逐次生成するため、投機深度を深くするほどドラフトコストが線形に増大する。結果として投機ブロックを大きくできず、高速化の天井が低かった。
DFlashの核心:ブロック拡散+KVインジェクション
**DFlash**はドラフトの生成方式を根本から変える。
- ブロック拡散ドラフト: マスクされたk個のトークン列を一度の順伝播でまとめてデノイズする。ブロックサイズkを増やしてもドラフトのコストはほぼ変わらない——これが自己回帰型との決定的な違いだ。
- KVインジェクション: コンテキストを再エンコードする代わりに、ターゲットモデルの隠れ表現をドラフトモデルのKVキャッシュに直接書き込む。ドラフトモデルはターゲットのリッチな特徴量を再計算なしに活用できる。
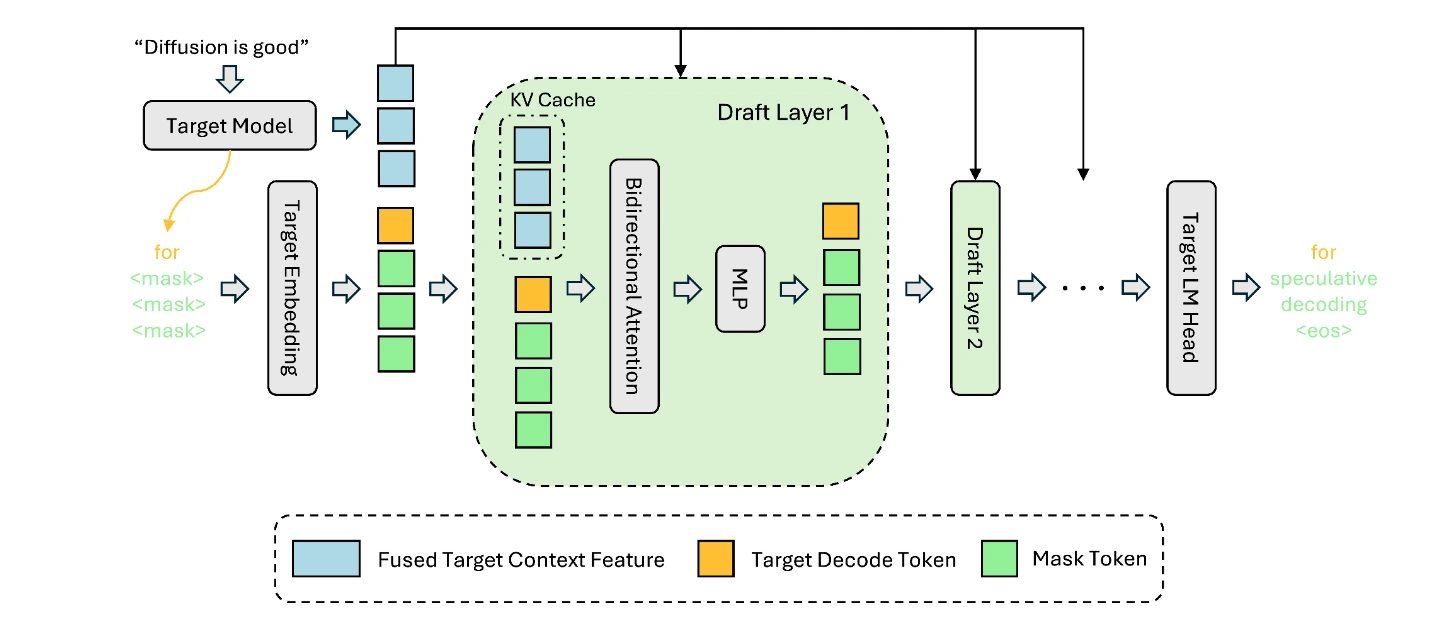
この組み合わせにより、ブロックサイズ16(=1回の検証で最大16トークンを提案)でもドラフトコストを抑えられる。MTPのスループットがブロックサイズ8以降で頭打ち(約245 tok/s)になるのに対し、DFlashはblock=16で396 tok/sまで伸び続ける(Qwen3.5-27B・HumanEval・concurrency 1)。
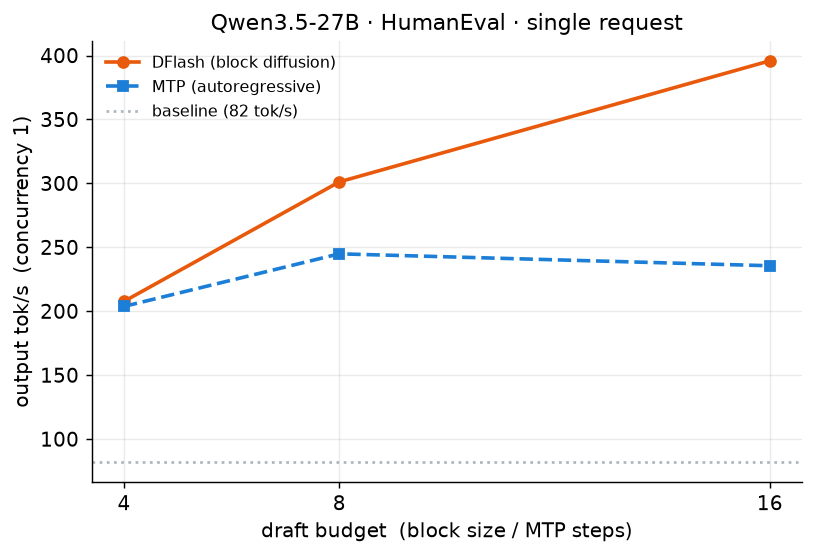
実測結果:最大5.02倍
テスト環境
| コンポーネント | バージョン/設定 |
|---|---|
| ハードウェア | AMD Instinct MI355X(シングルGPU、gfx950)、TP=1 |
| vLLM | 0.22.1rc1.dev43+g8c3cc98cf(ROCmビルド) |
| ROCm | 7.2.3 |
| PyTorch | 2.10.0 |
| 精度 | bfloat16、mxfp4(ターゲット重みのみ、AMDの量子化ツールQuarkで量子化) |
| ターゲットモデル | Qwen/Qwen3.5-27B(dense)、Qwen/Qwen3.5-35B-A3B(MoE) |
| ドラフトモデル | z-lab/Qwen3.5-27B-DFlash、z-lab/Qwen3.5-35B-A3B-DFlash |
| ワークロード | GSM8K、MATH500、HumanEval、MBPP、MT-Bench |
| 同時リクエスト数 | 1および32 |
スループット・スピードアップ
concurrency=1(シングルリクエスト)の条件では、DFlash block=16がすべての27Bワークロードでベストスコアを記録した。
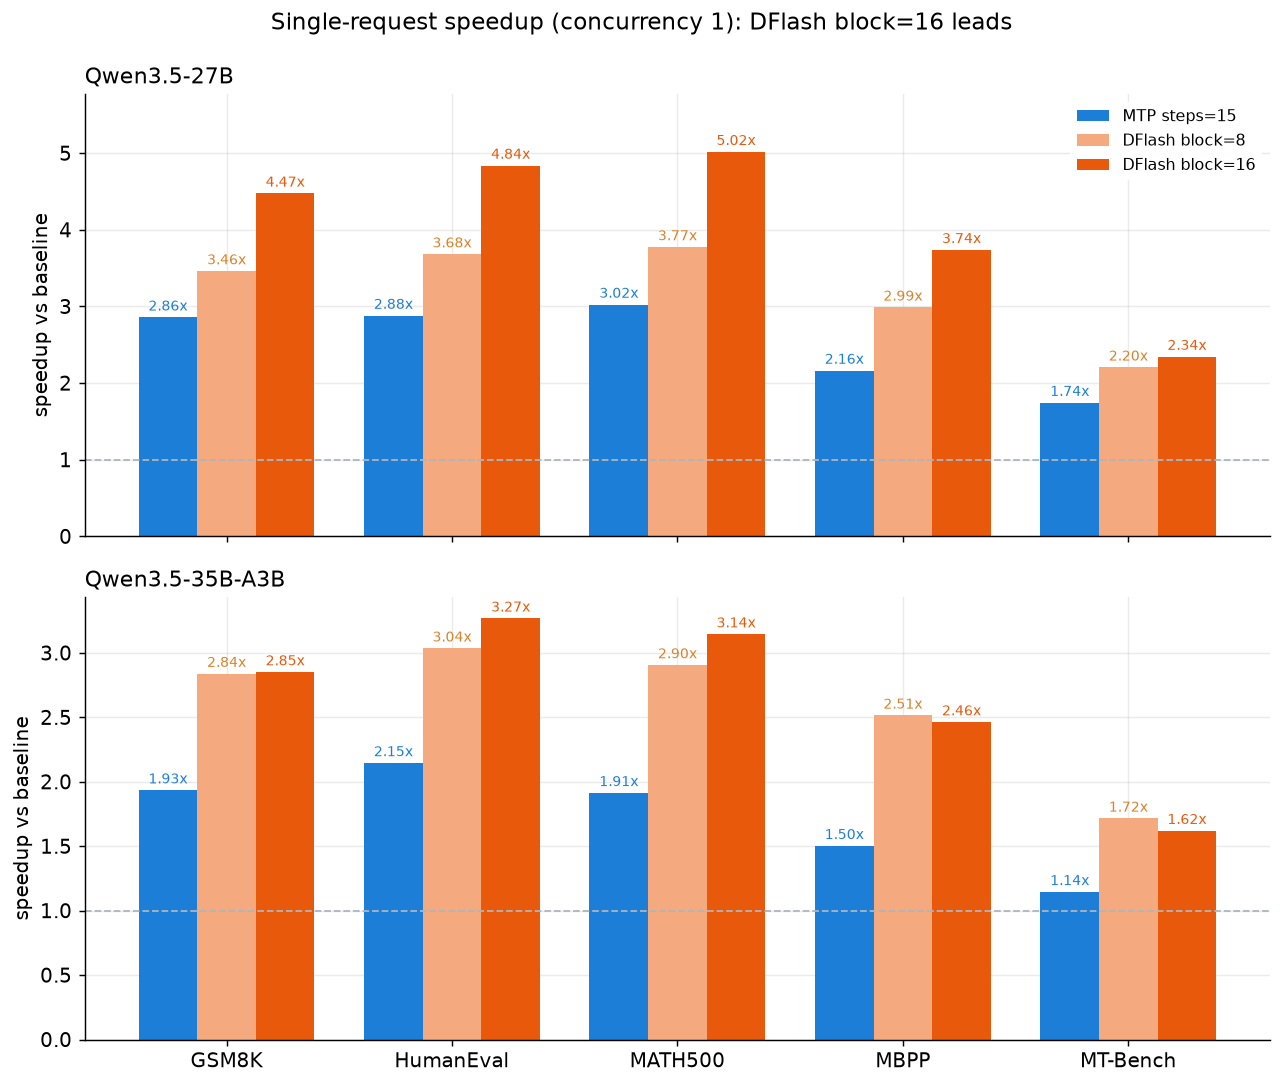
MoEアーキテクチャを採用するQwen3.5-35B-A3Bについては、denseの27Bとは異なるスピードアップ特性が確認されている。MoEモデルはアクティブパラメータ数が少ない(35Bのうち実効3B相当)ため、デコード時のメモリ帯域プレッシャーがdenseモデルと異なる。元記事の図表では35B-A3Bにおいても複数ワークロードでスピードアップが確認されているが、具体的な倍率の読み取りは元記事のグラフを参照されたい。
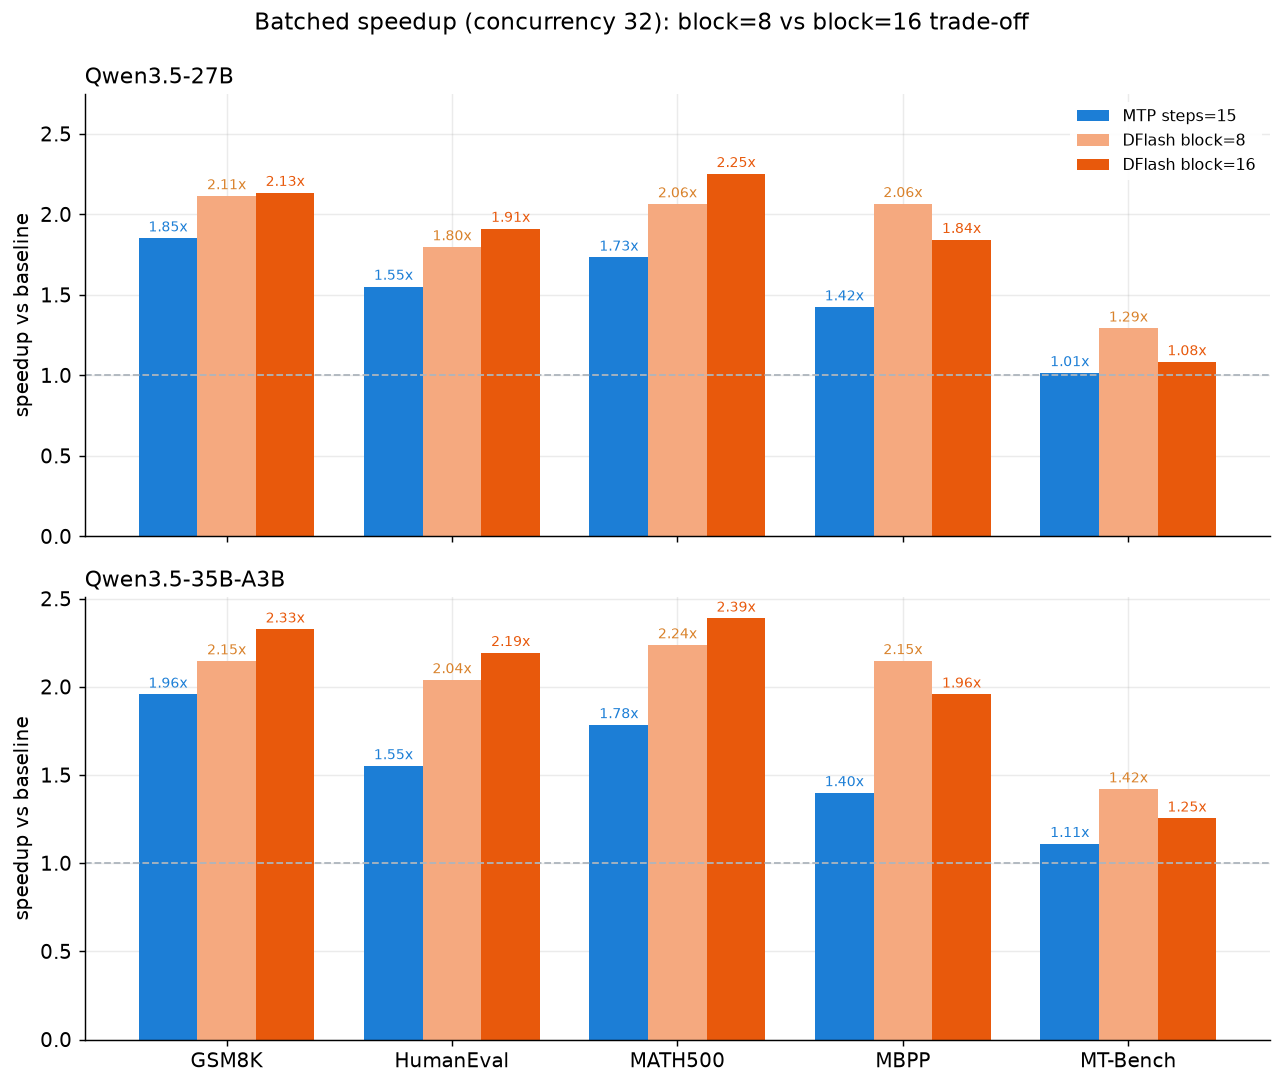
concurrency=32のバッチ処理では、GSM8K・HumanEval・MATH500ではDFlash block=16が依然リードするが、MBPP・MT-BenchではMTPの短いステップ数やblock=8が安全な選択肢になる。高並列時はターゲットモデルの検証ステップが計算バウンドに転じ、投機デコードの恩恵が薄れるためだ。
採択長(Acceptance Length)の比較
ブロックサイズを大きくしたときの採択長の伸びが、DFlashの強みを端的に示している。
| ワークロード | MTP steps=3 | DFlash block=4 | MTP steps=7 | DFlash block=8 | MTP steps=15 | DFlash block=16 |
|---|---|---|---|---|---|---|
| gsm8k | 3.675 | 3.690 | 5.869 | 6.177 | 7.371 | 8.495 |
| humaneval | 3.684 | 3.755 | 6.027 | 6.625 | 8.022 | 10.377 |
| math500 | 3.664 | 3.698 | 5.833 | 6.285 | 7.143 | 8.829 |
| mbpp | 3.424 | 3.510 | 4.909 | 5.453 | 5.519 | 6.994 |
| MT-Bench | 3.133 | 3.087 | 4.257 | 4.316 | 4.820 | 5.242 |
HumanEvalのblock=16では、DFlashが10.38トークン/ターゲットステップに対してMTPは8.02。1回の検証で平均10トークン以上を確定できるのは、ブロック拡散の恩恵が最も出やすいコード生成タスクの特性を反映している。
量子化との組み合わせが「最も面白い結果」
記事が特に強調しているのが、mxfp4量子化との重ね掛けだ。
DFlashはデコードループを加速し、mxfp4量子化はターゲットモデルのメモリフットプリントを削減する。両者は異なるボトルネックに作用するため、干渉せずに積み重ねられるかが焦点となった。
検証結果は明快だった。ターゲットをmxfp4に量子化しても採択長はほぼ変わらない。差分はrun-to-runのノイズ範囲内に収まり、ドラフトの品質がターゲットの精度に依存していないことが確認された。量子化による検証パスの高速化(HBMトラフィックがbf16比で約1/4)がそのままスループット向上に乗る。
なお35B-A3B(MoEアーキテクチャ)でmxfp4の恩恵を得るには、VLLM_ROCM_USE_AITER=1の設定とAITER 0.1.16.post2以降が必須だ。これを省略するとvLLMがbf16へのデクォンタイズにフォールバックし、量子化の効果が消える。
起動コマンド
DFlashを有効にしたvLLMサーバーの起動例:
vllm serve Qwen/Qwen3.5-27B \
    --host 127.0.0.1 --port 8000 \
    --tensor-parallel-size 1 \
    --max-num-batched-tokens 32768 \
    --gpu-memory-utilization 0.9 \
    --speculative-config '{"method": "dflash",
                           "model": "z-lab/Qwen3.5-27B-DFlash",
                           "num_speculative_tokens": 15,
                           "draft_tensor_parallel_size": 1}'
num_speculative_tokensはブロックサイズに対応し、4/8/16がそれぞれblock=4/8/16に相当する。ベンチマークはz-lab/dflashのクライアントで実施されている。
まとめ
DFlash+mxfp4の組み合わせは、AMD MI355X上でQwen3.5-27Bの単一リクエストスループットを最大5.02倍に引き上げる。NVIDIAエコシステム以外でのLLM推論最適化の選択肢として、ROCm上での投機的デコードの実用性を具体的な数値で示した点が本記事の価値だ。投機的デコードは高並列バッチでは効果が限定的になることも明示されており、用途に応じた設定選択の指針も含まれている。
詳細はDFlash Speculative Decoding on AMD Instinct MI355X: Up to 5× Faster Qwen3.5 Inferenceを参照していただきたい。