9月17日、Ben Lindersが「Building an Internal Developer Platform with Artificial Intelligence」と題した記事を公開した。この記事では、AIエージェントを内部開発者プラットフォーム(IDP)として構築する際の設計思想と実践的な知見について詳しく紹介されている。
KubeCon & CloudNativeCon Europeでの講演「AI Meets Internal Developer Platform」において、Whitney LeeとViktor Farcicは、AIエージェントが開発者プラットフォームの次の形になりつつあると主張した。
エージェントは次世代のプラットフォームだ。以前はBackstageで開発者にツールを提供していたが、今はエージェントがその役割を担いつつある。(Farcic)
エージェントは開発者からの入力にシステムのコンテキストを組み合わせ、モデルに送信する。モデルは回答を返すか、あるいは利用可能なツールの説明をもとにツールを実行する。
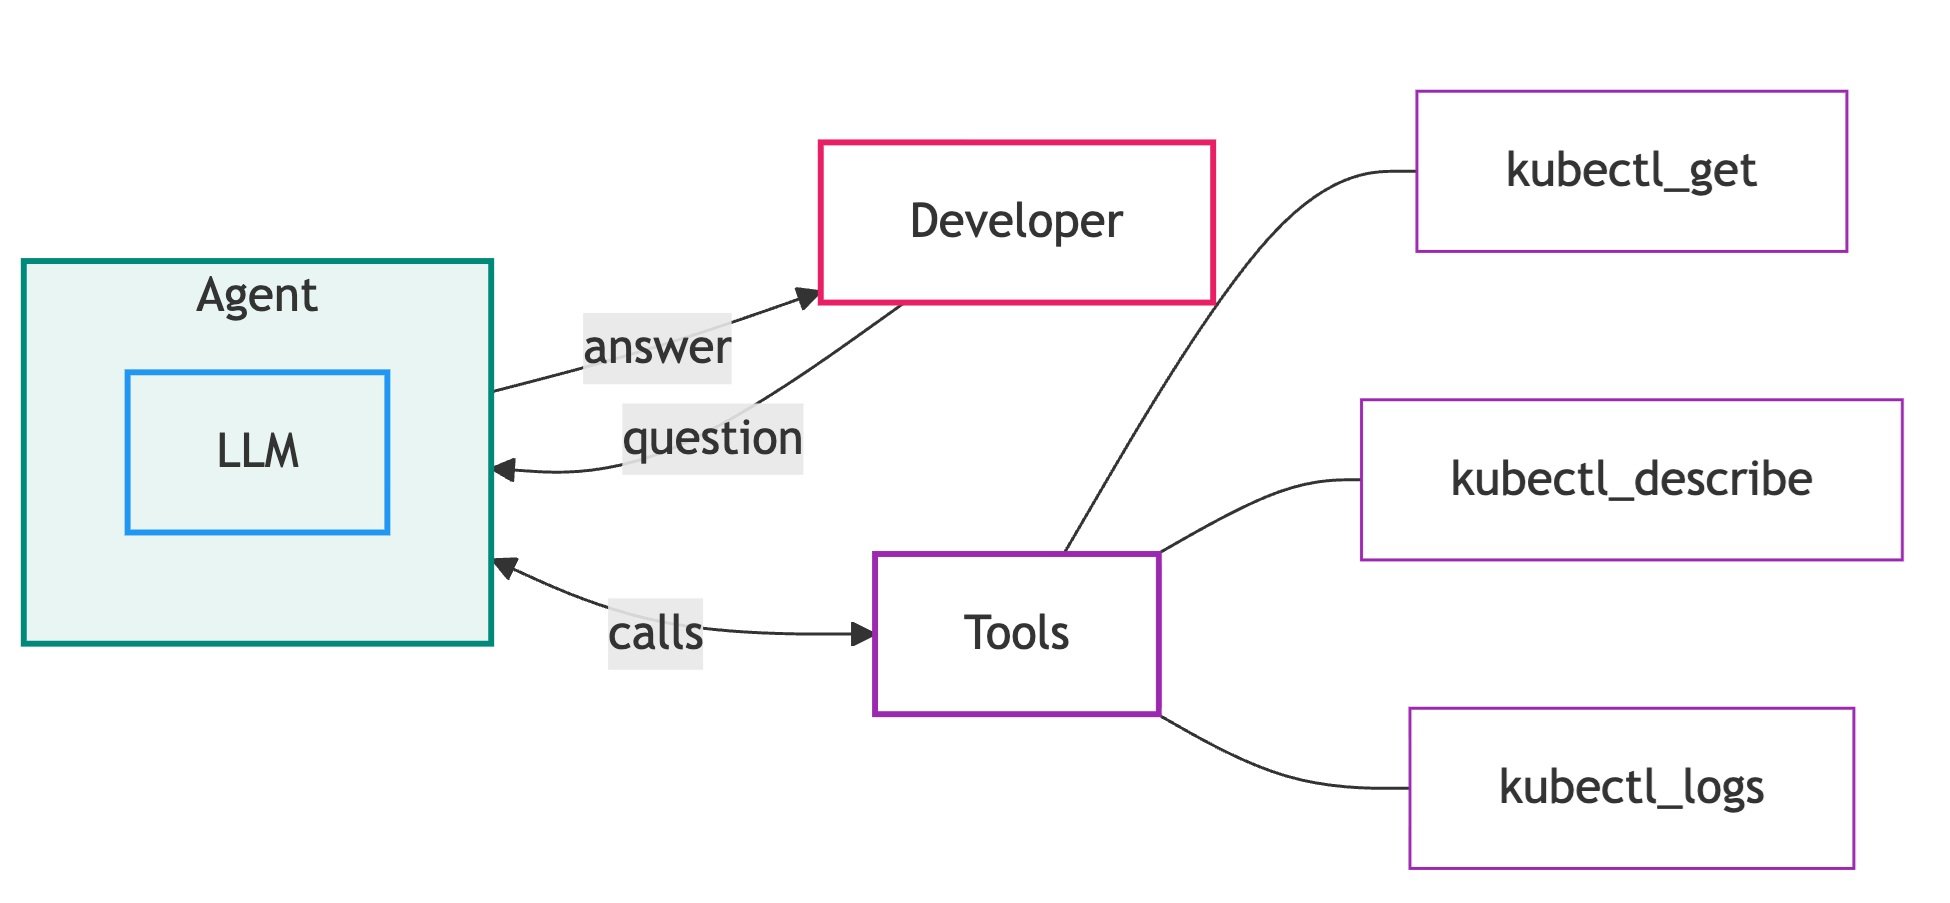
セマンティック検索で「うちの流儀」を学習させる
このアーキテクチャの肝となるのがセマンティック検索だ。エージェントが必要な情報を必要なタイミングで引き出せるよう、組織の知識をインデックス化する。
Farcicは情報源として以下を挙げた:
- Gitリポジトリ(マニフェストやコード)
- プルリクエストのコメント
- Slackスレッド(「なぜあのDBを使わないのか」という議論が眠っている)
- Jiraチケット、Wikiページ、Zoomの設計会議トランスクリプト
「うちのやり方」が実際に書かれているのはそういう場所だ。(Farcic)
セマンティック検索の品質を左右する4つのポイント
Farcicはインタビューの中で、検索精度の鍵はベクトルDBやエンベディングモデルの選定ではなく、何を入れてどう切るかだと強調した。
- ドキュメントだけを信じるな。 ドキュメントは最も古くなりやすい情報源だ。
- チャンクの粒度。 40ページの資料を1つのベクトルに埋め込むと、何についても薄くしか答えられないブロブになる。セクション・関数・リソース定義など、単体で意味が通る単位に分割し、リポジトリ名、チーム名、更新日時などのメタデータを残す。
- 鮮度の管理。 インデックスは一度実行すれば終わりのマイグレーションではない。情報が6ヶ月前のものであれば、エージェントは自信満々に6ヶ月前の答えを返す。継続的なインジェストと削除の伝播が必須だ。
- インデックスに入れるべきでないものを決める。 セマンティック検索は「知識」のためのものだ。クラスターの現在の状態は「状態」であり、毎秒変わる。埋め込まず、エージェントにライブフェッチするツールを与えるべきだ。
ガードレール:何を許可し、何をブロックするか
LLMへの入力は何でもあり得るし、出力もモデルが「すべき」と判断したものになる。Farcicは「入力も出力も完全には制限できない」と率直に認めた上で、ガードレールの設計が不可欠だと述べた。具体的には、自動実行を許可するアクションと、人間の承認を必要とするアクションを明示的に区別することが求められる。たとえばリードオンリーの情報取得は自動実行を許容しつつ、本番環境へのデプロイや設定変更といった破壊的操作については承認フローを挟む、といった設計が典型例として挙げられている。ガードレールはモデルの能力の問題ではなく、システム設計の問題だとFarcicは強調した。
トレースが「唯一の証拠」になる
エージェントの挙動を把握するためのツールとして、Farcicはログ・メトリクス・トレースの活用を推奨した。中でもトレースが特に重要だと指摘する。
通常のアプリケーションが壊れたとき、同じ入力で再実行して再現できる。エージェントはそれができない。同じ質問を2回投げると、2つの異なる実行パスが返ってくる。だからトレースはデバッグの補助ではなく、その実行が起きた唯一の証拠だ。(Farcic)
Farcicがトレースで確認する観点は3つだ:
- エージェントが何を決定したか。 どのツールを、どの順序で、どの引数で呼んだか。呼ばれないツール、または常に誤って呼ばれるツールは、モデルの問題ではなくツール説明の問題だ。
- 時間とコストの使われ方。 スコープの甘いセマンティック検索1回で5万トークンがコンテキストに流れ込むことがある。それはトレースでしか見えない。
- 監査証跡。 エージェントが本番環境で何かを変更した場合、「AIがやった」は通らない。誰が承認したかを示す記録が必要だ。
OpenTelemetryによる実装
OpenTelemetryはすでにGenAI向けのセマンティック規約を定義しており、モデル呼び出しのスパン(モデル名、トークン数、ツール呼び出しとその引数)を標準化している。
OpenTelemetryを使えば、データをどこにでも送れる。トレースはJaegerやGrafana Tempo、メトリクスはPrometheus、ログはLoki。DatadogやHoneycomb、Dynatrace、ElasticといったSaaSも全てOpenTelemetryを取り込める。(Farcic)
トレースはそのままテストデータになる
開発者が実際に投げた質問と、エージェントが実際に辿ったパスは、会議室で考案したテストケースよりはるかに優れた評価セットになる、とFarcicは結論づけた。
また、Leeはトレースがプラットフォーム改善のフィードバックループにもなると述べた。
大量のトレースを見ることで、開発者がプラットフォームを通じて何を達成しようとしているかが見えてくる。それがプラットフォームチームに対して、開発者体験のどこを改善すべきかを教えてくれる。(Lee)
詳細はBuilding an Internal Developer Platform with Artificial Intelligenceを参照していただきたい。