9月19日、MarkTechPostが「Alibaba Qwen Team Releases Qwen3.8-LiveTranslate: A Real-Time Interpretation Model That Cuts Average Lag to 2.3 Seconds Across 60 Languages」と題した記事を公開した。AlibabaのQwenチームがリリースしたリアルタイム同時通訳モデル「Qwen3.8-LiveTranslate」は、話者がまだ発話している最中に翻訳テキストと音声を返す設計で、60言語に対応する。同時通訳の実用化は長年の課題だったが、本モデルはラグの短縮とアーキテクチャの再設計によって、その壁に正面から挑んでいる。
平均ラグ2.3秒、60言語対応のリアルタイム通訳モデル
QwenチームがQwen3.8-LiveTranslateをリリースした。話者がまだ話している最中に翻訳テキストと音声を返す同時通訳モデルだ。音声に加えてオプションで映像フレームも入力できる。
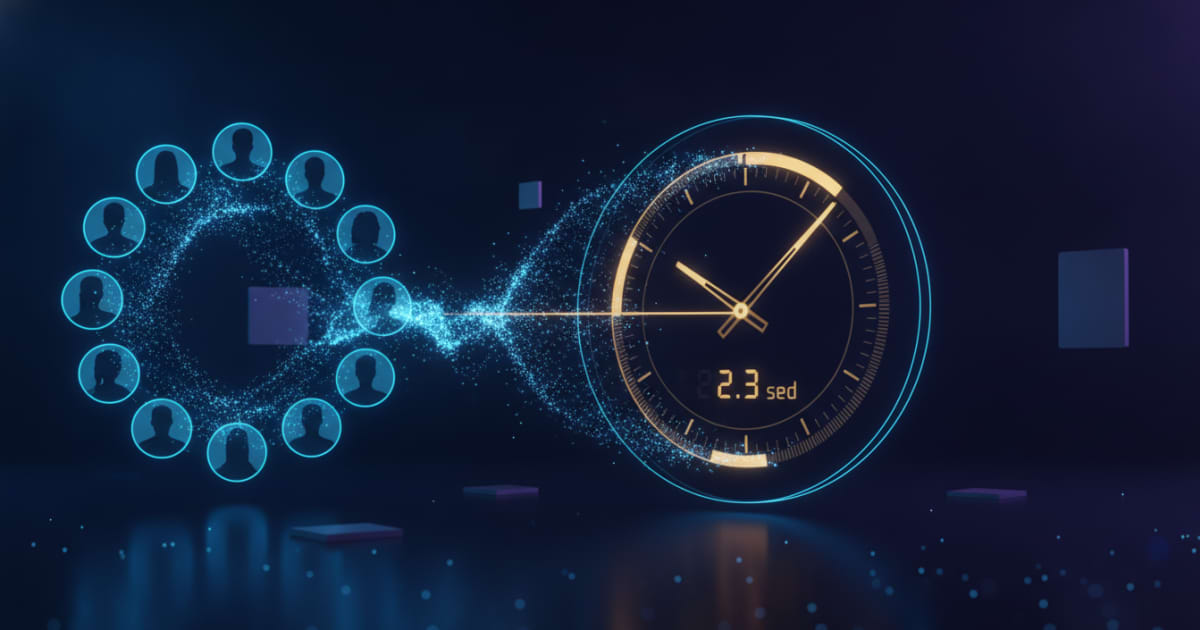
最大のポイントは平均ラグ(LAAL)の削減だ。元記事では平均ラグ2.3秒を達成したと報告されている。
LAALとは「Length-Adaptive Average Lagging」の略で、翻訳が原発話からどれだけ遅れているかを平均で測る指標だ(詳細はarXiv論文を参照)。出力を過剰生成することで見かけ上のスコアを稼ぐシステムを評価しない設計になっており、実運用に近い指標として使われる。同時通訳の現場では、プロの通訳者でも数秒のラグが生じることは珍しくなく、2秒台という数値は実用上の閾値に近い水準といえる。
アーキテクチャの変更:Interleave方式とは
同時通訳は本質的にトレードオフだ。より多くの文脈を得るために待てば精度は上がるが、リスナーへの遅延が増える。Qwen3.8-LiveTranslateはこのループをInterleaveアーキテクチャで再設計した。
ベースはQwen-Omniスタックで、大規模マルチモーダルデータ、言語・モダリティ間のアライメント、視覚強化を組み合わせている。モデルの正式名称はqwen3.8-livetranslate-flash-realtimeで、オフラインの音声・動画翻訳にも対応する。
3つの新機能
リアルタイム話者識別(Speaker Diarization)が追加された。複数話者の発話を区別し、それぞれの声をより安定したボイスクローニングで再現する。APIにはalwaysモードが用意されており、複数話者セッションでは応答ごとに再クローニングを行う。
同期バイリンガル表示では、原文テキストと翻訳が画面上に並列表示される。APIでは原文の文字起こしが翻訳ストリームと並行して独立したイベントとして流れる。
長文脈の曖昧性解消では、会話履歴を使って固有名詞や専門用語を一貫して翻訳する。会議の序盤に登場した人名が、後半でも同じ表記で訳されるといった動作だ。
対応言語と入出力仕様
- 理解できる言語:60言語
- 音声出力できる言語:29言語(中国語、英語、アラビア語、ドイツ語、フランス語、スペイン語、日本語、韓国語、ヒンディー語など)
- 残り31言語:テキスト出力のみ
入力は音声と画像(オプション)。唇の動きやジェスチャー、画面上のテキストといった視覚情報が、騒音環境や曖昧な発話の解釈を補助する。ドキュメントでは画像送信レートを毎秒2枚以下に抑えることを推奨している。
ホットワード機能も備えており、特定の原語を固定の訳語にマッピングできる。推奨上限は1,000ホットワード。
API仕様と料金
接続はWebSocket経由で、モデルIDはqwen3.8-livetranslate-flash-realtime。Alibaba Cloud Model StudioとQwenCloudで利用可能だ。
デフォルトの音声フォーマットは入力16kHz PCM、出力24kHz PCM。セッション終了時は必ずsession.finishを送信しないと、最後のセグメントが失われる点に注意が必要だ。
シンガポールリージョンの料金(100万トークンあたり):
| 種別 | 料金 |
|---|---|
| 音声入力 | $7.50 |
| 画像入力 | $0.55 |
| テキスト出力 | $20.00 |
| 音声出力 | $30.00 |
北京リージョンの料金については元記事に記載があるが、小数点以下の端数を含む数値のため、正確な値は元記事および公式ドキュメントで直接確認していただきたい。音声入力は1秒あたり7トークン、音声出力は12.5トークンを消費する。シンガポールリージョンで音声入出力1時間あたりのコストは、テキスト・画像トークンを除いて約$1.54となる。
コンテキストウィンドウは53,248トークン(入力49,152、出力4,096)。デフォルトのレート制限は毎分10リクエスト・100,000トークン。ファインチューニング、バッチ推論、関数呼び出し、構造化出力は非対応だ。