9月23日、Google Developers BlogにてSachin KotwaniとTaylor Mullerが「Introducing Support for Local AI Models in the Antigravity SDK- Google Developers Blog」と題した記事を公開した。Antigravity SDKがローカルAIモデルをサポートし、オフラインでのエージェント開発が可能になったことを詳しく解説している。
ローカルで動くAIエージェント――なぜ今か
クラウドAPIを使ったAIエージェント開発は、コスト・レート制限・プライバシーという3つの制約と常に戦うことになる。特に企業のコンプライアンス環境では、コードをクラウドに送信すること自体が許可されないケースも多い。OllamaやLM Studioに代表されるローカルLLM実行ツールの普及が示すように、「モデルをオンデバイスで動かす」潮流はここ数年で急速に広まっている。
今回発表されたAntigravity SDKのローカルモデル対応は、こうした制約を回避する実用的な選択肢だ。初期サポートとして**Gemma 4 26B A4B(GoogleのオープンモデルシリーズGemmaの軽量MoEバリアント。MoEとはMixture of Expertsの略で、推論時に全パラメータを使わず一部の「専門家」層だけを活性化することで、大規模モデルを低コストで動かす手法)を、Google AI EdgeのLiteRT(旧TensorFlow Lite。エッジデバイス向けの高速推論ランタイム)を使って実行できる。推奨スペックはVRAMまたは統合メモリが24GB超**の環境である。
セットアップ手順
セットアップは3ステップで完結する。
① 仮想環境の作成
python3 -m venv .venv
source .venv/bin/activate
② パッケージのインストールとモデルのダウンロード
pip install google-antigravity litert-lm

litert-lm import \
  --from-huggingface-repo=litert-community/gemma-4-26B-A4B-it-litert-lm \
  gemma-4-26B-A4B-it-gpu.litertlm \
  gemma4-26b
③ エージェントコードの実行
import asyncio
import os
from google.antigravity import Agent, LiteRTAgentConfig
from google.antigravity.hooks import policy

MODEL_PATH = os.path.expanduser("~/.litert-lm/models/gemma4-26b/model.litertlm")

async def main():
   print(f"Using local LiteRT model: {MODEL_PATH}. Please wait for local inference to complete. This could take several minutes.")

   config = LiteRTAgentConfig(model_path=MODEL_PATH).lightweight()
   async with Agent(config) as agent:
      response = await agent.chat("What files are in the current directory?")
      async for token in response:
         print(token, end="", flush=True)

if __name__ == "__main__":
   asyncio.run(main())
一番面白いのは「Architect-Builder」ハイブリッドパターン
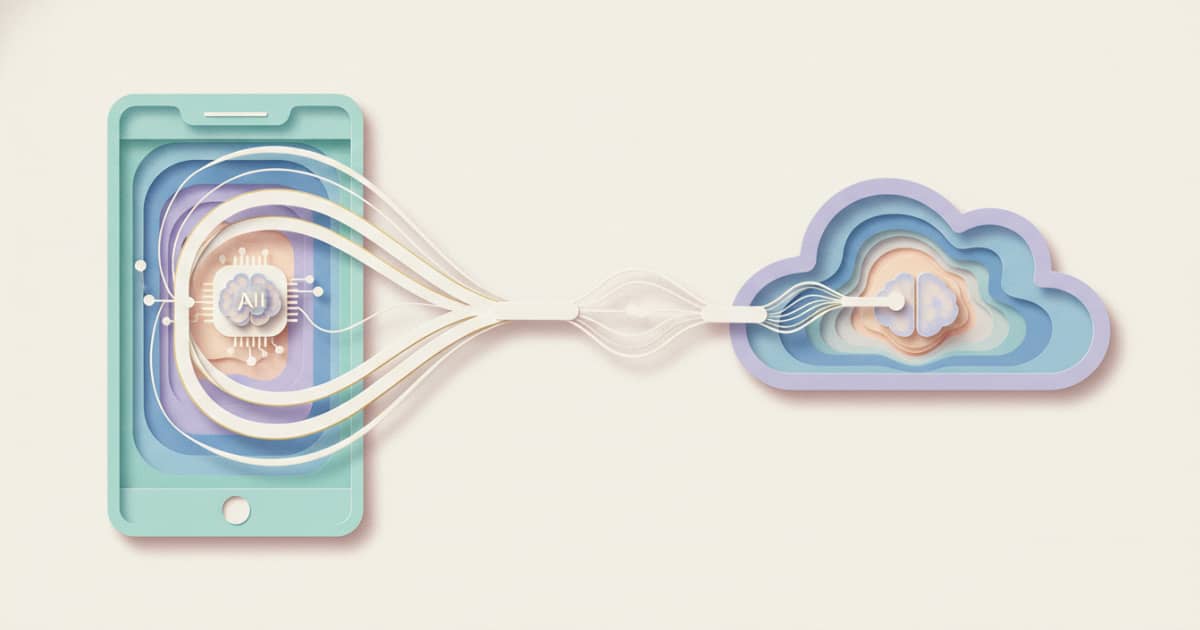
記事の中で最も実用的な応用として紹介されているのが、クラウドモデルを「設計者」、ローカルモデルを「実行者」として組み合わせるパターンだ。
具体的なデモとして、auth.py・billing.py・database.pyという3つの脆弱なモジュールを監査・修正するワークフローが紹介されている。
- クラウド側(Gemini Flash):ファイル名とタスク説明のみを受け取り、作業計画を立案。ソースコードは一切クラウドへ送信しない。消費トークンはわずか95トークン。
- ローカル側(Gemma 4 26B × 複数インスタンス):脆弱性の再現、修正コードの生成、パッチのレビュー、リグレッションテストの検証まで、すべてオンデバイスで完結。
結果として、全トークンの97.2%(3,322トークン)がローカル実行となり、コードはマシンの外に出ないまま修正済みパッチが生成される。
コードレビューや社内コードベースへの適用など、プロプライエタリなコードを扱う場面で有効なパターンだ。
CLIツールの自動生成デモ
もう一つの例として、プロンプト1つでCLIリソースモニターを生成するデモが紹介されている。psutilとrichライブラリを使ったターミナルダッシュボードを、Gemma 4 26B がコード生成・requirements.txt作成・動作確認まで自律的に実行する。
PROMPT = "Build a command-line interface tool using the psutil and rich libraries that displays a live-updating terminal dashboard. It should show CPU usage, memory consumption, and a sorted table of the top 5 most memory-intensive processes. Save the script as 'monitor.py' and create a 'requirements.txt' file. Test that it works."
このワークフローもすべてローカルで完結し、クラウドAPIの呼び出しは発生しない。
OpenAI互換サーバーにも対応
LiteRT以外のローカル推論バックエンドも利用可能だ。LocalOpenAIAgentConfigを使えば、Ollama・LM Studio・vLLMなど、OpenAI互換インターフェースを持つサーバーであれば差し替えられる。エージェントのオーケストレーションやツール定義はそのまま使い回せる。
ローカル実行の4つのメリット(整理)
記事が挙げているメリットを整理すると以下の通りだ。
- コスト削減:APIコストやレート制限なしにエージェントを実行できる
- プライバシー保護:コードや入力データがマシン外に出ない
- オフライン耐性:安定したネット環境がなくても動作する
- ハイブリッド運用:必要に応じてクラウドモデルと組み合わせ、トークン効率を最大化できる
詳細はIntroducing Support for Local AI Models in the Antigravity SDK- Google Developers Blogを参照していただきたい。