9月25日、Google Cloudが「Best practices guide for customizing Gemini models」と題した記事を公開した。この記事では、Geminiモデルのカスタマイズ手法全般——プロンプトエンジニアリング、SFT(教師あり微調整)、そしてRLファインチューニング(RLFT)——を横断的に整理したうえで、それぞれの使い分けとベストプラクティスが詳しく紹介されている。本稿では特にRLFTに焦点を当てつつ、記事全体の文脈も踏まえて内容を紹介する。
Geminiカスタマイズの全体像:プロンプト→SFT→RLFTの段階的アプローチ
元記事が示すのは、Geminiモデルのカスタマイズが一択ではないという前提だ。まずはプロンプトエンジニアリングでどこまで解決できるかを確認し、それで不十分であればSFT(教師あり微調整)、さらにSFTでは対応しきれない要件に対して初めてRLFTを検討する——という段階的な意思決定が推奨されている。
- プロンプトエンジニアリング:追加学習なしに指示・例示でモデルを誘導する。コストゼロで試せる最初の選択肢
- SFT(Supervised Fine-Tuning):正解例のペア(入力→理想出力)を用意してモデルを微調整する。ドメイン固有の知識習得やフォーマット学習に向く
- RLFT(RL Fine-Tuning):正解例の代わりに「評価関数(報酬関数)」を用意し、強化学習でモデルを改善する。正解の定義が難しいが検証は自動化できるタスクに向く
この3段階の位置づけを理解したうえで、以下ではRLFTの詳細に踏み込む。
「正解例」ではなく「評価関数」でモデルを鍛える
LLMのポストトレーニングにおいて、強化学習(Reinforcement Learning: RL)は重要な手法として定着している。しかし、RLの実行には大規模なトレーニングクラスタとモデル内部へのアクセスが必要であり、GeminiのようなプロプライエタリモデルではこれまでAPIユーザーが自前で実施することはできなかった。
Google Cloudはこの課題に対応するため、マネージドなRLファインチューニングサービス(RLFTサービス)を提供している。ユーザーがプロンプトと報酬関数(reward function)を用意するだけで、インフラ管理やモデル内部の処理はGoogle側が担う。
RLFTとSFTの最大の違いは、「正解例を大量に用意する必要がない」点だ。SFTでは理想的な出力例を人手で作成する必要があるが、RLFTでは「応答を採点するプログラム(報酬関数)」を定義するだけでよい。
記事中で挙げられている典型例がSQLだ。「あらゆるスキーマに対して理想的なSQLを手書きすることはできないが、クエリを実行して結果を確認することはできる」——この非対称性こそがRLFTの適用領域を示している。デモンストレーションが難しく、検証が容易なタスクに対してRLFTは力を発揮する。
RLFTを使うべき場面・使わない場面
記事では、RL vs SFTの使い分けについて実践的な指針が示されている。
RLFTが有効なケースは以下のとおりだ:
- 正解が一意に定まらないが、良し悪しは自動で評価できるタスク
- 大量のラベル付き正解例を用意することが困難なタスク
- 実行結果・テスト通過・数値スコア等でレスポンスを客観的に採点できるタスク
一方、SFTの方が適しているケースもある。モデルが知らないドメイン固有の知識を習得させたい場合や、特定の出力フォーマットを厳密に学習させたい場合は、ラベル付きデータを使うSFTの方がシンプルで効果的だ。
RLトレーニングループの仕組み
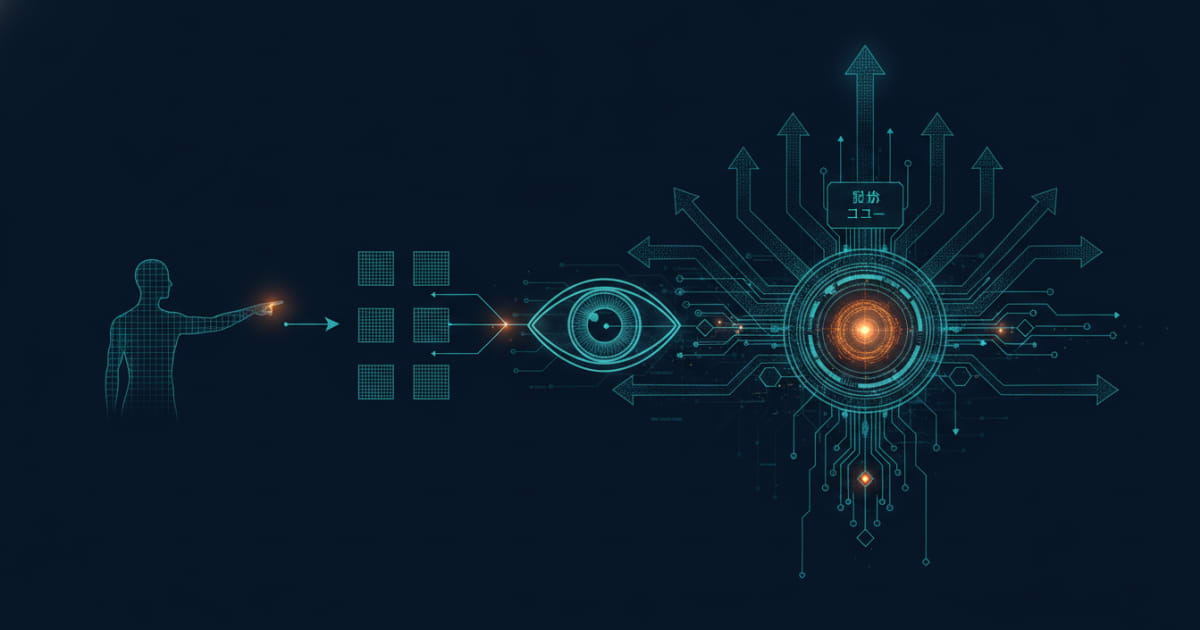
RLFTサービスの内部では、以下のようなループが繰り返される:
- モデルが複数の応答を生成する(サンプリング)
- 報酬関数がそれぞれを採点する
- 高スコアの応答が多く出るようにモデルが更新される
ユーザーが定義するのは「報酬関数」だけであり、インフラ・勾配計算・モデルウェイトの更新はすべてGoogle Cloud側で処理される。
報酬関数の設計が成否を分ける
RLFTの品質は報酬関数の設計に大きく依存する。ここが「採点プログラムを書けばよい」という説明が実際には容易ではない部分であり、記事でも複数の設計原則と注意点が丁寧に紹介されている。
報酬シグナルは明確かつ測定可能であることが基本だ。「良い応答」を漠然と定義するのではなく、コードが実行できるか、テストが通るか、特定の制約を満たすか、といった客観的な基準に落とし込む必要がある。
また、報酬ハッキング(reward hacking)への注意も促されている。報酬ハッキングとは、モデルが本来の目的ではなく報酬関数の抜け穴を突くような出力を学習してしまう現象だ(参考:OpenAI、強化学習における報酬ハッキングの研究)。たとえば「短い応答ほど高スコア」という設計では、内容が薄くても短ければ高評価を得てしまう。報酬関数は意図した品質を正確に反映するよう慎重に設計する必要があり、この設計の難しさこそがRLFT導入における最大の技術的ハードルといえる。
同様に、報酬関数(reward function)とは、強化学習においてエージェント(ここではLLM)の各行動(出力)に対してスカラー値のスコアを返す関数のことだ(参考:強化学習の基礎 — Spinning Up by OpenAI)。RLFTではこの関数をユーザーが設計することで、モデルに望ましい振る舞いを学習させる。
実運用に向けた留意点
記事が強調するのは、RLFTがSFTの代替ではなく補完的な手法だという点だ。まずSFTでベースラインを構築し、その上でRLFTを適用するアプローチが推奨されている。
また、RLFTは計算コストが高いため、まずプロンプトエンジニアリングやSFTで解決できないかを検討してからRLFTに進むことが推奨されている。これは記事冒頭の段階的アプローチとも一貫している。トレーニングのイテレーションを素早く回せるよう、報酬関数の実行速度にも注意を払うべきとされている。
詳細はBest practices guide for customizing Gemini modelsを参照していただきたい。