


10月2日、Wagtailが「One month coding with GLM 5.3 Flash」と題した記事を公開した。オープンソースCMSのコア開発チームが、安価なオープンウェイトLLM「GLM 5.3 Flash」1本に9月の開発作業を絞り込んだ1ヶ月間の実験記録だ。コスト・エネルギー消費・精度をドルとWh(ワット時)という実務的な単位で追っており、LLM活用を本格化させようとする開発チームにとってそのまま参考になる内容である。
結論を先に言うと、実験は「技術的な失敗」だった。それでもチームは「失敗から得た解像度こそが資産だ」と述べており、落とし穴の具体性こそがこの記事の読みどころだ。
「安くて速いモデル1本で1ヶ月」という実験
WagtailはDjango製のオープンソースCMSで、そのコア開発チームがAI活用を積極的に進めている。今回の試みはシンプルだ。9月の1ヶ月間、日常的なエンジニアリング作業をGLM 5.3 Flash一本に絞る。
GLM 5.3 Flashは、清華大学の研究グループTHU-KEGとAIスタートアップZhipu AIが共同開発したオープンウェイトモデルだ。性能とコストのトレードオフ曲線(Pareto最前線)の上位に位置し、「コストあたりの性能」が高い軽量モデルとして注目されている。
結果から言うと、合計2B(20億)トークンを消費したうち、GLM 5.3 Flashに割り当てられたのは約1B(50%)にとどまった。目標の「1本縛り」は達成できず、チーム自身も「技術的には失敗」と明言している。
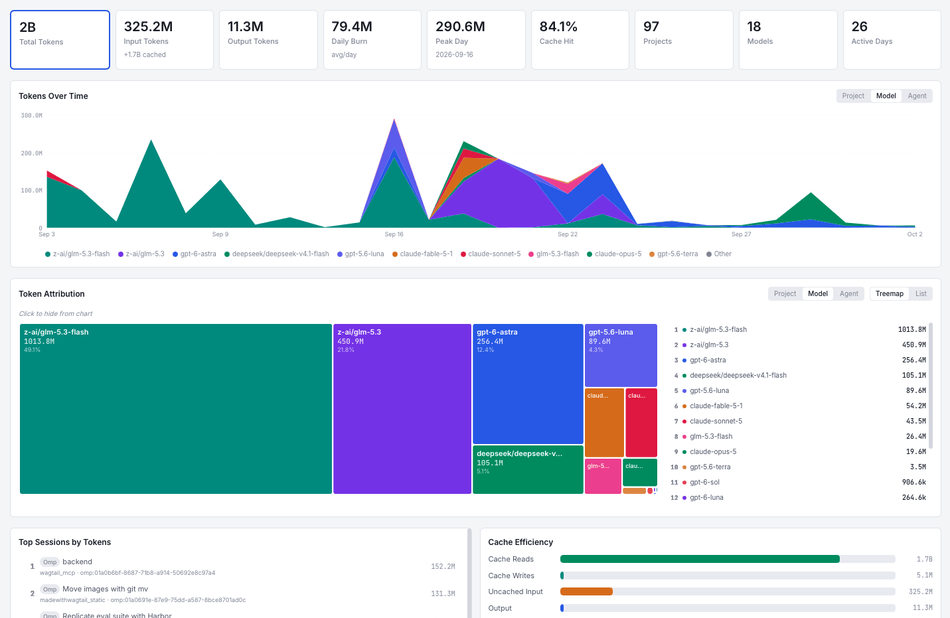
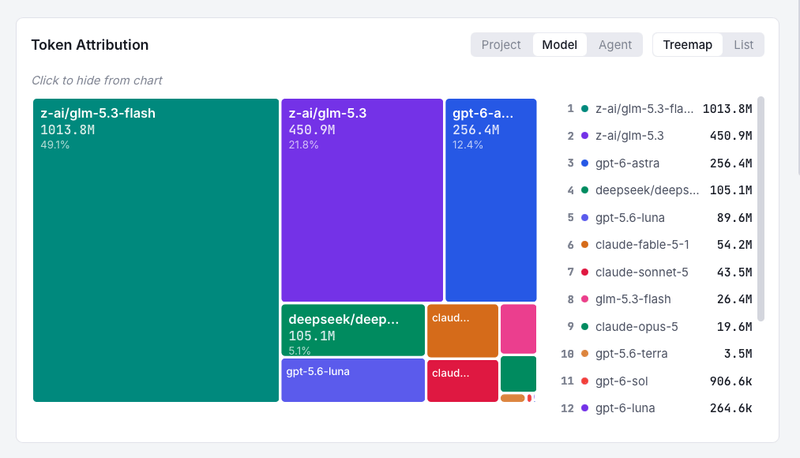
前半の2週間はGLM 5.3 Flash一本で通せた。コストは68ドル、エネルギー消費4kWh、炭素排出365グラムという水準に収まっていた。問題は後半に集中している。
予算を吹き飛ばした3つの誤算
1. バイブコーディングの代償
「バイブコーディング(vibe coding)」とは、設計を詰め切らずに感覚的にAIに書かせる開発スタイルを指す俗称だ。プロトタイプの立ち上げには速いが、モデル選定やプロンプト設計が甘いまま走ると、トークン消費が予想外に膨らむ。
チームが試験的に構築したWagtailのMCPサーバー(AIエージェントと外部ツールを接続するプロトタイプ。MCPはModel Context Protocolの略で、AIモデルが外部APIやデータソースと標準的なインターフェースで連携するための仕様)は、まさにこの手法で作られていた。プロトタイプとして十分機能したが、モデル選定を誤った結果、ほぼ一晩で450Mトークン・150ドル・5kWhを消費してしまったという。
「似たような成果を、おそらく5倍安いコストでほとんど追加作業なしに達成できた。学んだ教訓だ」
MCPサーバー自体は動作し、デモとして価値ある成果になった。しかしエージェント的なパターンを使う場合、モデル選定のミスが即コスト爆発につながるという実感が数字として残った点が重要だ。
2. インフラの可用性問題
GLM 5.3 FlashはPareto最前線の上位に位置するため需要が集中しており、推論プロバイダー側のキャパシティ不足による性能劣化が発生した。
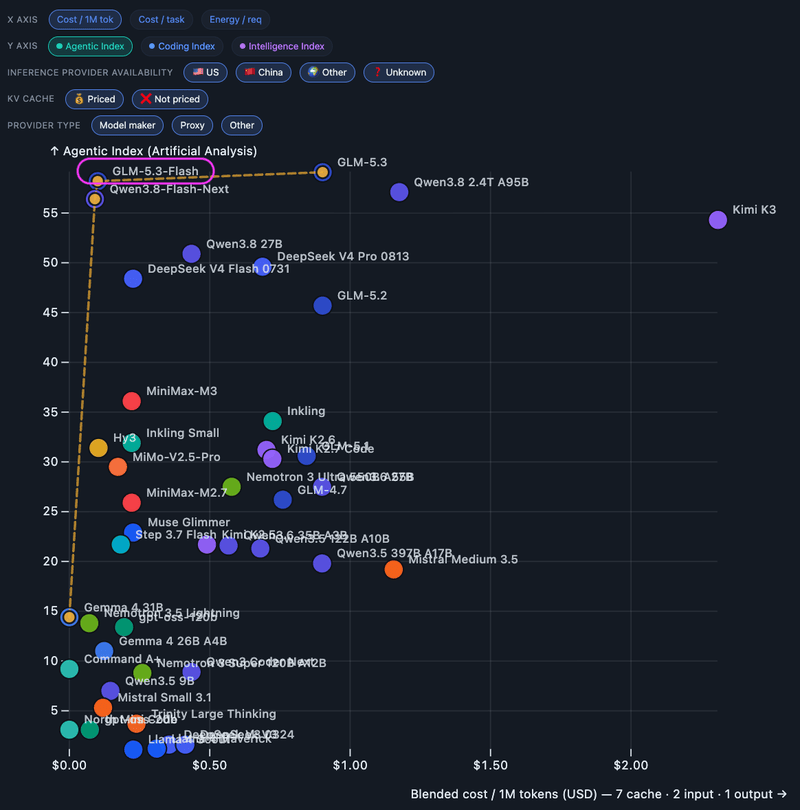
これにより、DeepSeek V4.1 FlashやQwen 3.8 Flashといった代替モデルに切り替えざるを得ない場面が生じた。切り替え自体は容易だが、「1モデルに集中する」という実験の趣旨からは外れる。チームはオープンウェイトモデルと推論プロバイダーの比較を別記事で詳しく論じており、この課題は今後も続く可能性が高い。
3. R&Dそのものがコストになる
日常業務とは別に、モデルのベンチマーク作業自体がトークンを大量に消費する。Wagtailタスクに特化したベンチマークを構築中で、その途中データも公開されている。
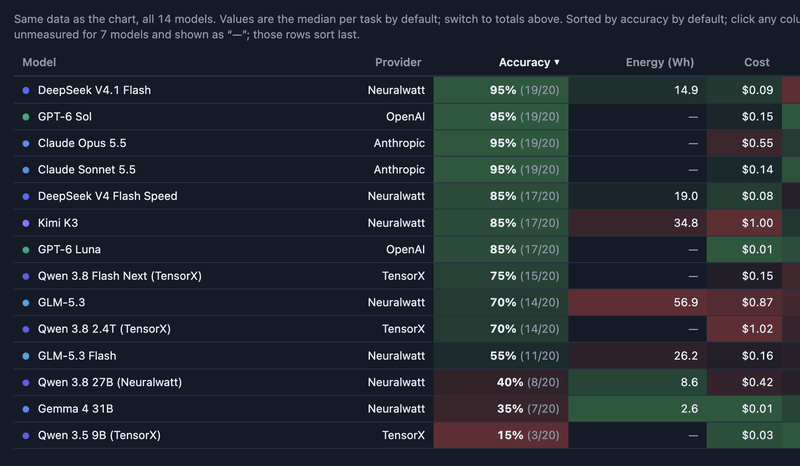
現時点のトップはDeepSeek V4.1 Flashで、精度95%・エネルギー消費14.9Wh・1タスクあたり0.09ドル。こうした具体的な数値があることで、「より軽量なモデルを選ぶ」という判断を根拠とともに示せるようになると述べている。
10月の方針:4つの改善点
失敗の整理を経て、チームは次の方針を立てた。
- トークンだけでなく、エネルギー消費とコストをリアルタイムで計測・報告する
- 実験・R&D分の予算を別枠で確保し、プロトタイプの取捨選択を慎重にする
- プロンプト設計とマルチエージェント構成(オーケストレーター・スカウト・実装者・レビュアーの役割分離)を整備する
- 効率が上がるほど利用量も増えるという逆説(経済学でいう「ジェボンズのパラドックス」)を意識しながら、より効率的な手法とモデルを追い続ける
記事の結論はこうだ。「日常的な開発作業では、フラッシュ層の安価なモデル1〜2本に絞ることは十分に実現可能だ。AIの推論コスト(コストまたはエネルギー消費で測って)の大半を、こうした効率的なモデルで賄うのが目標だ」。
「安価モデル1本で戦えるか」という問いへの答えは「条件次第ではYes、ただし落とし穴がある」だ。そしてその落とし穴を、トークンという曖昧な指標ではなくドルとWhで記録した点がこの記事の際立った特徴である。LLMコストの議論が「なんとなく高い・安い」から「具体的な数値で比較できる」フェーズに移行しつつあることを、この実験は示している。
詳細はOne month coding with GLM 5.3 Flashを参照していただきたい。


