


10月6日、SalesforceエンジニアリングチームのRoopang Chauhan、Sundar Vedula、Peng-Wen Chen、Nikhil Bojjaが「AI Agents Need Memory: Building Persistent Memory for Agentforce」と題した記事を公開した。この記事では、Salesforceの企業向けAIエージェントプラットフォーム「Agentforce」が抱える「状態を持たない問題」を解決するために設計・実装した永続メモリアーキテクチャについて詳しく紹介されている。
Agentforceとは何か
Agentforceは、Salesforceが提供する企業向けAIエージェントプラットフォームだ。カスタマーサポート・営業・マーケティングなどの業務領域において、LLMベースのエージェントが自律的にタスクを実行する。CRMデータや業務フローと深く統合されていることが特徴であり、エンタープライズ用途を前提に設計されている。本記事で紹介するメモリアーキテクチャは、そのAgentforceに永続的な文脈保持能力を付与する取り組みだ。
「毎回ゼロから説明させる」問題をどう解決したか
LLMベースのAIエージェントが抱える根本的な課題の一つが、会話をまたいだ文脈の喪失だ。セッションをまたぐと、ユーザーは自分が誰で、何をしてきて、何が必要かを毎回説明し直さなければならない。Agentforceチームはこれを 「Groundhog Day(同じ日を繰り返す映画)問題」 と呼ぶ。
チームが目指したのは、銀行のコールセンターの最良の体験に近いものだ――担当者はすでに顧客のことを知っており、過去の取引も把握した上で、問題解決にすぐ集中できる。これをエンタープライズAIで実現するのが、Agentforce Memoryの目的である。
エンタープライズ用途では、この問題は個人ユーザー向けサービス以上に深刻だ。顧客が繰り返し同じ背景情報を入力することは業務効率を損なうだけでなく、エージェントへの信頼感も失わせる。記事はその前提を丁寧に描き出した上で、設計の課題に入っていく。
まず「共通言語」を定義することから始めた
実装より先に立ちはだかったのが、用語の混乱だった。AI業界では「セマンティックメモリ」「エピソードメモリ」「手続き記憶」「短期記憶」「長期記憶」といった概念が、ベンダーや論文によって異なる定義で使われている。同じ言葉を使いながら別のものを指しているため、アーキテクチャ議論が噛み合わない状況が生まれていた。
チームはまず共有用語ドキュメントを作成し、各メモリ概念とAgentforce内での役割を明文化した。特に重要だったのは、「メモリ全体」と「エージェントのランタイムコンテキストに実際に注入される情報のサブセット」の境界を明確にしたことだ。この語彙の統一が、その後のすべての設計判断の土台になった。
こうした「定義から始める」アプローチは、複数チームが関わる大規模なシステム設計では特に有効だ。メモリの「何を保存するか」と「何を注入するか」を区別したことで、設計の責任境界も自然に明確化された。
PoC→パイロットへ:アーキテクチャが3段階で進化した
タイトルに掲げた「3段階の進化」は、PoC・パイロット・統合という実践的なフェーズとして展開される。機械的なバージョンアップではなく、各段階で課題に直面しそれを解決した結果として次の形が生まれたという構造だ。
第1段階:会話履歴とユーザープロファイルの注入
既存の仕組みを活用できる部分から着手し、即座に応答品質を改善した。まず動くものを作ることで、何が不十分かを実測で把握するPoCフェーズに相当する。
第2段階:セマンティック検索への移行
「最近の会話」だけを注入する方式では不十分だと判明した。ユーザーが数週間前に述べた重要な好みが、後から決定的な意味を持つケースがあるからだ。チームはセマンティック検索(意味的類似性に基づく検索)を導入し、単に最新の会話を再生するのではなく、関連性の高い会話を取り出せるようにした。時系列ではなく意味的関連性で検索対象を絞ることで、コンテキストの品質と効率を両立させている。
第3段階:メモリをReasonerの内部へ統合
初期の実装では、メモリ機能をAgentforceの「アクション」として外部に公開していた。しかし管理者がサブエージェントごとにアクション・指示・設定を手動で追加する必要があり、設定の複雑さと既存エージェントを壊すリスクが問題になった。
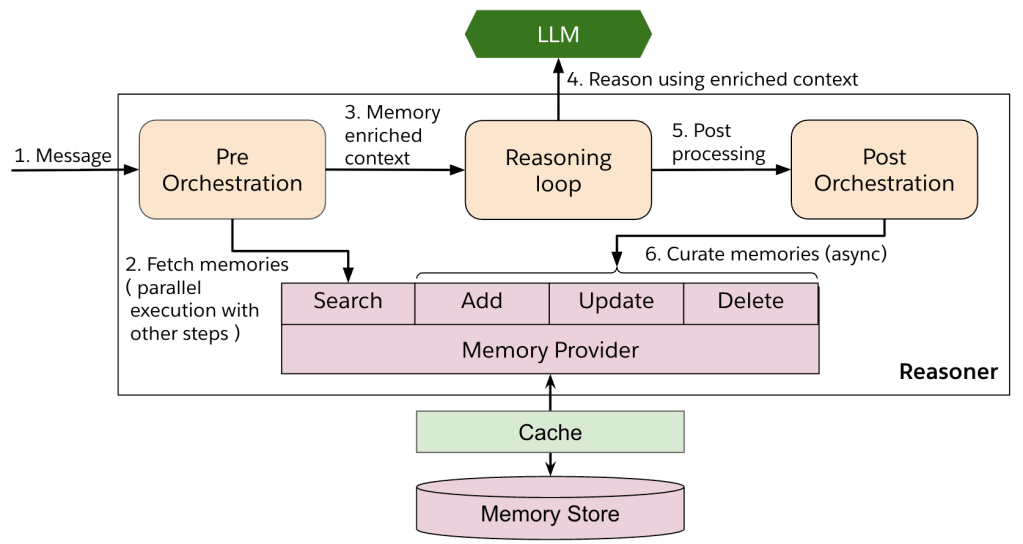
解決策は、メモリをReasonerの内部に組み込むことだった。結果として有効化の手順は大幅に簡素化され、メモリのキュレーション・検索・コンテキスト注入はすべてReasonerが自動処理する。この統合によって、新規エージェントだけでなく既存エージェントへの影響を最小化しながらメモリ機能を展開できるようになった。
検索タイミングの設計:なぜ「プリオーケストレーション時」なのか
チームはメモリの検索・注入方式として以下を検討した:
- 全メモリをコンテキストに注入する → コンテキストウィンドウが膨張
- LLMがオンデマンドでメモリを検索する → レイテンシ増大
- コンテキストを段階的に開示する
- 推論開始前にキーワード検索を実行する
データサイエンス実験とレイテンシ計測の結果、採用されたのは「推論(Reasoning)が始まる前のプリオーケストレーション段階でキーワード検索を行い、マッチした場合のみメモリを注入する」方式だ。
このアプローチの利点は2つある。まず、コンテキストウィンドウのサイズを制御できる。次に、プリオーケストレーションの他のステップと並行して実行されるため、ユーザーへの応答遅延を最小化できる。「いつ検索するか」という設計判断が、品質とパフォーマンスの両方に直結することをこのセクションは示している。
プライバシーと信頼は「後付け」ではなくアーキテクチャ要件として設計
パイロット準備段階で明確になったのは、永続メモリは技術的課題だけでなく信頼の問題でもあるという点だ。当初は管理者がメモリ有効化を組織全体で制御する想定だったが、法務・プライバシー要件の検討により、個々のユーザーにも意味のある制御権が必要だと判断された。
対応として導入されたのは以下の2つだ:
- ユーザー設定:Agentforce Memory全体、または個別エージェント単位でメモリを有効/無効にする
- Memory Management Console:保存されたメモリをユーザーが確認・編集・管理できるUI
さらに、標準インターフェース以外のチャネルでもこれらの設定を会話形式で操作できる拡張が進められている。
「メモリを持つエージェント」は便利である一方、「自分の発言がどこまで記録されているか」を把握できないユーザーの不安を高めるリスクも持つ。技術的な完成度と同等に、透明性と制御可能性をアーキテクチャの一部として設計した点は、エンタープライズ向けAI製品の設計指針として参考になる。
詳細はAI Agents Need Memory: Building Persistent Memory for Agentforceを参照していただきたい。


