10月7日、Futurum Groupが「CoreWeave Fully Connected 2026: Forge Brings Frontier Lab RL to Every AI Team」と題した記事を公開した。強化学習(RL)インフラはこれまでOpenAIやAnthropicのようなフロンティアラボだけが実用的に扱える技術だった。専任のインフラチームと膨大なコンピュート予算が前提であり、一般企業チームには現実的でなかった。CoreWeaveが発表したForgeは、このRLインフラをマネージドサービスとして提供することで、その参入障壁を取り除こうとする試みだ。RLが「特別なラボの専有技術」から「タスク定義とスコアリング手段さえあれば誰でも使える汎用インフラ」になるとすれば、AIモデル開発の構造そのものが変わる可能性がある。
CoreWeave Forgeとは何か——統合レイヤーとしての設計思想
Fully Connected 2026は、9月29日〜10月1日にサンフランシスコで開催されたCoreWeaveのAIクラウドカンファレンスで、5,500人が参加した。
最大の発表はCoreWeave Forgeだ。Forgeを理解するには、CoreWeaveが「AIループ」と呼ぶ概念から入るのが早い。「実行→観察→キュレーション→改善→評価→繰り返し」というサイクルを、一つの環境でつなぐ統合開発レイヤーがForgeである。
従来、このサイクルの各工程は別々のツールやインフラで動いており、企業はそれらを自前でつなぐ必要があった。Forgeはその接着層を担う。具体的な構成は以下の通りだ。
| レイヤー | ツール・サービス | 役割 |
|---|---|---|
| 買収済みOSS/SaaS | Weights & Biases | 実験管理・ログ |
| 買収済みOSS/SaaS | marimo | インタラクティブノートブック |
| 買収済みOSS/SaaS | OpenPipe | ポストトレーニング |
| CoreWeave自社サービス | ARIA | 研究エージェント(自動化支援) |
| CoreWeave自社サービス | Agent Lens | 本番トレースの可観測性 |
| CoreWeave自社サービス | CoreWeave Sandboxes | 並列RL環境の立ち上げ |
| CoreWeave自社サービス | CoreWeave Registry | モデル・成果物管理 |
| CoreWeave自社サービス | サーバーレスポストトレーニング | オンデマンドのトレーニング実行 |
ARIA・Agent Lens・Sandboxesはそれぞれ独立した機能に見えるが、Forgeの文脈では「調査→失敗検出→環境実行」という一連のRLループの中に位置づけられている。ARIAがリサーチを自動化し、Agent Lensが本番の失敗シグナルを拾い、Sandboxesがその報酬シグナルを用いてRL環境を並列実行する、という流れだ。
Free・Pro・Enterpriseの3エディション構成で、調達プロセスなしにチームが使い始められる設計だ。すでにMasterClassとCanvaが構築中だという。
RLをマネージドサービスに落とし込む——蒸留からRLへの移行パス
エンジニア視点で最も注目すべきは、RL(強化学習)パイプライン全体をマネージドサービスとして提供する点だ。タスクの定義とスコアリング手段さえあれば、インフラ面の障壁はForgeが除去するという設計思想である。
RL Rollouts(現在プレビュー)は、Dedicated Inference上で新しいチェックポイントの重みをリデプロイなしに実行中のデプロイへ直接ロードし、トレーニングループを止めずに回し続ける仕組みだ。トレーナー・報酬設計・環境は顧客側が用意する。CoreWeave Sandboxesは並列でRL環境を立ち上げ、スコアをWeights & Biasesへ返送する。Agent Lensは本番環境の失敗トレースを報酬ターゲット定義のシグナルに変換し、「汎用フロンティアLLMの10分の1のコストで重大障害を20%多く検出する」とCoreWeaveは主張している。
キーノートのライブデモでは、ヘルプデスクエージェントがチケット誤送信の問題からサーバーレスRLを経て改善済みモデルに到達するまでを実演した。CoreWeaveは「サーバーレスRLはセルフマネージド構成より1.4倍高速、40%低コスト」と主張するが、これは内部測定値であり、顧客による検証待ちの数字として読むべきだ。
ただし、CoreWeaveの幹部は正直に認めている。現時点でRLの需要はCognitionのようなAIネイティブ企業に集中しており、多くの企業はまだRLを動かしていない。企業の投資は現在、ファインチューニングと蒸留(distillation)に向かっている。
蒸留とは、大規模モデルの知識をより小さなモデルに転移させる手法だ(Hugging Faceの解説も参照)。CoreWeaveによれば、顧客は推論コスト削減を目的に蒸留を始め、特定タスクでの性能向上を確認してプラットフォームに留まる傾向があるという。この「蒸留で入り、RLへ移行する」という流れが、Forgeの想定する企業の典型的な導入パスだ。
こうした文脈で、Z.aiのGLMやMoonshot AIのKimiといった中国系オープンウェイトモデルへの関心がこの6ヶ月で急上昇しているという指摘が記事に登場する。蒸留の素材となる大規模モデルとして、クローズドなフロンティアAPIの代替を求める企業がオープンウェイトモデルに目を向けており、フロンティアAPIと比較検証したうえで社内の小グループに展開するケースが増えているためだ。RLとは直接つながらないが、「コスト効率の高いオープンウェイトモデルで蒸留→ファインチューニング→RL」という移行パスの起点として、この動向はForgeのユーザー獲得戦略と接続している。
競合との位置づけについて記事は率直に分析している。AWSはSageMaker HyperPod・Bedrock・個別の可観測性ツールに分散し、GoogleとMicrosoftはVertex AIとAI Foundryのコンポーネントを顧客が自前でつなぐ構造だ。NebisやTogether AI、Lambdaはキャパシティ提供とDIY実験支援にとどまる。Forgeはその中間にあり、モデル・フレームワーク・クラウドを問わず接続されたループを提供するが、サンドボックスやサーバーレスRLなどのサービス層はCoreWeave上でのみ動作する。Freeティアには最初からCoreWeaveのコンピュートが付属しており、クロスクラウドの開放性はCoreWeave自社クラウドへのファネルの入口でもある。
Vera Rubin NVL72の性能数値
ハードウェア面では、CognitionがVera Rubin NVL72クラスターを9月初旬に立ち上げ、顧客主導で実行した最初のベンチマーク結果を公開した。GB200 NVL72との比較で、SWE-2推論ワークロードのトークンスループットが4.8倍、RLロールアウトのトークンスループットが3.8倍という数値だ。GB300との比較では推論アドバンテージは2.75倍に圧縮される。RL rolloutのスループット向上がForge全体の主張を裏づける数値として記事は特に重視している。
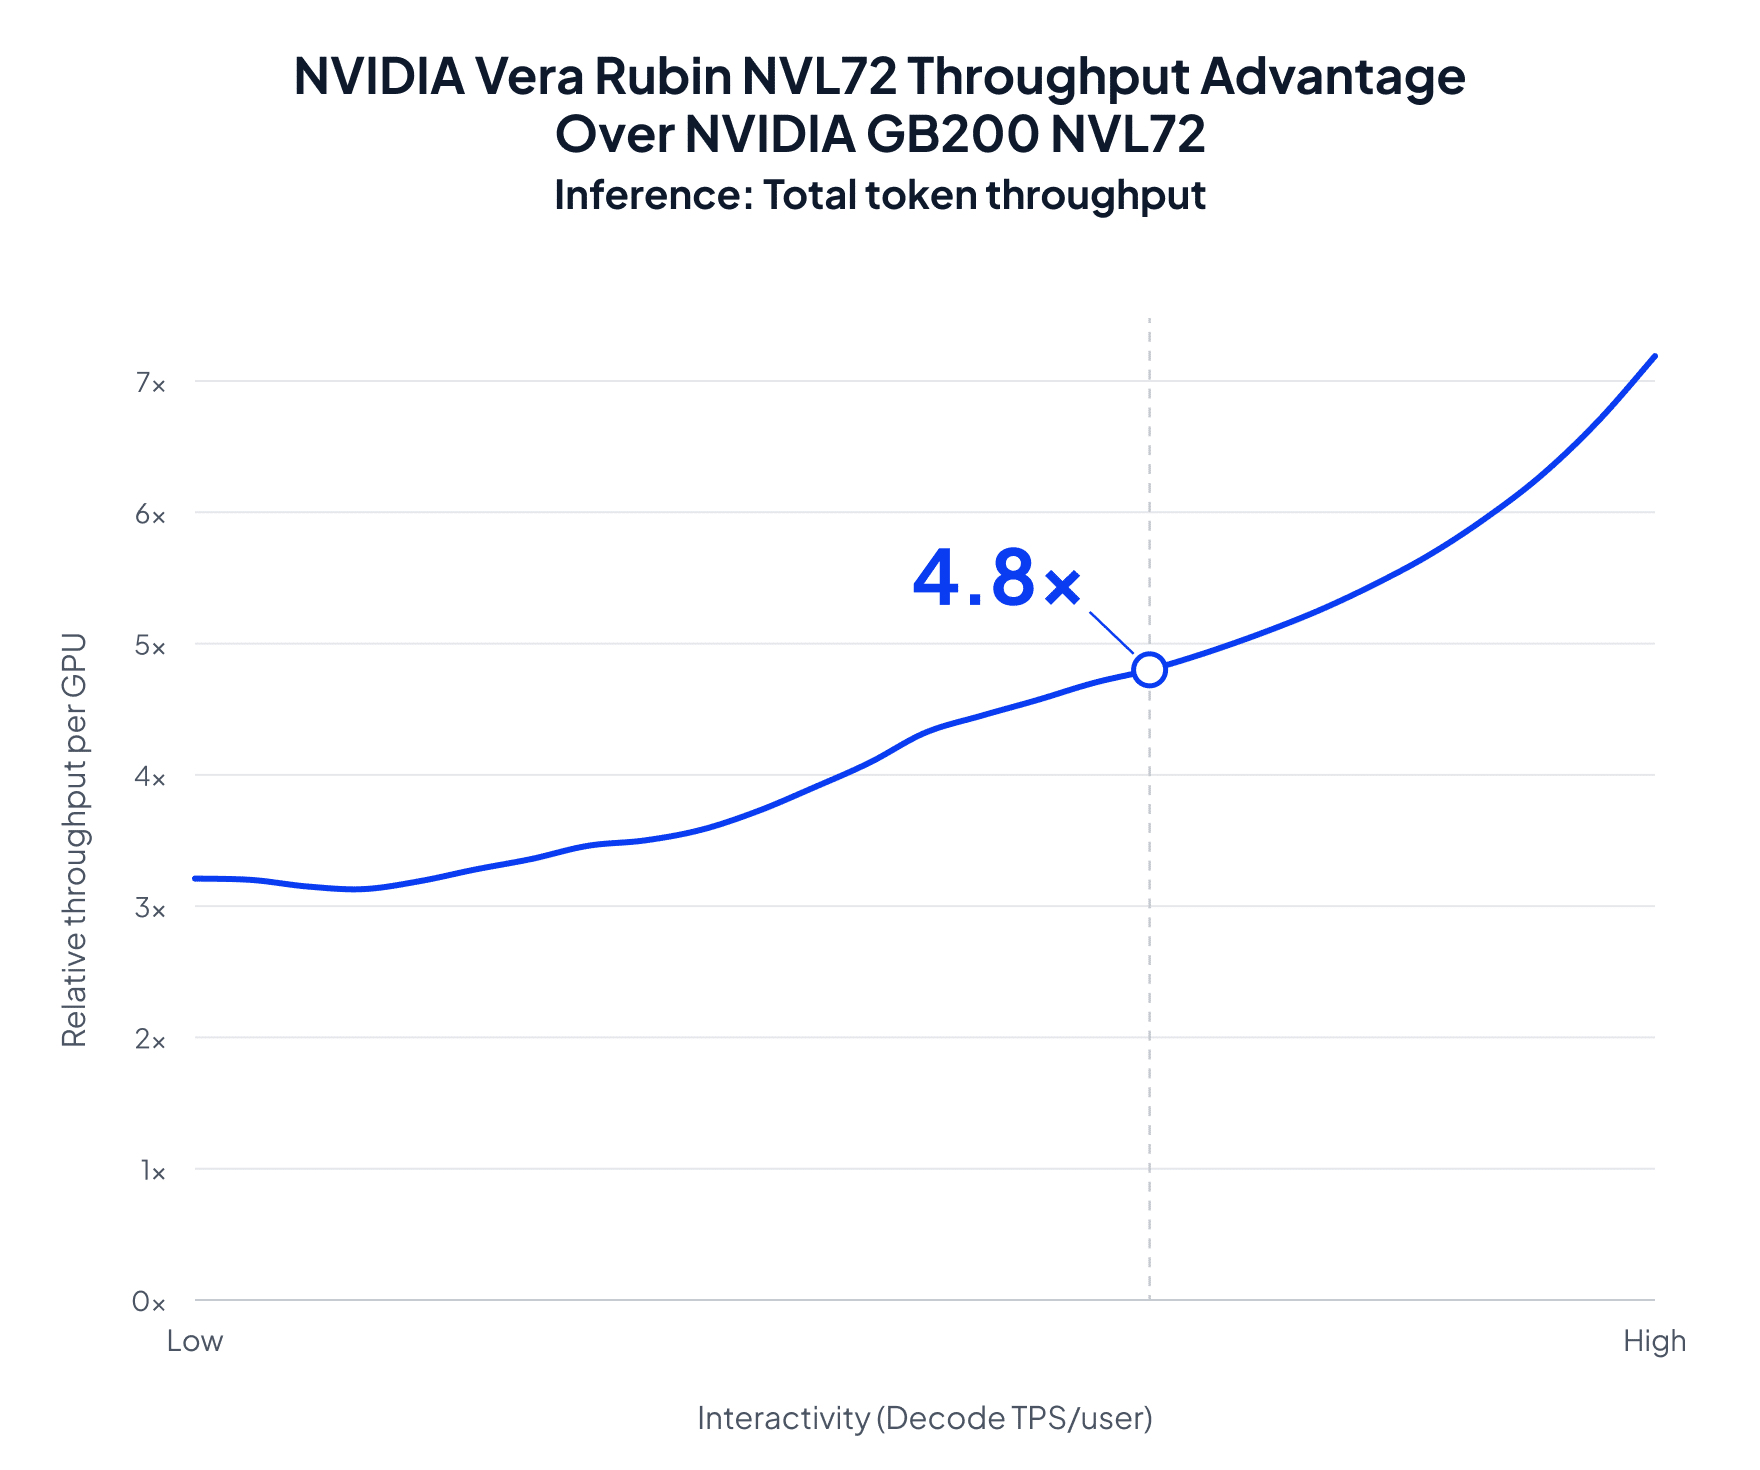
Source: CoreWeave
CognitionはVera RubinをGB200・GB300フリートと同一の運用モデルの下で動かしており、ブリッジキャパシティから9ヶ月以内に数千GPU規模に拡大した。2017年のNVIDIA Voltaシリコンが今もCoreWeave Cloud上で商用稼働しているという事実は、ソフトウェアの一貫性がNebiusや他のネオクラウドとの差別化要因になりつつあることを示している。
残る課題
記事が注目点として挙げるのは以下だ。
- RL Rolloutsがプレビューから正式リリースに移行するか、発表デモ以外の顧客名が公表されるか
- 企業の蒸留・ファインチューニング顧客が今後2四半期でサーバーレスRLに移行するか
- Forge Free・Proのサインアップがエンタープライズ契約に転換するか
- AWSやGoogle Cloudがバンドル提供で対抗してくるか
報酬設計(reward engineering)だけはForgeが代わりにできない工程として残る。そこがエンタープライズ顧客にとっての最後のハードルだ。
詳細はCoreWeave Fully Connected 2026: Forge Brings Frontier Lab RL to Every AI Teamを参照していただきたい。