2026年10月8日、Varonisが「Least Privilege for AI Agents: A Practical Guide for Security Leaders」と題した記事を公開した。この記事では、AIエージェントに最小権限の原則を適用するための具体的な実装ステップと、従来の人間中心のアクセス管理がなぜエージェントに通用しないかについて詳しく紹介されている。
AIエージェントは既存のアクセス管理を破綻させる
AIエージェントの普及速度に、ガバナンスが追いついていない。SailPointが353人の専門家を対象に行った調査によると、**エージェントを保護するポリシーを持つ組織はわずか44%**にとどまる。
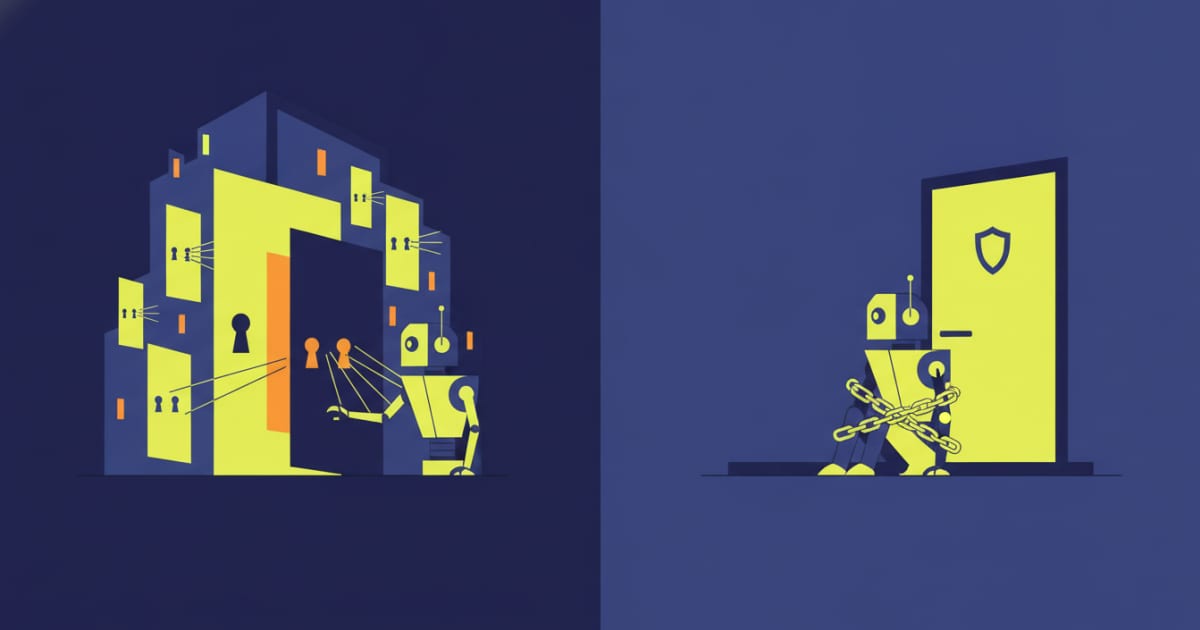
問題の本質はシンプルだ。従来のIAM(Identity and Access Management)は人間を前提に設計されている。エージェントは人間ではなく、コードで生成される非人間IDであり、マシンスピードで自律的に動作する。エージェントが引き継ぐアクセス権限そのものが、攻撃対象領域になる。
具体的に何が起きているか。SailPointの同調査では80%の回答者がAIエージェントの意図しない動作を経験したと回答。Cloud Security Allianceが418人のIT・セキュリティ専門家を対象に実施した調査では、65%が過去1年以内にAIエージェント関連のインシデントを経験している。
Varonisの2025年版データセキュリティレポートは、1,000組織のブラストラジアス(侵害時の影響範囲)を測定し、「10人に1人のユーザーまたはサービスアカウントが、あらゆるデータを自由にエクスポートできる」という実態を明らかにした。そのアカウントにエージェントを接続すれば、オンボーディングなし・制限なしの新入社員を雇ったも同然だ。
なぜ従来の最小権限がエージェントに効かないのか
従来のアプローチが壊れる主な理由は4つある。
- 継承された過剰権限: エージェントはユーザーの全アクセス権限を引き継ぐ。長年使われていない休眠権限も例外ではない
- 共有サービスアカウントとAPIキー: どのエージェントがどのアクションを取ったか追跡できない
- 目的を超えた持続的アクセス: 廃止されたツール用に発行されたサービスアカウントが、数年後も広範な読み取りアクセスを保持し続けるケースがある
- 未把握のエージェント: 存在を把握していないエージェントのアクセスはスコープできない
OWASPのGenAIセキュリティプロジェクトはLLMの重大リスクの第6位として「過剰なエージェンシー(Excessive Agency)」を挙げており、その根本原因として「過剰な機能・過剰な権限・過剰な自律性」を指摘している。
実装の4つのコントロール
記事では、エージェントを制御するための4つのベストプラクティスを示している。
1. エージェントごとに固有のIDと責任者を割り当てる
共有トークンや使い回しの認証情報では、エージェント間の行動を区別できない。**MCP(Model Context Protocol)**サーバーでは、共有トークンではなくエージェントごとの認証を強制し、長期セッションでは継続的な再認証を要求すべきだとしている。MCPはAnthropicが策定したオープンプロトコルで、AIエージェントが外部ツールやデータソースと標準化された方法で連携するための仕様だ。現在はClaude以外の主要なLLMフレームワークにも採用が広がっている。
エージェント自体は説明責任を持てないため、名前のある人間のオーナーが必要だ。そのオーナーがスコープを承認し、エージェントの行動に責任を負う。
2. タスク単位でアクセスをスコープし、期限を設ける
OWASPのAIエージェントセキュリティチートシートは「特定タスクに必要な最小限のツールのみを付与し、ツールごとに権限をスコープせよ」と明示している。エフェメラルアクセス(一時的なアクセス)が原則で、タスク終了と同時に権限も失効させる。
要約エージェントであれば、特定アカウントのレコードへの読み取りアクセスで十分だ。顧客データベース全体への書き込みアクセスは不要だ。
3. ランタイムで最小権限を強制する
静的な権限設定だけでは、エージェントが自分の権限を昇格させたり、本来触れるべきでないデータにアクセスしたりするケースを防げない。
インテントベースのアクセス制御(IBAC)は、エージェントが依頼された内容と実際にアクセスしようとしているデータを比較する。ユーザーが「特定の顧客アカウントを要約して」と依頼したのに、エージェントがより広い範囲のレコードを取得しようとした場合、その逸脱を検知して人間の承認を求めることができる。
4. 高影響アクションに人間の承認を要求する
承認が必要なアクションの候補として記事が挙げているのは、データ削除、権限変更、ロール・グラントの作成、機密レコードのエクスポート、外部宛先へのデータ送信などだ。ただし「承認セットを小さく保ってエージェントの実用性を維持する」ことも強調している。
実装の6ステップ
記事はチェックリストではなくシーケンスとして、以下の順序で実装するよう説明している。
- 全エージェントを発見・棚卸しする(未承認のものを含む)
- 各エージェントのIDが到達できるデータをマッピングする
- 固有のIDと責任者を割り当て、共有サービスアカウントを廃止する
- 過剰・陳腐化した権限を削除し、自動化する
- タスク単位でアクセスをスコープし、時間制限を設け、高影響アクションをゲートする
- ランタイムで監視し、継続的に再認証し、失効テストを行う
やりがちな失敗
記事では5つのミスが警告されている。そのうち特に注意が必要な2点を以下に挙げる(残り3点については元記事を参照されたい)。
- ログを「ガバナンス」と混同する: ログは記録するが止めない。コンテキストのない監視は、正常と脅威を区別できない
- AIレイヤーは保護したがデータを保護しない: 完全に認可されたエージェントが数百万件の顧客レコードに到達できるなら、そのデータはそもそも過剰に露出している
FBI・NSAも最小権限を推奨
FBI・NSAを含む多国間機関が共同で策定したAIシステムの安全な展開ガイダンスは、「最小権限と多層防御の概念を採用し、厳格なアクセス制御とAPIセキュリティを適用せよ」と明記している。政府レベルでも、エージェントの権限管理は優先課題と位置づけられている。
プロビジョニング時のスコープ設定は出発点にすぎない。ランタイムでの強制、高影響アクションへの人間承認、エージェントが到達できるデータの継続的な最適化——この三つが揃って初めて最小権限が機能する。
詳細はLeast Privilege for AI Agents: A Practical Guide for Security Leadersを参照していただきたい。