10月17日、Karl Weinmeisterが「How I automate 95% of my video workflow with AI coding agents」と題した記事を公開した。AIコーディングエージェントを使って動画制作ワークフローの95%を自動化し、残り5%だけを手作業で仕上げるハイブリッドパイプラインの構築方法について詳しく紹介されている。
動画制作の自動化には長らく二択しかなかった。ワンショットで動画ファイルを吐き出すAI生成ツールを使うか、Remotionのようなコードファーストフレームワークでプログラマティックに組み立てるかだ。前者はカット単位の修正が効かず、後者はタイミング調整のたびにタイムスタンプを書き換えて再レンダリングする羽目になる。
Karl Weinmeisterが作ったのはその中間点だ。コーディングエージェントにボイスオーバーの合成、字幕アニメーション生成、リテイクのカット、マルチトラックタイムラインの初期組み立てを任せ、最後の5%だけ人間がデスクトップエディタで仕上げる。
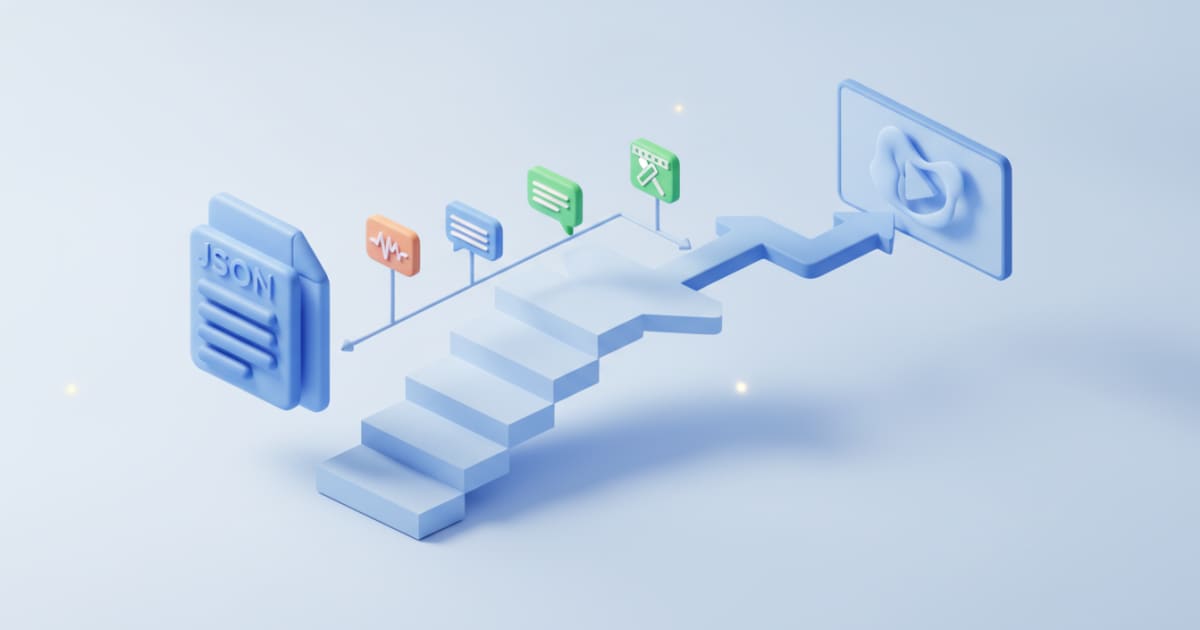
タイムラインの正体は「ただのJSON」
このアプローチの核心は、デスクトップビデオエディタのプロジェクトファイルが実は構造化テキストであることを利用している点だ。プロジェクトファイルは基本的に、メディアファイルへのパスを列挙した materials リストと、各クリップの開始・終了位置を定義した tracks リストで構成される。
タイムラインがディスク上のプレーンなJSONなら、コーディングエージェントがそれを書ける。
ただし、エージェントに生のJSONを直接書かせるのは危険だ。5分の動画プロジェクトは数千行に及ぶクロスリファレンスされたIDとタイムスタンプの塊になり、クリップのdurationがソースファイルの実尺を超えるだけでエディタがプロジェクトを破損扱いする。
そこでKarlが採用したのが、CapCutの非公式オープンソースCLIツール capcut-cli だ。エージェントは以下のような簡潔な spec.json を生成し、CLIがそれを実際のメディアファイルと照合しながらプロジェクトをビルドする。
{
  "name": "AI Video CapCut Walkthrough",
  "width": 1920,
  "height": 1080,
  "fps": 30,
  "tracks": [
    {
      "type": "video",
      "name": "main-visuals",
      "items": [
        {
          "ref": "aroll_intro",
          "path": "assets/talking-head.mov",
          "start": 0.0,
          "duration": 45.9,
          "type": "video"
        }
      ]
    },
    {
      "type": "video",
      "name": "broll-overlays",
      "items": [
        {
          "ref": "three_ways_diagram",
          "path": "assets/nanobanana/01_three_ways_comparison.png",
          "start": 28.8,
          "duration": 9.8,
          "type": "photo"
        }
      ]
    }
  ]
}
ビルドコマンドは以下の通り。--template auto で既存のCapCutドラフトからプロジェクト形式をクローンするため、バージョン互換性の問題を回避できる。
capcut compile spec.json --template auto --check -H
capcut compile spec.json --template auto --drafts "$HOME/Movies/CapCut/User Data/Projects/com.lveditor.draft"
capcut lint "$HOME/Movies/CapCut/User Data/Projects/com.lveditor.draft/AI Video CapCut Walkthrough" -H
ボイスオーバーの自動化:リテイクカットと音声合成
音声面では2つの自動化が走る。
カメラ収録した場合、エージェントが capcut detect-silence と capcut detect-retakes を実行し、無音区間と繰り返しテイクを検出して「残すべき区間」だけを spec.json に組み込む。撮影中は気にせず何度でも撮り直せる。
既存のブログ記事から動画を作る場合(あるいは編集中に1文変更したくてマイクを出したくない場合)は、gemini-3.8-flash-tts モデルの音声合成機能を使う。元記事によれば、Google AI Studioで約20秒の自分の声を録音すると音声IDが発行され、任意のスクリプトをその声のスタイルで読み上げさせられる。テキスト中に <short pause> のような指示を埋め込んでポーズや話し方も制御できる。
※gemini-3.8-flash-tts の型番および音声ID発行フローの詳細はGemini API公式ドキュメントで最新情報を確認されたい。
response = client.models.generate_content(
    model="gemini-3.8-flash-tts",
    contents=[{
        "role": "user",
        "parts": [{
            "text": (
                "When you load skills into an AI coding agent, are you making it "
                "smarter, or just burning tokens on prompt bloat? <short pause> "
                "I ran 72 isolated sandbox trials to find out."
            ),
            "speech_metadata": {
                "style": "warm, conversational, and direct"
            },
        }]
    }],
    ...
)
単語単位で同期するアニメーション字幕
ボイスオーバーが完成したら、HyperFrames(HeyGen社が公開しているオープンソースの動画処理ライブラリ)で文字起こしを行い、単語レベルのタイムスタンプを取得する。
npx hyperframes transcribe assets/narration-gemini.wav -o assets/transcript.json
このタイムスタンプを使って、話された単語にオレンジのアンダーラインをアニメーションで重ねる字幕オーバーレイを生成する。長い技術用語が画面からはみ出さないよう、オフスクリーンの <canvas> でテキスト幅を事前計測してフォントサイズを自動調整する仕組みも入っている。レンダリング前には npx hyperframes check で重なりがないか、WCAG(アクセシビリティのコントラスト基準)をパスするかを自動検証する。
再現性を担保する「Agent Skill」
一度完成したパイプラインは「Agent Skill」としてパッケージングする。Markdownの手順書とヘルパースクリプトをフォルダにまとめたもので、エージェントが次回以降自動的に参照する。スキルは以下の4点をカバーする。
- ボイスオーバー→文字起こし→グラフィック→タイムライン組み立ての順序
capcut-cliとHyperFramesのCLIコマンドと入力スキーマframe.mdで定義した色・タイポグラフィのデザインルール- クリップ尺とテキストコントラストのプリフライトチェック
スキルはプレーンなMarkdownとスクリプトで構成されるため、Claude Codeをはじめとする各種コーディングエージェントで共通して使える。元記事ではGoogle Antigravityというコーディングエージェント環境への対応も言及されているが、執筆時点(2026年10月)では国内での正式サービス状況について公式情報が限られるため、詳細は元記事を参照されたい。CapCut以外のエディタを使う場合は、OpenTimelineIO(.otio形式)を介した同様のアプローチが使えるとKarlは述べている。
詳細はHow I automate 95% of my video workflow with AI coding agentsを参照していただきたい。