10月19日、Meta Engineeringが「The Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Do」と題した記事を公開した。この記事では、AIエージェントのオーケストレーター(調整役)を意図的に「薄く」保つことで信頼性と効率を向上させたアーキテクチャの設計思想と実践知見について詳しく紹介されている。
「賢いエージェント1体」はなぜ壊れるのか
MetaはAIエージェントを使って、社内の推薦システム向けデータカラムのオンボーディング(新規登録・設定作業)を自動化しようとしていた。このプロセスは3つのコードリポジトリ、3つのプログラミング言語、最大6段階のパイプラインステージにまたがる複雑な作業だ。
最初のアプローチは「1体の賢いエージェントに全知識を持たせる」というものだった。設定スキーマ、コード生成ルール、パイプラインのルーティングロジック、10以上のデータソースのバリデーション要件——これら全てを1つのエージェントに渡した。
デモでは動いた。本番環境でハルシネーション(幻覚・誤回答)が頻発した。
原因はコンテキストの過負荷だ。ある閾値を超えると、知識を追加するほど精度が下がる。エージェントは異なるサブシステムの命名規則を混同し、データソースAのコード生成パターンをデータソースBに誤適用した。
Mount Sinaiによるプレプリント論文「Orchestration of Multi-Agent Systems for Clinical Reasoning」によれば、オーケストレーション済みのマルチエージェントシステムは80タスクのバッチで65.3%の精度を維持するのに対し、単一エージェントは16.6%まで低下したという。その原因として論文はタスクの分離によるコンテキスト干渉の防止を挙げている。Metaが経験したのはその逆——1体のエージェントが自分の知識に溺れる状態だった。
代替の単一エージェントアプローチも評価したが、成功率は手動のプロンプトエンジニアリングありで70〜80%、なしでは10〜20%に落ちた。これはプロンプトの問題ではなく、アーキテクチャの問題だった。
「薄いオーケストレーター」の設計
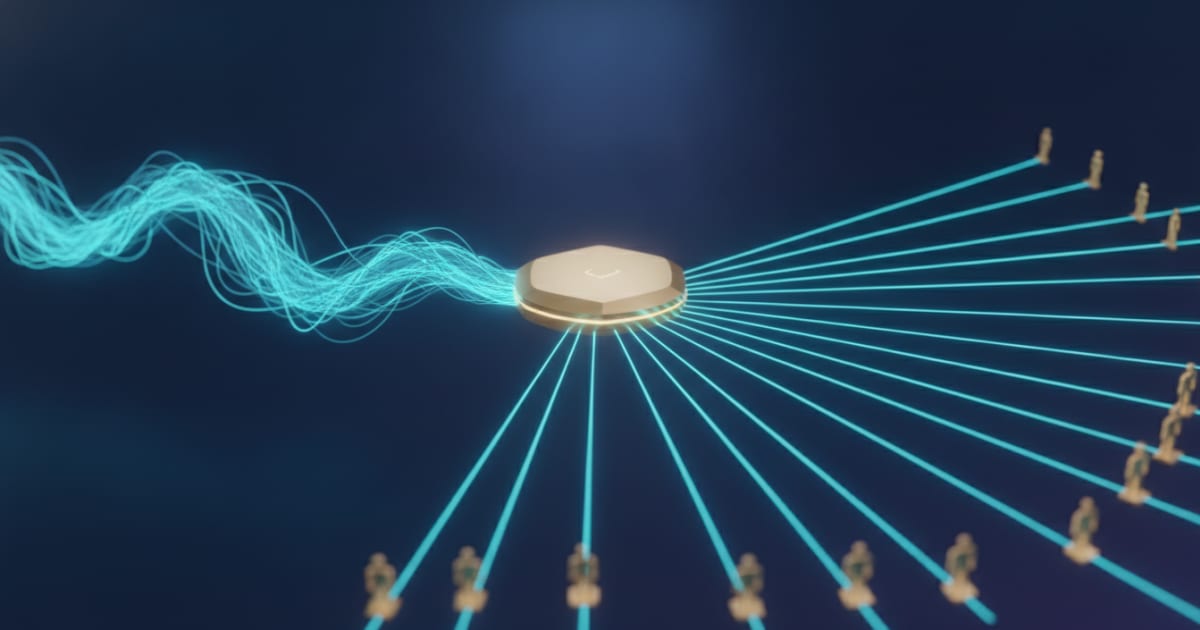
Metaが採用した解決策がThin Orchestrator(薄いオーケストレーター)パターンだ。システムを2層に分割する。
このパターンは、LangGraphやAutoGenといった既存のマルチエージェントフレームワークとも思想的に通じる部分がある。ただし、それらがエージェント間の動的な対話や汎用的な協調を重視するのに対し、Thin Orchestratorはオーケストレーター自体をLLMから切り離し、決定論的なステートマシンとして実装する点が特徴的だ。ルーティング判断をLLMに委ねないという設計の徹底ぶりは、信頼性を最優先とする本番システムならではの判断といえる。
※編集部の考察:上記のフレームワーク比較はMeta Engineering元記事には記載されておらず、編集部が文脈理解を補う目的で付記したものだ。
第1層:決定論的なオーケストレーター
ドメイン(専門領域)の判断を一切行わない。やることはインテント(意図)の分類、必要フィールドの収集、信頼性チェック、そして適切な専門エージェントへの委任のみ。コードの生成も、設定の判断も、コードベースへのアクセスも行わない。純粋なルーターだ。
第2層:14体の専門サブエージェント
それぞれが独立したコンテキストを持つドメインの専門家。スキーマ管理エージェントは設定レジストリだけを知り、データ投入エージェントは10のデータソースのコード生成だけを知る。どのエージェントも全体像を知らない。それが意図的な設計だ。
オーケストレーターは全リクエストに対して固定の7ステップで動く:
- 対象サブエージェントの指示ファイルを読む
- 対象がすでに存在するか確認(重複防止)
- ユーザーから必要フィールドを収集
- 推論できる情報(リポジトリ種別、既存設定)を自動検出
- 信頼性ゲートチェック(アクティブな警告やレビュー要否の確認)
- サブエージェントに全コンテキストを渡して委任
- 結果を処理し、エラーを表面化・成功を確認
ステップ1〜5と7は決定論的(LLMを使わない)。LLMが関与するのはステップ6のみ、かつ対象ドメインの知識だけがロードされた隔離されたサブエージェントの内部でのみだ。
新ユースケース追加 = 新エージェント不要
もう一つの重要な設計判断が「ワークフローテンプレート」の導入だ。
(上図はMeta Engineering元記事に掲載されているThin Orchestratorのワークフロー概念図。オーケストレーターがフェーズの順序をテンプレートで管理し、各サブエージェントに委任する構造を示している)
オーケストレーターはフェーズの順序をワークフローテンプレートで定義する。決定論的なステートマシンがLLMの意思決定の空間を制約する仕組みだ。
- カラムオンボーディング: スキーマ → バリデーション → データ投入 → テスト
- イベントオンボーディング: スキーマ → データ投入 → バリデーション → テスト → イベント処理
- パイプライン移行: アセスメント → 計画 → データ投入 → バリデーション → モニタリング
14体のサブエージェントを異なる順序で呼び出すだけで、全く新しいユースケースに対応できる。パイプライン移行のサポート追加時、新しいエージェントのコードはゼロ行。ワークフローテンプレートを1つ書いただけで本番対応できた。
知識ファイルはビルド時に埋め込まず、サブエージェント実行時にオンデマンドでロードする。25以上の知識ファイルをドメインごとに管理しており、ファイルを更新すれば次のセッションから自動的に最新版が使われる。オーケストレーターの変更は不要だ。
成果
(上図はMeta Engineering元記事に掲載されている成果比較グラフ。作業時間の短縮とマージ率の改善が示されている)
新カラムの設定準備にかかる時間が手作業で3〜4日、初期の設定駆動システムで約1日だったのが、Thin Orchestratorシステムでは1時間以内に短縮された。
また、元記事によれば、システムが生成した変更の約3分の2は、人間による大きな編集なしにそのままマージされている。
なぜ「重いオーケストレーター」は失敗するのか
Thin Orchestratorが機能する理由は、アーキテクチャの境界を計算の境界と一致させている点にある。
- 決定論的な判断は決定論的なままにする。「どのサブエージェントが担当するか」はルーティングの決定であり、推論タスクではない。LLMに任せてはいけない。
- コンテキスト隔離がクロスコンタミネーション(知識の混濁)を防ぐ。データソースAのエージェントはデータソースBのパターンを見ない。物理的に誤答できない。
- 障害が封じ込められる。サブエージェントが失敗しても、オーケストレーターの状態や他のサブエージェントのコンテキストを汚染しない。
- 各層が独立して改善できる。より良いモデルに切り替えれば14体全てが同時に恩恵を受ける。知識ファイルの更新は即時反映される。
重いオーケストレーターの失敗モードは連鎖する——ハルシネーションが発生すると、誤ったエージェントへのルーティング、誤ったフィールドの収集、信頼性チェックのスキップが同時に起きる。Thin Orchestratorはルーティングと信頼性チェックをLLMに依存しないため、そもそもハルシネーションが起きる余地がない。
記事の最後でMeta Engineeringはこの原則を一文でまとめている。「最も重要なコンポーネントは、最も仕事をしないコンポーネントだ。オーケストレーターを薄く、スペシャリストを深く保て」。
詳細はThe Thin Orchestrator: How We Made Our AI Agents More Reliable by Giving the Router Less to Doを参照していただきたい。