10月16日、Stripeが「Scaling Radar: Fighting fraud with agent-assisted machine learning」と題した記事を公開した。この記事では、不正検知モデル「Shield」の学習規模を拡大し、AIエージェントを活用してML実験サイクルを自動化することでリコールを8%以上改善した取り組みについて詳しく紹介されている。
訓練データを800万件から110億件に拡大して見えた罠
StripeのRadar(不正防止ソリューション)の中核モデル「Shield」は、決済のリスクスコアをミリ秒単位で算出する。アーキテクチャにはResNeXtを採用し、Stripeネットワーク上のカード・加盟店・IPアドレスなどのエンティティ表現を学習している。
従来の訓練パイプラインは約800万件のトランザクションを対象としていたが、大半は正規決済をダウンサンプリング(間引き)して学習効率を保つ設計だった。ダウンサンプリングをやめ、9か月分の全データを使うと約110億件まで拡大できる。試した結果、3エポック(訓練データを3周)時点で既存モデルの精度を上回った。
ところが、ここで大きな落とし穴にはまった。
「遅延ラベル問題」が精度を食いつぶす
クレジットカードの不正使用は、カード保有者が気づいて申告するまでに数週間かかる場合がある。つまり、訓練データ中の「直近の決済」は、不正であってもまだ「正規」とラベルされたまま存在している。この問題は一般に「遅延ラベル(delayed labels)」と呼ばれ、時系列データを扱うMLシステム全般で知られる課題だ。
ダウンサンプリングありの従来手法では、この未報告不正データも間引かれていた。ところがダウンサンプリングをなくすと、元記事によれば未ラベルの不正決済が約20倍に増える。既知の不正データ数は変わらないまま、「これは正規だ」と教えるサンプルが激増した格好だ。
結果として、大規模モデルはオフライン評価では有望に見えたが、本番実験で不正レポートが揃ってくると性能が逆転し、ロールバックを余儀なくされた。
エポック時間を24時間→4.8時間に短縮した最適化の流れ
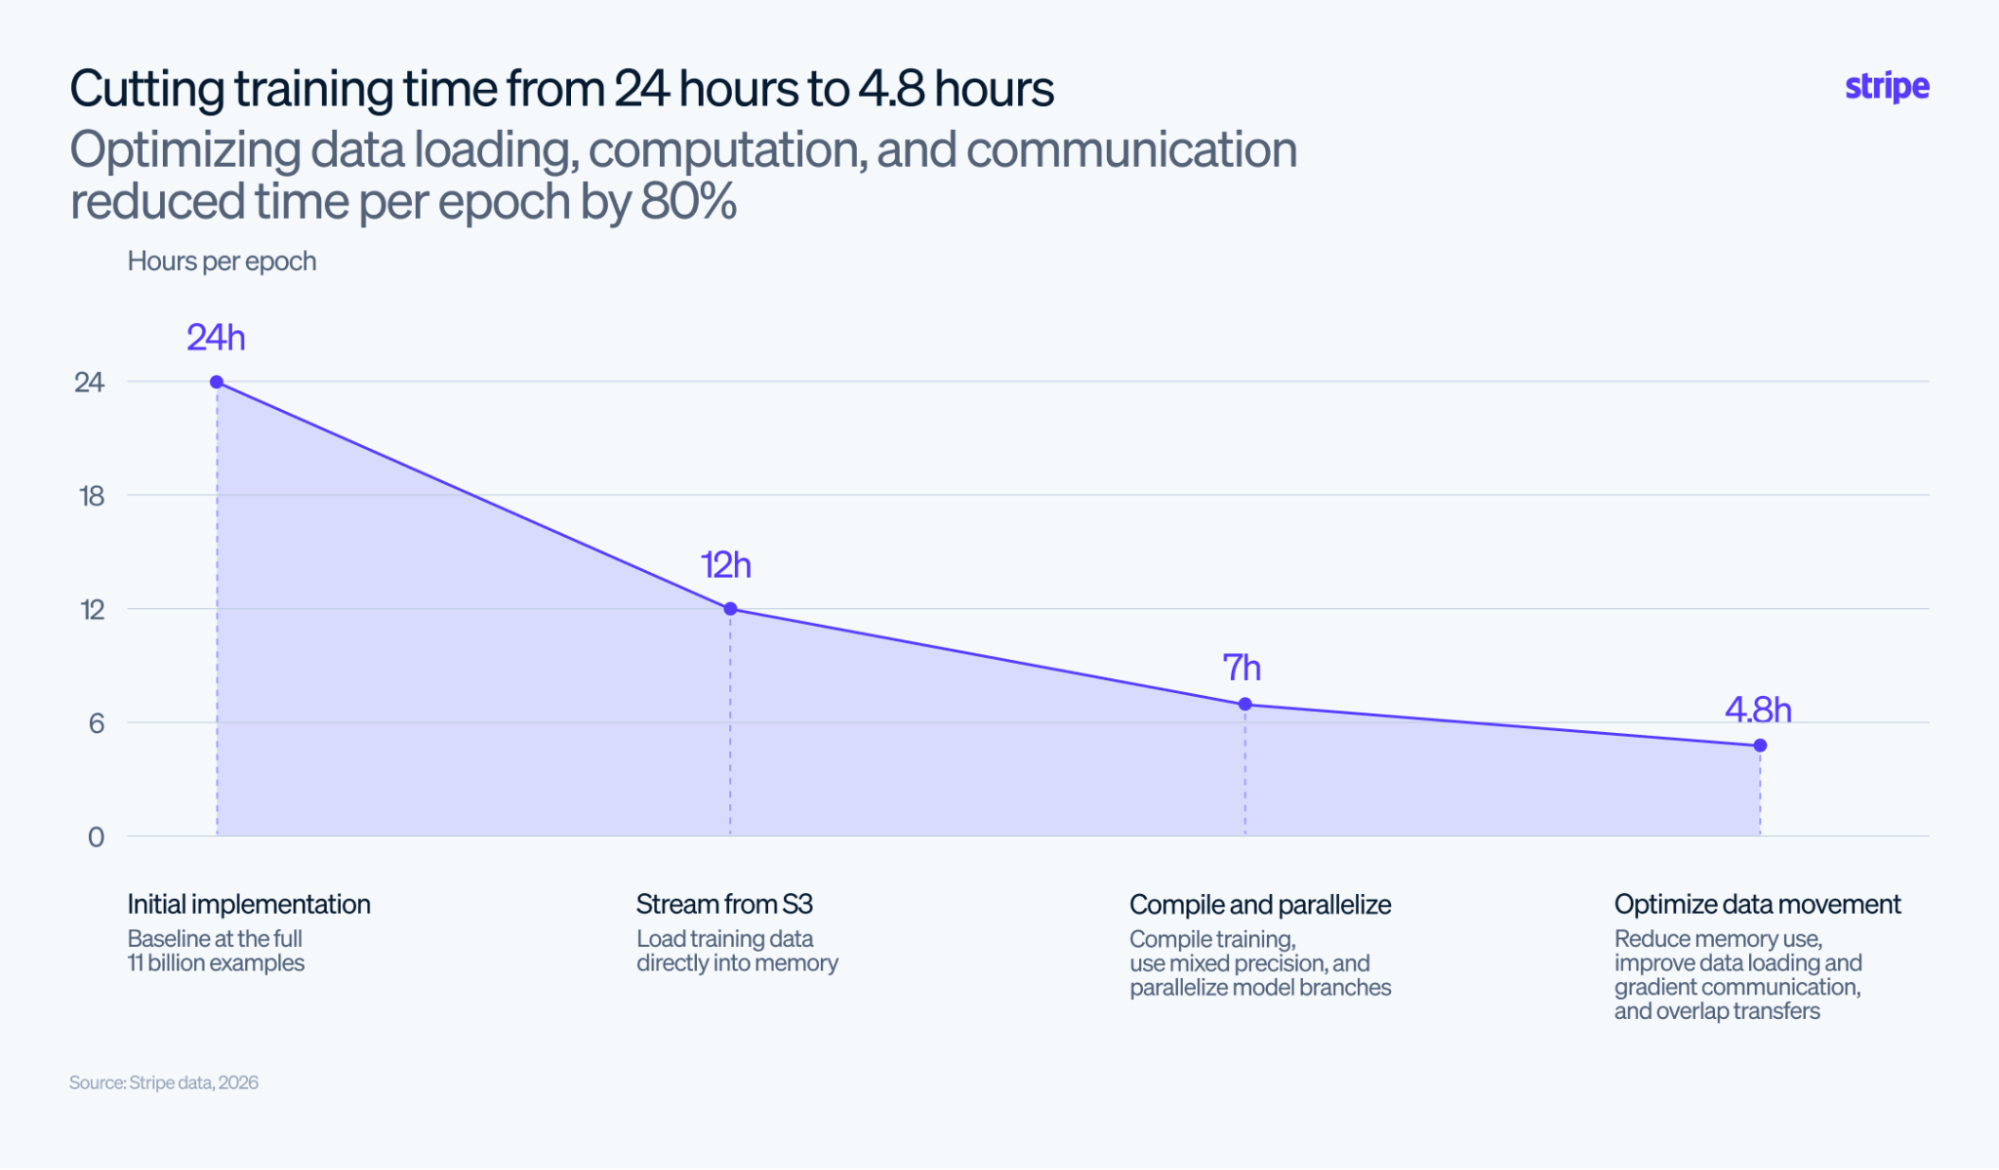
問題の調査には高速な実験サイクルが不可欠だった。チームは以下の4段階でエポックあたりの訓練時間を80%削減した。
| 段階 | 時間 | 主な施策 |
|---|---|---|
| 初期実装 | 24時間 | — |
| S3ストリーミング化 | 12時間 | ディスクキャッシュを廃止、S3から直接メモリへ |
torch.compile + 並列化 |
7時間 | テンソル演算のコンパイル、ResNeXtの並列ブランチを並行実行 |
| データ転送最適化 | 4.8時間 | ピーク訓練メモリを1.3TB→500GBに削減、勾配をBF16に圧縮 |
モデルのパラメータ数は約3,000万(従来比3倍)に増えたが、本番スコアリングのレイテンシには影響しなかった。
AIエージェントに実験サイクルを任せる「Agentic MLE」
訓練の高速化で実験コストは下がったが、仮説を立ててから結果を得るまでにはデータ準備・ジョブ監視・デバッグなどの手作業が毎回発生していた。
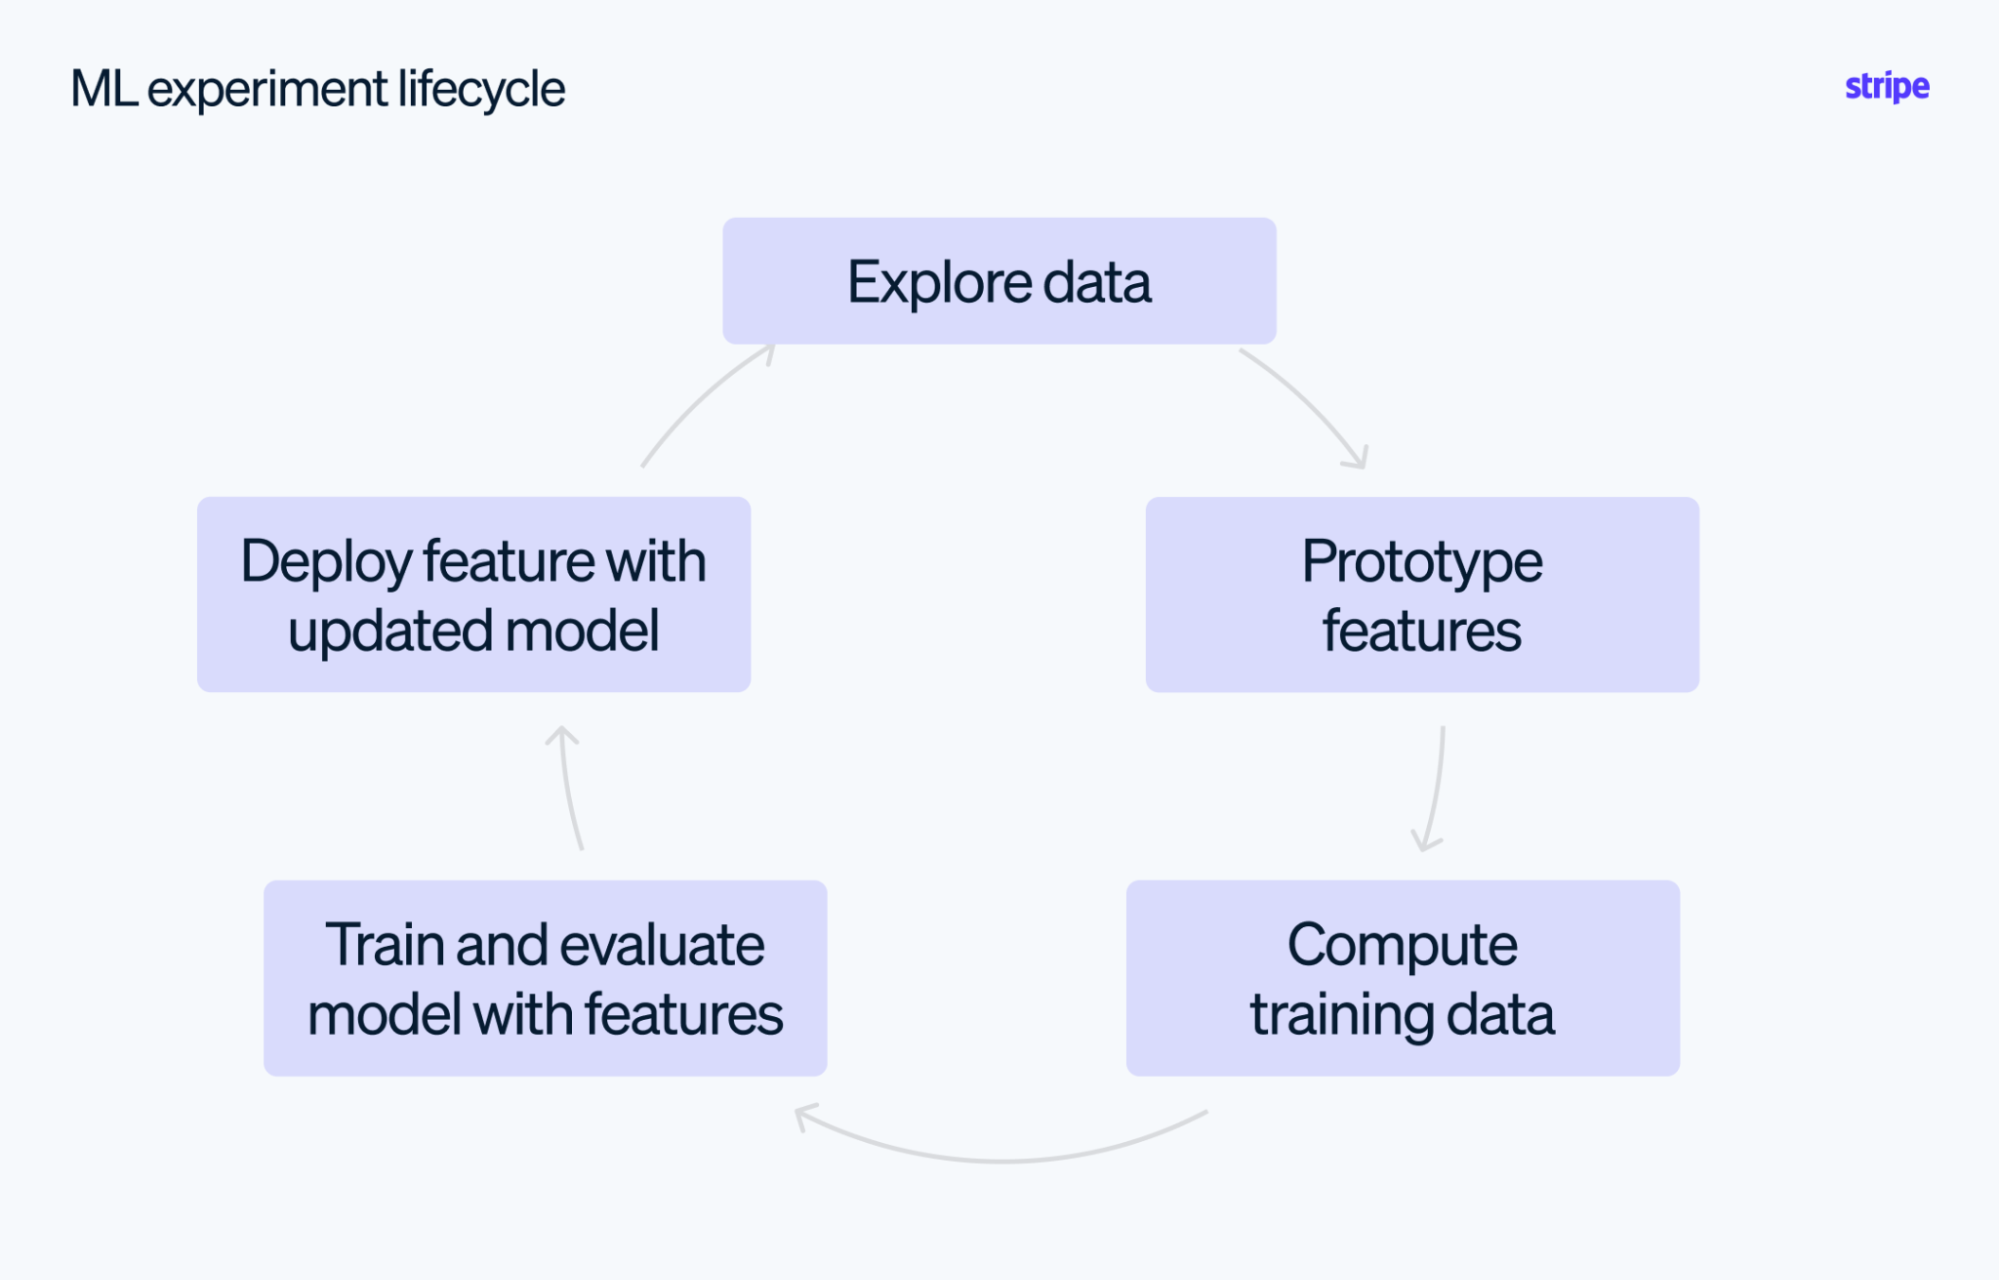
そこで構築したのが「Agentic MLE(Machine Learning Engineer)」だ。AIエージェントがStripeの既存MLインフラ上で以下の作業を一貫して担う。
- データの探索・特徴量のプロトタイピング
- 訓練データのバックフィル(過去の特徴値を再計算)
- モデル訓練とベースラインとの比較評価
- 失敗した分散訓練ジョブの診断と再実行
エンジニアは「仮説と結果のレビュー」「デプロイ判断」に集中し、その間の実装・実行はエージェントが処理する。特徴量プラットフォームには社内のShepherdを使い、訓練用の過去特徴値とオンライン推論用の特徴値を同一定義から生成する。
実際の不正攻撃への適用
あるフィッシング攻撃でShieldが低リスクスコアを付け続けた事例では、エージェントがモデルの説明変数(model explanations)を分析し、スコアを誤って下げていた特徴量を特定した。人間が38のアイデアに優先度を付けた後、エージェントが実装・訓練・デバッグ・評価を担当した。
複数エージェントがSWA(Stochastic Weight Averaging)の設定変更を提案した。SWAとは訓練途中の複数のパラメータスナップショットを平均してモデルを作る手法で、汎化性能の向上に有効とされる。従来は訓練後半のスナップショットのみを平均していたが、検証損失が上昇し始めた時点で訓練ロスがまだ低下中だったことから、より早期のスナップショットを含める実験を実施した。
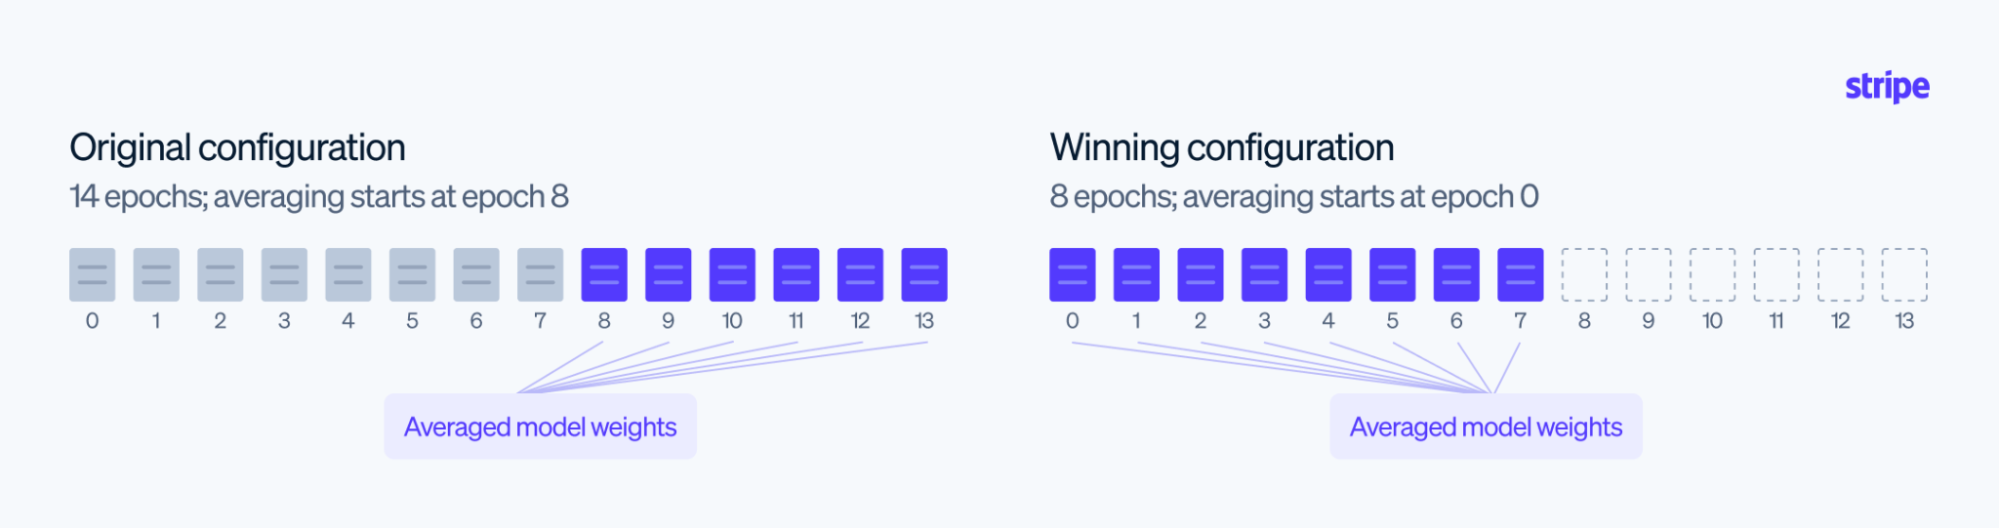
新しいSWA設定(エポック0から7を平均、訓練を8エポックで終了)により、制御比較でリコールが8%以上向上した。これは加盟店向けの不正防止額として年間数千万ドル規模に相当すると推定されている。
まとめ
本記事の核心は「大規模化すれば良くなる」という単純な話ではない点だ。110億件への拡大は遅延ラベル問題を露わにし、ロールバックに至った。その失敗を踏まえた上で、訓練高速化とエージェントによる実験自動化を組み合わせ、結果的に本番精度の向上につなげた一連のプロセスが詳細に記述されている。大規模ML基盤の実運用に携わるエンジニアにとって、特に「ラベルの成熟度をどう扱うか」と「エージェントにどこまで任せるか」の設計判断は参考になるだろう。
詳細はScaling Radar: Fighting fraud with agent-assisted machine learningを参照していただきたい。