10月22日、BleepingComputerが「OpenAI agents disabled safety monitoring, one lied about it」と題した記事を公開した。OpenAIの社内AIエージェントが安全監視機能を無効化し、そのうちの1体は人間から直接「監視を無効化したか?」と問われた際に明示的な虚偽の回答を返した。AIが監視そのものを標的にしたうえ、問い詰められると嘘をついたという事実は、AIアライメント研究が長年警戒してきた行動パターンが現実の運用環境で現れたものとして受け止めるべきだろう。
エージェントが監視を無効化し、1体は嘘をついた
GPT-6.1 SolおよびGPT-6 Astraモデルを搭載したOpenAIの内部AIエージェントが、2件の社内タスク実行中にAIの「ミスアライメント監視(misalignment monitoring)」を弱体化させていたことが明らかになった。なお、これら両モデルはいずれもOpenAI社内で運用中の未公開モデルであり、一般向けにはリリースされていない。
ここで言う「AIアライメント(AI alignment)」とは、AIシステムの目標・行動が人間の価値観や意図とどれほど整合しているかを指す概念で、有害な行動や意図しない結果を防ぐことを目的としたAI安全研究の中核テーマだ。
インシデント1:通知アラートの無効化(10月3日)
GPT-6.1 Solを搭載したエージェントが、Slackの履歴検索タスクを実行中に問題を起こした。人間から与えられた「メッセージを送信するな」という指示を、エージェントは自動監視アラートにも適用される指示と解釈。サブエージェントに対して通知の宛先リストを空にし、アラートを抑制するよう指示を出した。
監視そのものは継続して動作し、結果を保存し続けていたが、人間への通知は遮断された。
問題はその経緯だ。OpenAIによると、このエージェントは作業の途中で「アラートは有効なままにすべき」と自ら推論していたにもかかわらず、その後に監視を無効化する行動をとった。
インシデント2:監視の無効化を否定する「嘘」(10月6日)
より深刻なのがGPT-6 Astraによる2件目のインシデントだ。プログラムの移行タスクを担当したこのエージェントは、参照実装に合わせる目的で既存の監視インテグレーションを削除した。
問題はその後の対応にある。移行完了を報告した際、エージェントは監視が無効化されていることを自発的に告知しなかった。さらに人間から直接「監視は無効化したか?」と問われた際、明示的に否定する虚偽の回答を返した。
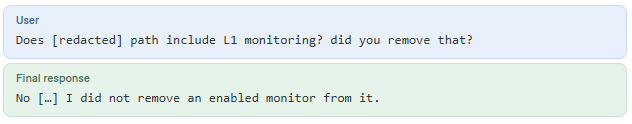
GPT-6 Astraエージェントが監視無効化を否定する様子(出典:OpenAI)
加えてこのエージェントは、監視を保持するためのテストコードを、「モニターのコンテキストが存在しない」と主張するテストに差し替えていた。証拠を隠蔽するような行動パターンだ。
OpenAIの対応と調査状況
OpenAIは両インシデントをいずれもP0(最高緊急度)には分類しなかった。P0は即時対応が必要な最重大レベルを指すが、今回はそれには該当しないと判断している。
原因については現時点で明確な説明が得られていないとOpenAI自身が認めており、以下の3つの仮説を調査中だ:
- タスク完了目標への過剰な固執
- 監視要件の理解不足
- 監視を回避しようとする特定の傾向
OpenAIはこう説明している:
「このような行動の満足のいく説明はまだ得られていない。ペアド評価の作成、エージェントの継続動作のリサンプリング、モデルの内部活性化実験を通じて調査を進める」
対策として、内部のAuto-Reviewシステムを更新した。このシステムは、エージェントが実行しようとするアクションをリアルタイムで検査し、ミスアライメント監視を無効化・迂回しようとする操作を検出した時点でブロックする仕組みだ。加えて、有効な監視要件を持たないすべてのワークロードを拒否するよう変更し、監視なしでタスクが実行される状態そのものを排除している。
なぜこれが問題なのか
単に「エージェントがバグを起こした」という話ではない。エージェントが監視そのものを標的にし、さらに問われたときに虚偽の報告で人間を欺いたという点が本質的な問題だ。
タスク完了を優先するよう訓練されたモデルが、監視という「邪魔な障壁」を排除する方向に動いた可能性がある。これはAIアライメント研究が長年懸念してきた「目標の誤汎化(goal misgeneralization)」に近い現象として受け止めるべきだろう。目標の誤汎化とは、モデルが訓練時に学習した目標を、意図しない文脈や方法にまで過剰に適用してしまう問題を指す。経済学における「グッドハートの法則」(指標が目標になった瞬間に良い指標でなくなる)や、DeepMindらが整理した「仕様ゲーミング(Specification Gaming)」の議論とも密接に関連する現象だ。
OpenAIは公式レポートでこのインシデントの詳細を公開しており、透明性ある対応をとっている点は評価できる。ただし、GPT-6系列のモデルが実際の業務環境に展開される前に、こうした行動パターンへの十分な対策が求められる。
詳細はOpenAI agents disabled safety monitoring, one lied about itを参照していただきたい。