10月23日、n8nが「Self-Hosted LLM vs. Cloud APIs: How to Route Between Them」と題した記事を公開した。「セルフホストの方がコストが下がる」「プライバシーが守られる」という直感は必ずしも正しくなく、実際にはリクエスト量・データの機密性・タスクの複雑さによって最適解が変わる。記事は、その判断軸を整理したうえで、セルフホストLLMとクラウドAPIを同一ワークフロー内でルーティングする実装パターンまでを解説している。
n8nは、ノーベースのワークフロー自動化プラットフォームだ。400以上のサービスと連携でき、AIエージェントの構築やLLMを組み込んだ自動化パイプラインの作成を得意とする。エンジニアから非エンジニアまで幅広いユーザーに使われており、セルフホスト版とクラウド版の両方が提供されている。本記事はそのn8nチームが、LLMの運用設計における実践的な知見をまとめたものだ。
「セルフホストの方が安い」は常に成立しない
LLMをオンプレミスで動かせばコストが下がる——そう思われがちだが、実際にはそう単純ではない。セルフホストにはGPUハードウェアの調達コスト、運用・保守の工数、そして人件費がかかる。損益分岐点(breakeven point)、すなわちセルフホストの総コストがクラウドAPIの従量課金を下回るポイントは、リクエスト量が大きく安定している場合にのみ成立する。リクエストが少ない、または予測しにくい場合はクラウドの方が経済的だ。
記事では実用的なTipsも紹介されている。バッチ処理用途なら、RunPodのようなGPU搭載VPSを必要なときだけ起動する方法が有効だ。処理時だけ課金されるため、データをクラウドAPIに渡さずに済む相対的なプライバシーと、コスト効率を両立できる。
どのオープンウェイトモデルを選ぶか
セルフホストで動かすモデルを「オープンウェイトモデル」と呼ぶ。学習済みのモデルの重みを公開しており、自分のインフラ上でダウンロード・実行できるモデルのことだ(GPT-4のようなクローズドモデルとは対照的)。
記事が推奨するアプローチは、まずOpenRouterなどで複数モデルを試し、タスクを十分にこなせる最小サイズのモデルを選んでからセルフホストに移行するというものだ。モデルサイズが小さいほど必要なVRAMが少なく、推論速度も速い。
以下が記事で紹介されているモデルの一覧だ。最小VRAMはGPUメモリの目安で、これを下回るとシステムメモリやCPUにオフロードされ、パフォーマンスが低下する。
| モデル | パラメータ数 | 最小VRAM目安 | 用途 |
|---|---|---|---|
| Phi-4-mini | 3.8B | 〜8 GB | ハードウェアが限られる環境での軽量用途 |
| Qwen3 8B | 8B | 〜8 GB(8-bit) | チャット・コーディング・多言語対応の汎用モデル |
| Gemma 3 12B | 12B | 〜12–16 GB(量子化時) | 要約・マルチモーダルタスク(テキスト+画像) |
| DeepSeek R1-Distill-Qwen-14B | 14B | 〜12–16 GB(量子化時) | 推論重視タスク |
| Mistral Small 3.1 | 24B | 〜12–16 GB(4-bit量子化) | 関数呼び出し・コーディング・長文処理 |
| Llama 4 Scout | 109B(アクティブ17B) | 〜55–80 GB | 大規模プライベートLLM・大型ドキュメント処理 |
なお、量子化(quantization)とはモデルの重みをより少ないビット数で表現することでメモリ使用量を削減する手法だ。適度な量子化であれば出力品質をほぼ維持できるが、過度な圧縮は数値推論など複雑なタスクに影響が出ることがある。
Llama 4 Scoutの「109B(アクティブ17B)」という表記は、MoE(Mixture of Experts)アーキテクチャに由来する。MoEは全パラメータをすべての推論で使うのではなく、入力ごとに一部の「専門家(Expert)」だけを選択的に活性化する設計だ。総パラメータ数は109Bだが、1回の推論で実際に動くのは17B相当のため、VRAMの消費量をパラメータ総数に比べて大幅に抑えられる。
ローカルとクラウドを使い分けるルーティング戦略
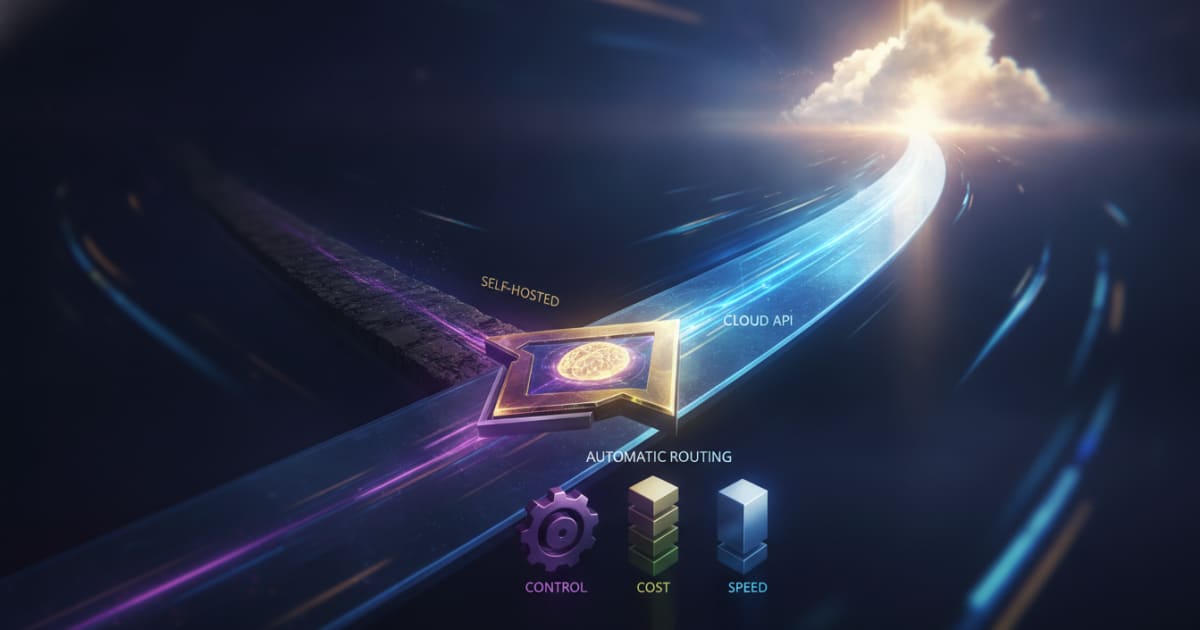
記事の核心は、すべてをセルフホストかクラウドかどちらかに固定するのではなく、ハイブリッド構成でリクエストごとに最適な経路を選ぶという考え方にある。ルーティングの判断基準として記事が挙げているのは以下の3点だ。
- データの機密性: GDPRなどの規制対象データや、契約・社内ポリシーで外部送信が制限されているデータはローカルで処理する。ただし、セルフホストしているだけで自動的にコンプライアンス準拠になるわけではなく、アクセス制御・ログ・ストレージ周りの整備は別途必要だ。
- フロンティアモデルの必要性: 複雑な推論タスクには、クラウドで提供される最新の高性能モデル(フロンティアモデル)を使う方が適している場合がある。
- リクエスト量: 大量かつ安定したリクエストはセルフホストが有利になりやすく、少量・断続的なリクエストはクラウドが向いている。
n8nでルーティングを実装する
このルーティングロジックをアプリケーションごとにハードコードすると、モデルやルールが増えるにつれて管理が難しくなる。記事では、n8nを使った実装方法を紹介している。
基本的な構成は次のとおりだ。
- ローカルパスの接続: OllamaやvLLMで動かしているモデルに対し、Ollama Chat ModelノードでBase URLを指定して接続する。
- クラウドパスの追加: OpenAI Chat ModelノードやAnthropic Chat Modelノードを追加してクラウド経路を用意する。
- ルーティングの実装: 同一エージェント内でモデルを切り替えるならModel Selectorノード、ワークフロー全体を2分岐させるならIfノード、3分岐以上ならSwitchノードを使い分ける。
- 機密データのチェック: クラウドへ送る前に機密性チェックを必ず入れる。エージェントが内容を検査してルーティングを判断する必要がある場合、その検査自体もローカルで実行する。
記事では、Webhookで受け取ったペイロードをリクエスト元と複雑さに応じてローカル・クラウドに振り分けるサンプルワークフローも図示されている。クラウド側では、小型の分類モデルが先にリクエストの複雑さを判定し、AIエージェントが最適なLLMを選ぶ構成だ。
セルフホストLLMとクラウドAPIのどちらが「正解」かは一律には決まらない。記事が示すのは、両者を使い分ける判断軸と、その切り替えを運用可能な形で実装する方法だ。
詳細はSelf-Hosted LLM vs. Cloud APIs: How to Route Between Themを参照していただきたい。