10月23日、Techstrong AIが「The Shift from Prompt Engineering to Context Engineering in Enterprise AI」と題した記事を公開した。エンタープライズAIの実装が成熟するにつれ、現場では「プロンプトエンジニアリング」という概念が限界を迎えつつある。代わりに台頭しているのが「コンテキストエンジニアリング」だ。本記事はその背景・定義・実務上の変化を論じている。
プロンプトエンジニアリングの限界
「プロンプトエンジニアリング」とは、LLM(大規模言語モデル)に与える指示文(プロンプト)を工夫することで、より望ましい出力を引き出す技術・手法の総称だ。ChatGPTの登場以降、この概念は急速に普及し、「プロンプトエンジニア」という職種まで生まれた。
しかし企業での本格導入が進むにつれ、プロンプトの書き方だけでは対処しきれない課題が浮き彫りになってきた。業務システムとの連携、社内ナレッジベースの参照、マルチステップのタスク処理——こうした実務要件に応えるには、「何を指示するか」だけでなく、「モデルが判断を下す際に参照できる情報全体をどう設計するか」という視点が不可欠になる。プロンプト単体の最適化は、あくまでその一部に過ぎない。
コンテキストエンジニアリングとは何か
コンテキストエンジニアリングとは、AIモデルが推論・応答する際に利用可能な「文脈情報」の全体を意図的に設計・管理する実践を指す。具体的には以下のような要素が含まれる。
- システムプロンプト:モデルの役割・制約・トーンを規定する初期指示
- 会話履歴:過去のやり取りをどこまで・どのように保持・圧縮するか
- 外部知識の注入:RAG(Retrieval-Augmented Generation)などを通じた社内文書・DBの動的取り込み
- ツール定義:関数呼び出し(Function Calling)やAPIとの接続仕様
- 出力フォーマット指示:後続システムが処理しやすい構造化出力の設計
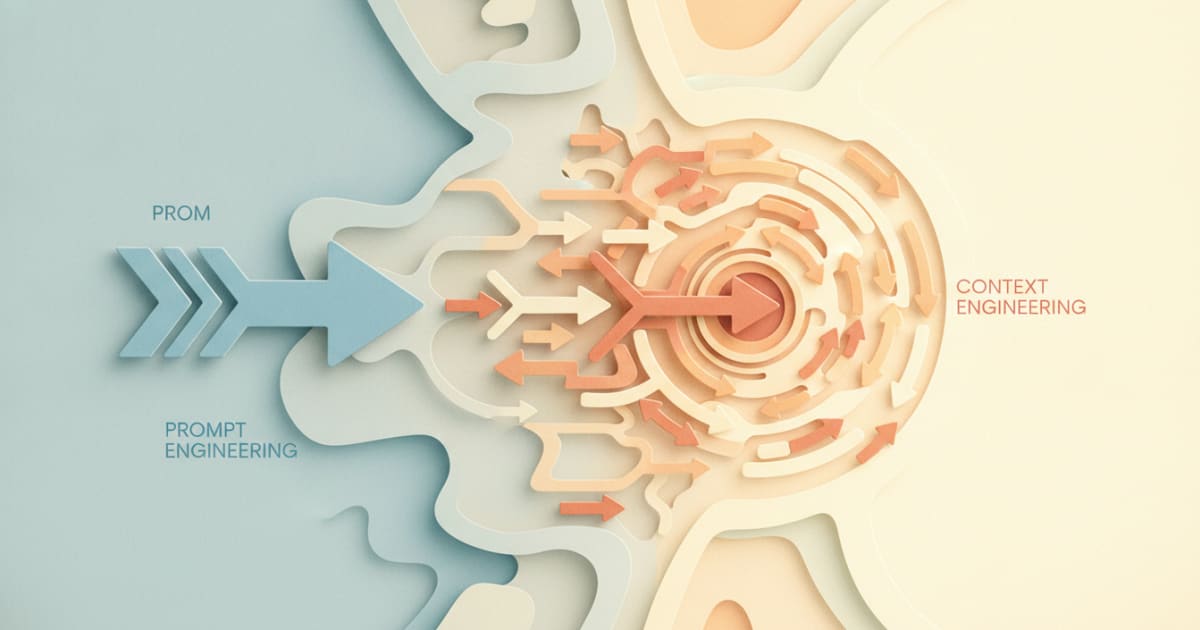
プロンプトエンジニアリングが「入力欄に何を書くか」という局所的な問題を扱うのに対し、コンテキストエンジニアリングはモデルのコンテキストウィンドウ全体をシステムとして設計する、より上位の概念だと言える。
エンタープライズ現場での具体的な変化
記事が注目するのは、この概念の転換が企業の開発・運用体制にどのような実務的変化をもたらしているかという点だ。
従来のプロンプトエンジニアリング中心のアプローチでは、AIへの指示をチューニングする作業は往々にして個人の経験とノウハウに依存していた。しかしコンテキストエンジニアリングの観点では、コンテキスト設計はソフトウェアアーキテクチャの一部として扱われる。バージョン管理・テスト・モニタリングの対象となり、エンジニアリングチーム全体で管理する成果物になる。
また、RAGパイプラインやベクトルデータベース(pgvector、Pineconeなど)の整備、LangChainやLlamaIndexといったオーケストレーションフレームワークの採用も、コンテキストエンジニアリングの実装基盤として位置づけられる。「どのドキュメントをいつ・どのようにモデルに見せるか」という設計判断が、出力品質を大きく左右するからだ。
さらに、エンタープライズ特有の課題としてセキュリティとコンテキスト汚染(context poisoning)のリスクも取り上げられている。悪意ある入力や不適切なデータがコンテキストに混入した場合、モデルの挙動が意図せず変質する危険があるためだ。コンテキストエンジニアリングはこうしたリスク管理の観点からも重要性を増している。
「エンジニアリング」としての成熟
この概念の転換は、AIアプリケーション開発全体の成熟を象徴している。初期のAIブームでは「良いプロンプトさえ書ければ何でもできる」という期待が先行したが、実際の業務システムへの組み込みが進むにつれ、信頼性・再現性・保守性を担保するための設計規律が求められるようになった。
コンテキストエンジニアリングは、その要請に応えるための概念的枠組みだ。プロンプトの書き方というスキルから、情報アーキテクチャの設計というエンジニアリング領域への移行——これが記事の核心的なメッセージである。
※編集部の考察:日本国内でも、RAGを用いた社内チャットボットや業務自動化エージェントの導入事例が急増している。「プロンプトを改善しても精度が上がらない」という壁に当たった開発チームにとって、コンテキストエンジニアリングという視座の転換は実践的な突破口になり得る。
詳細はThe Shift from Prompt Engineering to Context Engineering in Enterprise AIを参照していただきたい。