10月26日、Sergio De Simoneが「Google ML Drift Accelerates On-Device AI Inference Across Diverse GPUs」と題した記事を公開した。この記事では、GoogleがオープンソースのクロスプラットフォームGPUコンピュートエンジン「ML Drift」をApache 2.0ライセンスで公開したことについて詳しく紹介されている。
TFLite GPUデリゲートの後継として登場
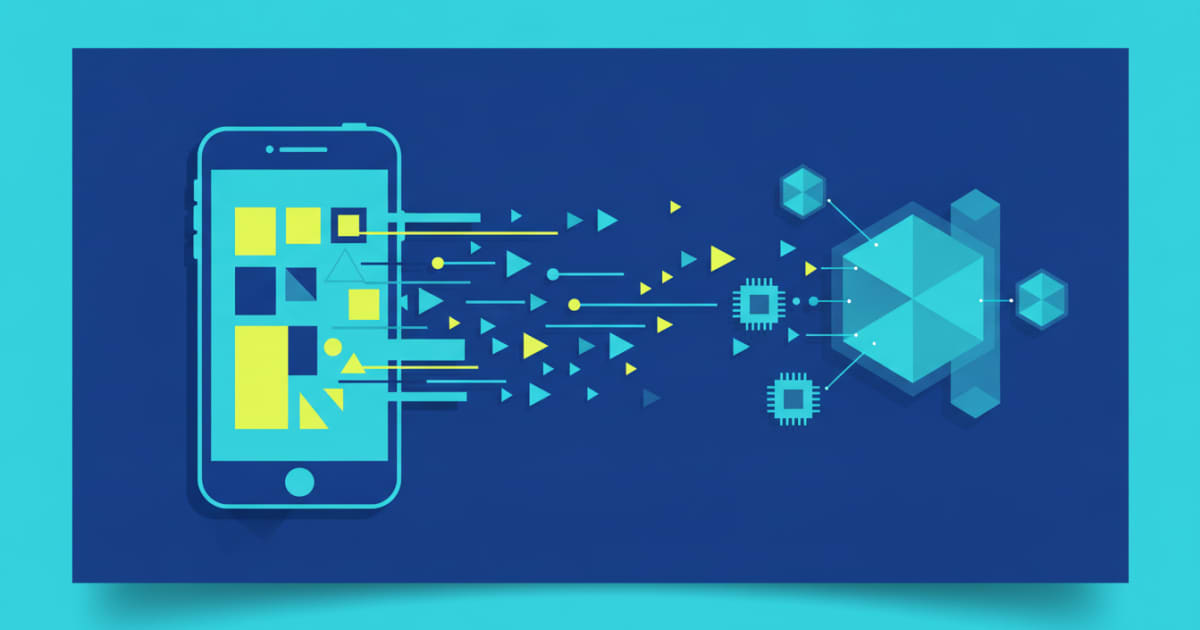
ML Driftは、エッジデバイス上でのAI・機械学習推論を対象としたGPUコンピュートエンジンだ。GoogleはすでにLiteRT(旧TensorFlow Lite)の内部エンジンとしてML Driftを採用しており、今回それをオープンソース化した。
なお、TensorFlow LiteがLiteRTへブランド変更された経緯については、2023年のGoogle I/Oで発表されたオンデバイス推論戦略の再編が背景にある。Googleはモバイル・エッジ推論のランタイムをLiteRTとして統合し、バックエンドエンジンをTFLite GPUデリゲートからML Driftへ刷新することで、多様なハードウェアへの対応力を高める方針を取った。今回のオープンソース化は、その方針を外部開発者に開放する形での本格展開と位置づけられる。
エッジデバイス向け推論の難しさは、GPUアーキテクチャの多様性にある。Googleは次のように指摘している。
開発者は多様なGPUアーキテクチャ、ドライバーバージョン、低レベルAPIに直面する。アプリケーションが実際にどのハードウェア上で動作するかは、事前にわからない。
ML DriftはOpenGL ES、OpenCL、Metal、WebGPUといった主要な低レベルAPIを抽象化し、アプリケーションコードからハードウェアの違いを隠蔽する。
旧TensorFlow Lite GPUデリゲートは今後更新が停止される。 既存モデルを使用している開発者は、LiteRT ML Driftへの移行が推奨されている。
技術的な改善点
旧TFLite GPUデリゲートからの主な技術的強化点は以下の通りだ。
- テンソル仮想化(Tensor Virtualization)による統合シェーダー:論理テンソルと物理メモリ割り当てを分離することで、ライブ推論中のメモリフラグメンテーションを低減する
- 5次元テンソルのネイティブサポート:空間モデルやTransformerモデルをエッジGPU上で動かす際に、レイアウト変換のハック不要で扱える
- 拡張可能なカスタムオペレーション:カスタムの
GpuModel計算グラフやシェーダーを記述できる低レベルC++ APIを提供 - Arm、Intel、Qualcommの各GPUに向けたハードウェア固有の最適化
デスクトップ環境では、ChromiumのWebGPU実装であるDawnを通じてWindowsとLinuxでの推論をサポートする。DawnはWebGPUのハードウェア抽象化レイヤーを活用することで、DirectXやVulkanといったプラットフォーム固有のグラフィクスAPIを直接扱う必要をなくしている。macOSではMetalバックエンドをネイティブにサポートする。
実績数値:Chrome、YouTube Shorts、Snapchatで稼働済み
ML DriftはすでにChrome、YouTube Shorts、Google Photos、Meetといったアプリを通じて数百万台のデバイスで動作している。
Google発表のベンチマーク結果は次の通りだ。
⚠️ 計測条件に注意:以下の数値はGemmaモデルをワークステーショングレードのGPUで計測した結果であり、モバイル端末や他のモデル構成では結果が異なる可能性がある。
- メモリオーバーヘッドがllama.cppやMLX LMと比較して12%低減(前述の計測条件下)
- YouTube Shortsのセグメンテーションエフェクトで、AndroidおよびiOSの平均フレームレイテンシを最大40%削減
- Google Photosの計算写真・セグメンテーション処理を最大2秒短縮
- Adobe LightroomとPhotoshopのSelect Subject、Select Sky、Adaptive PortraitといったAI写真編集機能で最大30%のパフォーマンス改善
- Snapchatの顔認識・スタイル生成エフェクトのモデルレイテンシを30%削減し、より大きな拡散モデルの使用が可能に
エンジニアの反応
LinkedInでの議論も活発だ。AI/MLエンジニアのPavithra Agraharamは次のように述べた。
レイアウトのハックなしに5次元テンソルをネイティブサポートしたことは、エッジGPU上での空間モデルやTransformerモデルの実行において大きな前進だ。論理テンソルと物理メモリ割り当ての分離は、ライブ推論中のメモリフラグメンテーションを大幅に削減するはずだ。
一方、TenorustのファウンダーであるMatthew Charles Vladislav Buselは「最近のiPhoneにおけるCore MLとのレイテンシ・メモリ比較はどうなのか。実際に私たちがシップする対象はCore MLだ」と疑問を呈した(発言はLinkedIn上のもの。短縮URLのため元記事を参照)。現時点でGoogleはCore MLとの比較数値を公表していない。
利用方法
ML DriftはAPIレベルで使い方が分かれている。
- アプリケーション開発者:LiteRT ML Driftアクセラレーターを利用する
- GPU・システムエンジニア:低レベルC++ API(GitHub)を通じてカスタムGPUモデルや独自シェーダーを構築できる
詳細はGoogle ML Drift Accelerates On-Device AI Inference Across Diverse GPUsを参照していただきたい。