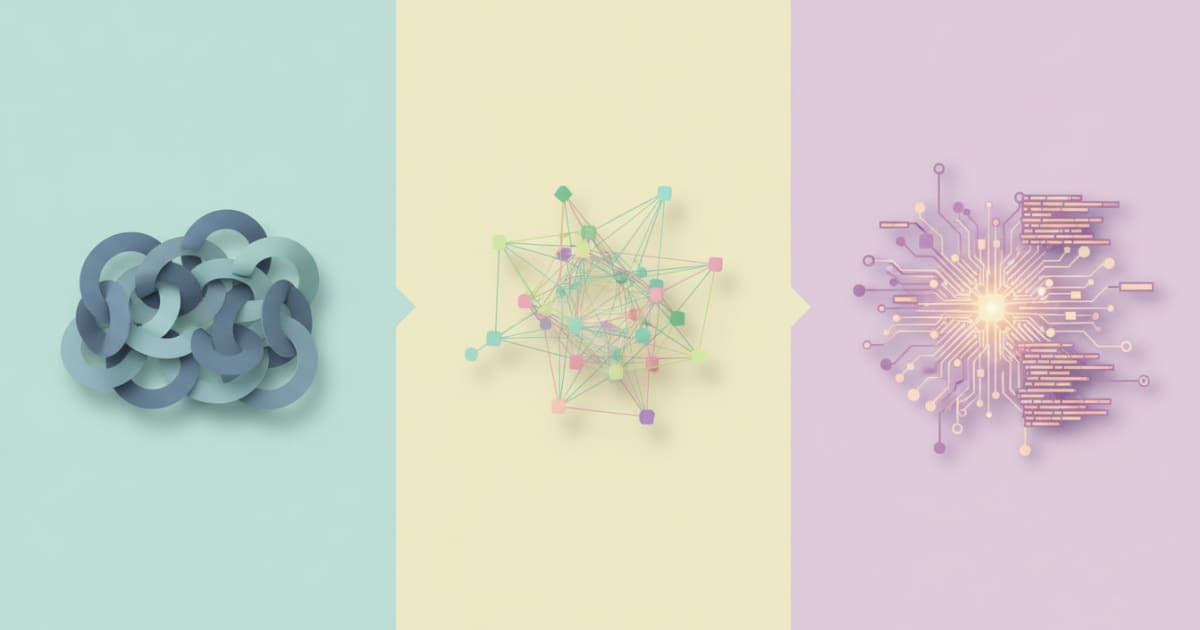
10月26日、InfoQが「The Evolution of Agentic Harnesses: From Chains to Graph to Code」と題した記事を公開した。AIエージェントの実行フレームワーク(ハーネス)が「チェーン→グラフ→コード実行」という3つのパラダイムを経て進化してきた過程と、本番運用に耐えるアーキテクチャ設計の原則について詳しく論じている。
LLMを使ったエージェントシステムの設計は、「とりあえず動くもの」から「本番に耐える構造」へと着実に移行しつつある。記事はLinkedInのエンジニアリングブログと連動した内容で、実際のプロダクト(Hiring AssistantやデータアナリティクスAgentなど)での経験を踏まえた技術的な考察となっている。
3つのパラダイムのうち、最も信頼性の高いアプローチとして記事が評価するのがコード実行型ハーネスだ。LLMに自然言語で「考えさせる」のではなく、コードを生成・実行・検証するループを回すことで、確率的な出力に依存しない決定論的な品質保証が実現できる。この優位性を理解したうえで、それに至るまでの進化の流れを追うと、各パラダイムの位置づけが明確になる。
チェーン:最速だが脆い
最初期のアプローチは線形チェーンだ。プロンプトの出力を次のプロンプトの入力にする、いわば「プロンプトの直列つなぎ」である。
LinkedInではLangChainを使い、以下の3ステップで構成された初期エージェントを構築した。
- ルーティング:クエリが対象範囲か判定し、担当の専門AIを選択
- リトリーバル:BingやLinkedIn内部APIを呼び出して情報を収集(RAGのための"資料"作成)
- 生成:収集データを絞り込み、最終回答を生成
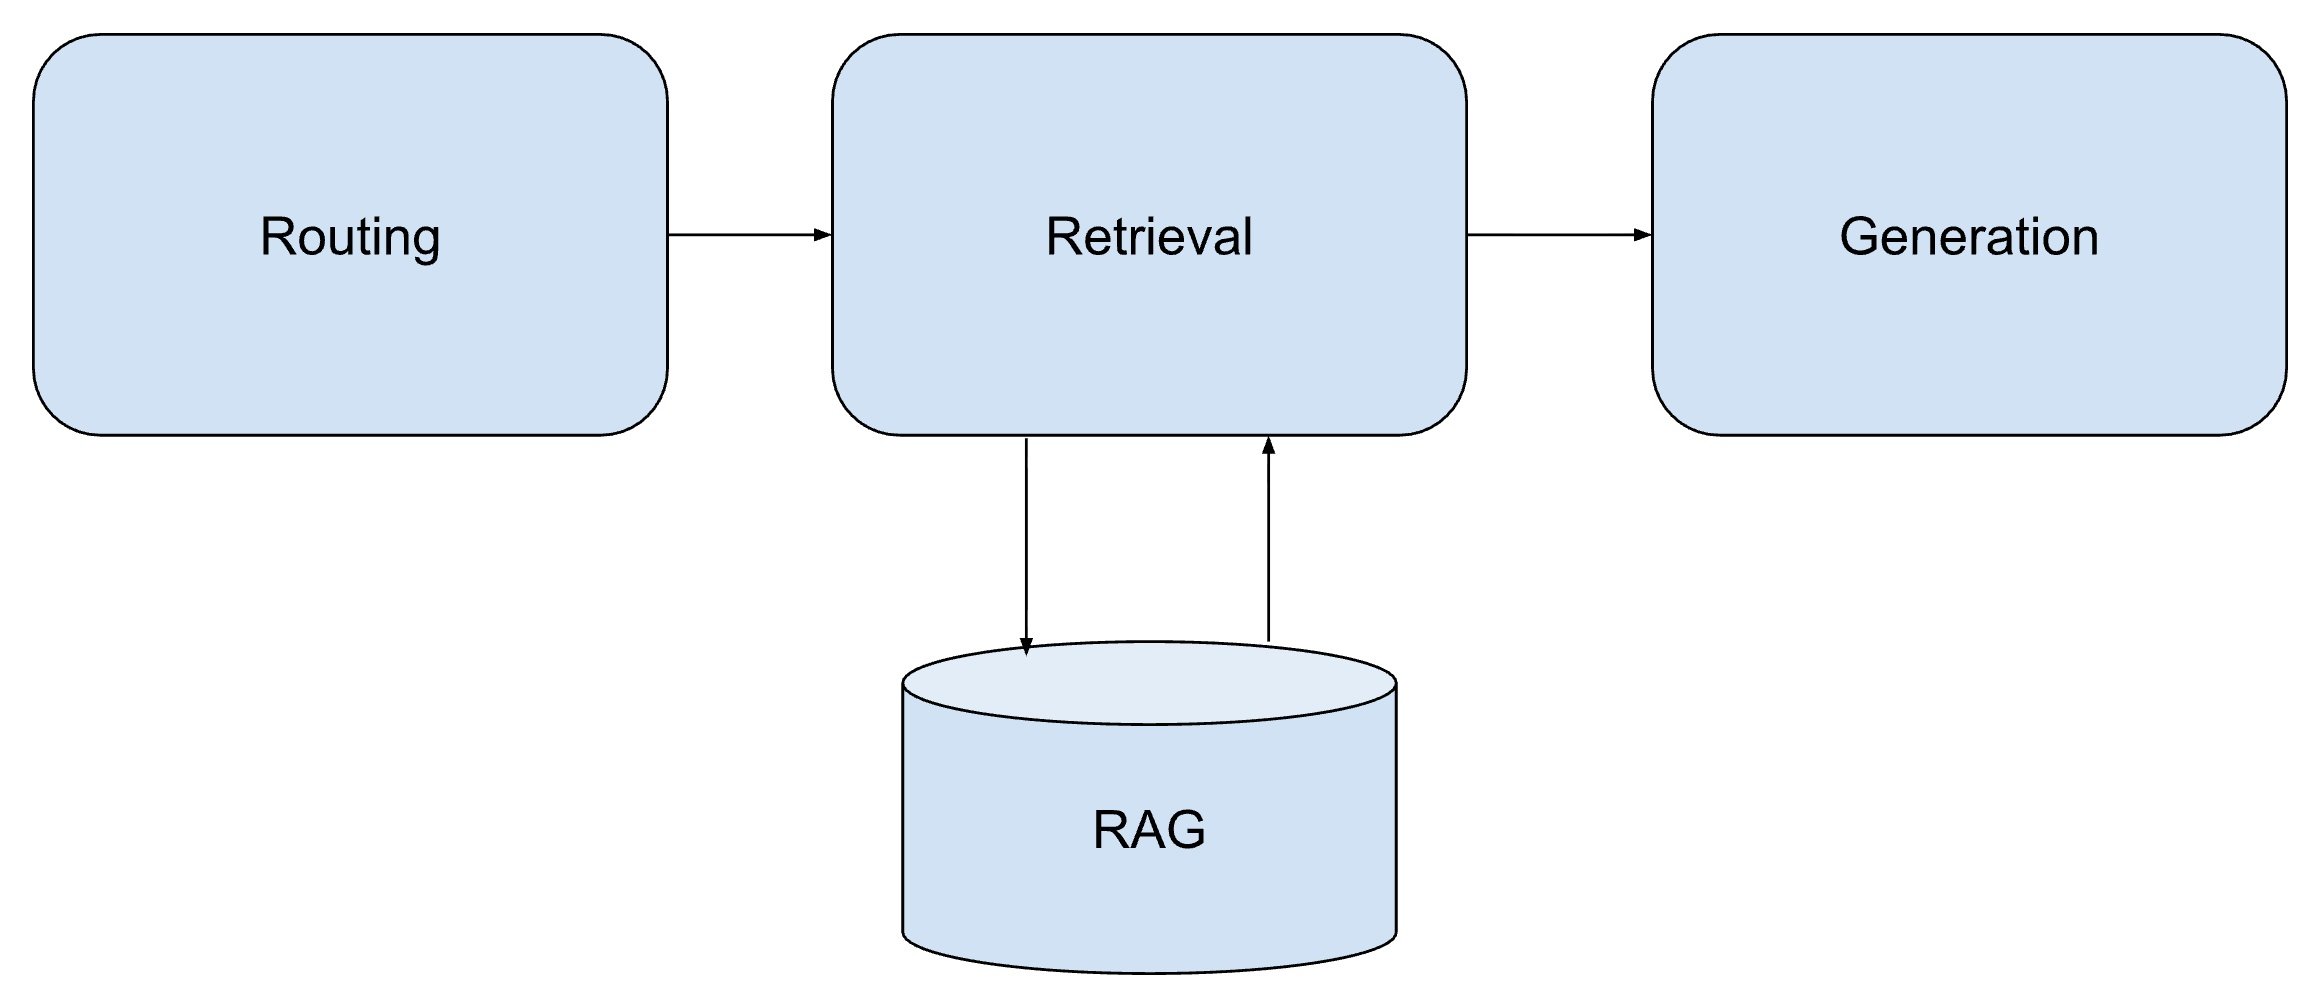
Figure 1: RAGを組み込んだシンプルなチェーン構成
開発は速い。ただし上流の1ステップが失敗すると、エラーが後段にそのまま伝播する。障害を検知・回復する仕組みが構造的に存在しないため、最初の80%は短期間で作れても、残り20%の品質を詰めるために膨大な反復が必要になる。
グラフ:制御フローを明示する
チェーンの脆さへの回答がグラフ構造だ。ノード(タスク単位)とエッジ(制御フロー)で実行計画を明示的・宣言的に定義する。条件分岐、並列実行、リトライ、ステート管理が可能になる。
LinkedInではLangGraph上にグラフを実装し、既存のメッセージングシステムを流用してエージェント間通信を実現した。これにより以下を獲得した。
- 並列実行:複数メッセージスレッドによる並列処理
- 耐障害性:永続リトライと確実なメッセージ配信
- 柔軟な応答モード:同期・非同期・ストリーミングに対応
また、複数エージェントが協調するマルチエージェント構成では、エージェント間通信プロトコルとしてA2AやACP(関連するプロトコルとして併用されている)が活用されている。「Human in the Loop(HITL)」も重要な構成要素で、エージェントが自律的に判断できない場面では人間オペレーターへの確認を挟む設計が採られた。
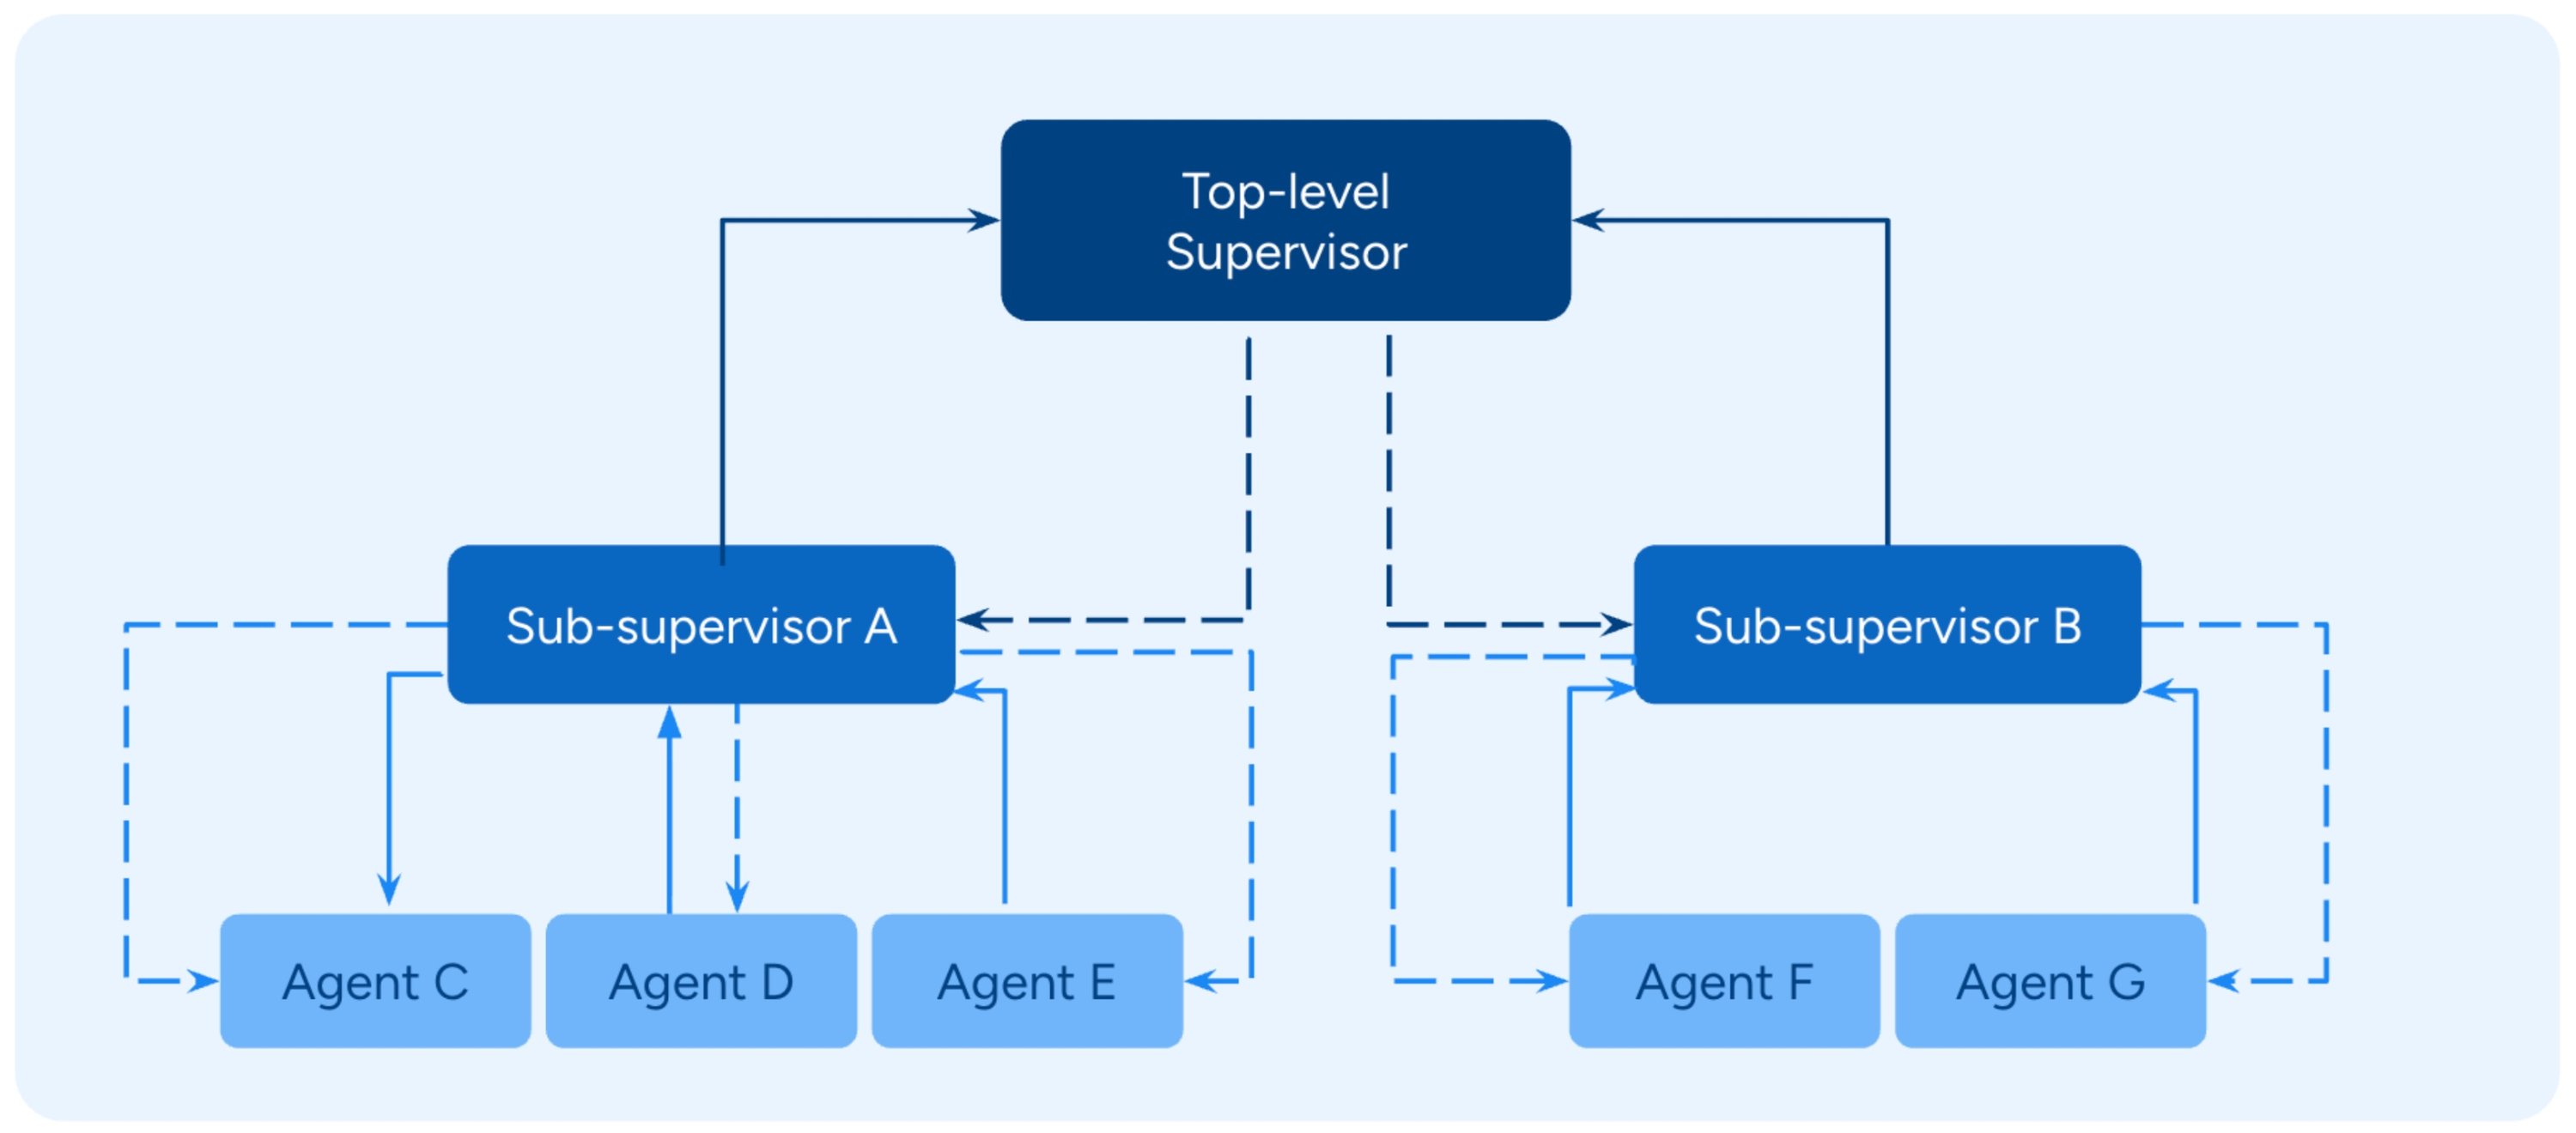
Figure 2: マルチエージェント構成の代表例
このグラフ基盤の上でLinkedInが構築したのが、採用担当者向けAIエージェント「Hiring Assistant」だ。候補者の検索や応募者レビューを自動化し、採用担当者が人間的・戦略的な業務に集中できる環境を提供している。
ただし、グラフも万能ではない。ワークフローと状態空間が複雑になるにつれ、リカバリーパス・バリデーションロジック・エッジケース処理をすべて人手で定義しなければならない。柔軟性に欠け、決定論的に表現しにくいタスクには不向きだ。
コード実行:最も信頼性の高いアプローチ
3つめのパラダイムがコード実行型ハーネスだ。LLMに自然言語で「考えさせる」のではなく、コードを生成させ、サンドボックスで実行し、結果を検証してから次に進む。
自然言語の出力は確率的で本質的に信頼できないが、コードは決定論的だ。「コンパイルが通り正しい出力が返るか」「そうでないか」のパス/フェイルが明確で、タイトなフィードバックループが成立する。チェーンやグラフでは人手で定義しなければならなかったリカバリーパスやバリデーションロジックを、コードの実行結果そのものがフィードバックとして担う点が根本的な違いだ。
構成要素は4つ。
| コンポーネント | 役割 |
|---|---|
| 実行サンドボックス | 生成コードを安全に実行する隔離環境 |
| インストゥルメンテーション/ログ | 出力・エラー・中間状態を記録 |
| バリデーションハーネス | ユニットテストやアサーションで正しさを自動検証 |
| 反復改善ループ | 失敗を観察→コード修正→再実行を条件達成まで繰り返す |
LinkedInでは、このアプローチで社内のデータ分析ツールを構築した。開発者・PM・データサイエンティスト・ビジネス部門が自然言語でプラットフォームデータに問い合わせると、エージェントがSQLとPythonに変換→サンプルデータで実行→プライバシー・ガバナンスチェックを含む検証→条件達成まで自動ループという手順で回答を返す。
プライバシー・アクセス制御・セキュリティの既存フレームワーク内で動作し、ロールと目的に基づくデータアクセス制御を実施している。
記事では、各タスクに特化したプロンプト・ツール・グラフ定義を個別に作り込む(bespoke、すなわち「特注」の)手間を省けたため、開発速度が上がり、かつ最終システムの監査性・再現性も大幅に向上したと評価している。
設計原則:パラダイムを問わず共通する4つの指針
どのアプローチを選択するかにかかわらず、記事は以下を共通原則として挙げている。
- LLMの出力は「信頼できない入力」として扱う:スキーマチェック、ビジネスルール、コンプライアンス検証を必ず挟む
- プランニングと実行を分離する:モデルには計画を提案させ、実行は制御されたソフトウェア層に委ねる
- オブザーバビリティに投資する:各ステップの状態・実行トレース・バリデーション結果を捕捉できなければデバッグは不可能
- 最も単純な抽象を選ぶ:信頼性・速度・コストの要件を満たす中で、最も複雑でない選択肢を選ぶ規律を持つ
この最後の点は特に重要だ。複雑なグラフやコード実行ハーネスが常に正解ではなく、要件によってはシンプルなチェーンで十分なケースもある。過剰なアーキテクチャはそれ自体がリスクになる。
詳細はThe Evolution of Agentic Harnesses: From Chains to Graph to Codeを参照していただきたい。