10月30日、Roboflowが「How to Use a Small Vision Model as a Filter for an AI Agent」と題した記事を公開した。GPT-4oやClaudeといった大型VLM(Vision Language Model)のAPIコストは、製造現場のような大量画像を扱うユースケースで深刻な問題になりつつある。この記事が提案するのは、小型の物体検出モデルを前段フィルタとして挟み、欠陥の疑いがある画像だけを大型VLMに回すというアーキテクチャだ。全画像をVLMに投げ続けるのではなく、コンピュータビジョンモデルで事前スクリーニングすることで、APIコストの削減と欠陥の見逃し低減を同時に狙う。
なぜ「フィルタ」が必要なのか
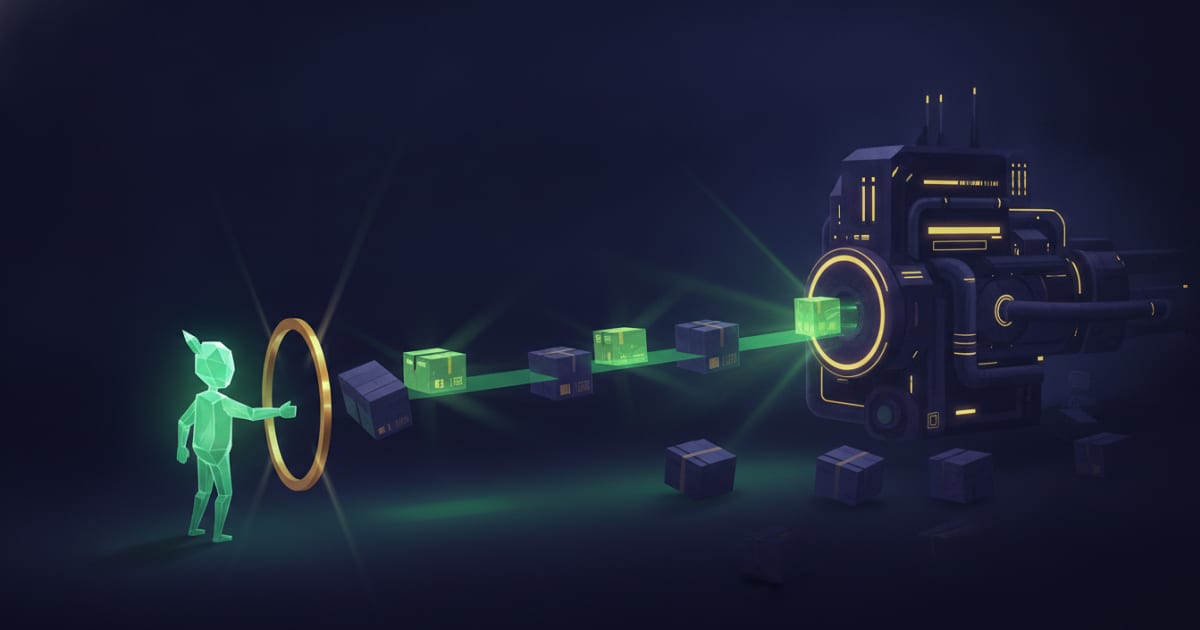
製造現場の画像検査では、カメラが大量の製品画像を連続的に撮影する。これをすべてGPT-4oのような大型VLMに投げると、APIコストが跳ね上がる。業界全体でVLM活用の需要が高まる一方、そのコスト問題は多くの現場で導入の障壁になっている。そこで記事が提案するのが、小型の物体検出モデルを「門番」として前段に置くアーキテクチャだ。
具体的には、Roboflow Workflows(複数のビジョン処理ブロックをノーコードでパイプライン化できるRoboflowのオーケストレーション機能)で構築した物体検出パイプラインを、AIエージェントのツールとして公開する。エージェントはまずこのツールを呼び出して画像をスクリーニングし、欠陥の疑いがある画像だけを大型VLMによる詳細分析に回す。
記事ではテキスタイル(織物)製造を例に取る。使用するモデルはRoboflow Universe公開モデル「fabric-kruoy/18」で、アーキテクチャはRF-DETR Medium。検出クラスはfabric_broken_pick、fabric_hole、fabric_missing_pick、fabric_thick_weftの4種類だ。fabric_perfectは意図的に検出対象から除外している。これは正常品をレビュー対象として誤カウントしないようにするためで、欠陥クラスのみをフィルタ判定の根拠にするという設計上の意図がある。
Workflowの構成:フィルタの中身
Roboflow Workflows上にtextile-defect-agent-filterという名前のWorkflowを構築する。構成要素は以下の通りだ。
入力
| 名前 | 型 | 用途 |
|---|---|---|
image |
Image | 推論に使う生地画像 |
image_id |
テキストパラメータ | 結果と紐付けるID |
confidence_threshold |
数値パラメータ | 保持する検出スコアの下限(デフォルト: 0.25) |
処理フロー
- 物体検出(
detect_textile_defects):モデルIDfabric-kruoy/18を使い、4クラスのみを対象に検出。信頼度フィルタはこのブロック内で完結するため、別途Detections Filterブロックは不要。 - 検出数カウント(
count_defect_detections):残った予測のボックス数を数える。 - レビューフラグ生成:カウントが1以上なら
selected_for_review: true/reason: possible_defect、0ならfalse/not_selectedを返す。Booleanで返す点が重要で、文字列の"true"ではない。 - 結果フォーマット(カスタムPythonブロック):画像ID、選択フラグ、理由、欠陥数、各検出の
xyxy形式バウンディングボックス(左上・右下の2点座標)をJSON化して返す。

重要な設計注意点として記事が明記しているのは、「not_selectedはその画像が欠陥なしと確定したことを意味しない」という点だ。あくまでモデルが欠陥を検出しなかったというだけで、最終判断は別途必要になる。
また、WorkflowにはLLMやVLMのブロックを一切含まない設計がポイントだ。Workflowは純粋にコンピュータビジョンの処理に徹し、判断はエージェント側に委ねる。これによりWorkflow自体の実行コストを低く保てる。
エージェントとの接続:2つの方法
Workflowを構築した後、AIエージェントとの接続方法として2つの選択肢が示されている。
| 方法 | エージェント | フィルタの呼び出し | 視覚レビューの方法 |
|---|---|---|---|
| Option 1 | ChatGPTまたはClaudeのアシスタント | workflows_runツールでWorkflow実行 |
media_analyzeツールで別のVLMが元画像をレビュー |
| Option 2 | OpenAI Agents SDKで構築したPythonエージェント(gpt-4o使用) |
screen_fabric_imagesツールで同Workflow実行 |
view_defectツールで検出領域のクロップ画像を取得・分析 |
Option 2ではローカルフォルダ(fabric-images)に画像を置き、サブフォルダ構造を含めて一括処理できる。image_idにはファイルの相対パス(例:roll-01/frame-003.jpg)が使われるため、異なるサブフォルダに同名ファイルがあっても区別できる。
Option 1はノーコードに近い形でエージェントを構築したい場合に向き、Option 2はPythonで細かく制御したい開発者向けの選択肢になる。どちらもWorkflow側のインターフェースは同一のままで、エージェント実装だけを切り替えられる点が設計の柔軟性を高めている。
評価軸:何を検証すべきか
記事は実装後の評価について、以下の3点を検証することを推奨している。
- 画像フィルタリングの精度:欠陥ありの画像を正しく選択できているか
- トークン使用量:フィルタなしの場合と比べてVLMへの入力がどれだけ削減されたか
- 見逃し欠陥:フィルタで除外された画像に実際の欠陥が含まれていなかったか
テスト用画像セットには、明確な欠陥・微細な欠陥・検査済みの良品を混在させることが推奨されている。また、信頼度閾値0.25はあくまで出発点で、自前のテストセットで評価して調整することが前提となっている。
このアーキテクチャの本質は、「全件をVLMに問い合わせる」という設計から「必要な件だけをVLMに問い合わせる」設計への転換にある。フィルタの精度が高いほどコスト削減効果は大きくなる一方、閾値を上げすぎると欠陥の見逃しが増えるトレードオフがある。この閾値チューニングこそが、実運用における最大の調整ポイントになるだろう。
詳細はHow to Use a Small Vision Model as a Filter for an AI Agentを参照していただきたい。