11月2日、angulararchitects.ioが「Optimizing Agentic Applications for Local Models: Patterns for Speed and Reliability」と題した記事を公開した。クラウドの外でAIを動かす「ソブリンAI」への需要が高まっている。規制産業を中心に、データを自社管理下に置き、特定プロバイダーへの依存を断ち切りたいという要求は強い。しかし、自前でホストできるオープンウェイトモデルは、GPT-4oやClaude 3.5 Sonnetといったフロンティアモデルとはまだ性能差がある。この記事では、GoogleのオープンウェイトモデルGemma 4をバックエンドに据えたエージェントアプリケーションを実際に構築した経験から得られたパターンを紹介している。エージェントの実行にはMastra、フロントエンドにはAngular向けのCopilotKitを使用しているが、記事中のパターン自体はフレームワークやモデルを問わず適用できる。
「Thinking」をオフにするだけで3倍速くなる
最も効果が大きかった最適化が、モデルの思考(Thinking)機能の無効化だ。タイトルの「3倍速く」はこの最適化による改善を指している。
Gemma 4を含む多くの最新モデルは、回答前に「内部推論ステップ」を実行できる。ユーザーには見えないこの思考フェーズで、モデルはリクエストやシステムプロンプトのルール、次のステップの候補を検討する。複雑な質問への回答品質は上がるものの、コストは大きい。
実測値では、Thinkingありの場合の中央値は7.8秒、なしでは2.5秒と約3倍の差が出た。出力トークン数も3〜5倍に膨らんだ。しかもツール呼び出しの信頼性はThinkingの有無で変わらなかった。インタラクティブなアプリケーションにとって、7.8秒のレイテンシは許容できない。
エージェントアプリの主な仕事は「適切なツールを選んでパラメータを埋める」ことであり、複雑な推論はツール側のコードやエージェントループに委ねられる。モデルが誤ったツール呼び出しをしても、次のステップでツールの返り値から自己修正できるためだ。
Cloudflare Workers AI上でGemma 4をホストしている場合、すべてのリクエストに chat_template_kwargs: { enable_thinking: false } を付与することでThinkingを無効化できる。
なお、Thinkingをオフにすると「システムプロンプトのルールよりも、判断直前のテキストが優先されやすくなる」という副作用もある。記事では、あるルールをシステムプロンプトからツールの説明文内に移したところ、Gemmaがルールに従うようになったと報告している。
ステップ数の上限緩和とタイムアウト設定
Thinkingをオフにすると、モデルは推論フェーズではなく次のステップで誤りを修正するようになる。その結果、必要なステップ数が増える。
Mastraはデフォルトで最大5ステップで停止する。旅行プランの変更のような操作では「検索→変更→確認→応答」と最低4ステップが必要で、修正の余地が1ステップしか残らない。実際、Gemmaがステップ数を使い果たし、プランは変更されたのにユーザーへの返答が途切れるという問題が発生した。記事では最大8ステップに設定することで解決している。
以下はメインエージェントでの設定例だ(maxSteps: 8 がThinking無効化と組み合わせる本題の設定にあたる):
// ai-server/src/mastra/agents/travel-agent.ts(構成のイメージ)
export const travelAgent = new Agent({
  id: 'travelAgent',
  name: 'Flight42 Travel Assistant',
  instructions: travelAgentPrompt,
  model,
  tools: { ... },
  defaultOptions: { ...defaultOptions, maxSteps: 8 },
});
※編集部の考察:元記事にはメインエージェントのコード全体は掲載されていないが、記事中の説明(「maxSteps を 8 に設定した」)に基づき、構成のイメージとして示している。実際の実装は公開リポジトリを参照されたい。
もうひとつの問題はハングアップだ。単一ステップがテキストもツール呼び出しも出力しないまま数分間走り続けることがあり、ひどい場合は約1時間後にタイムアウトエラーが出るケースもあった。ステップごとの出力トークン上限とリクエスト全体のタイムアウトで対処している。
なお、エージェントによってはステップ数を絞ることが合理的な場合もある。以下はダッシュボード専用エージェントの設定例で、1ターンにつき1回のツール呼び出ししか行わないため maxSteps: 1 で上書きしている:
// ai-server/src/mastra/agents/dashboard-agent.ts
import { Agent } from '@mastra/core/agent';
import { defaultOptions, model } from '../config.js';
import { renderDashboard } from '../tools/render-dashboard.js';
import { dashboardAgentPrompt } from './dashboard-agent.prompt.js';

export const dashboardAgent = new Agent({
  id: 'dashboardAgent',
  name: 'Flight42 Dashboard Composer',
  instructions: dashboardAgentPrompt,
  model,
  tools: { renderDashboard },
  defaultOptions: { ...defaultOptions, maxSteps: 1 },
});
また、temperature は0に設定することでツール呼び出しの再現性を高めている。
モデルにデータを「コピーさせない」パターン
速度改善に共通する考え方が、「モデルにデータを中継させない」というものだ。
ツール呼び出しレンダラーで出力トークンを半減
CopilotKitのような Agentic UI フレームワークでは、エージェントがチャット内にコンポーネントを描画できる。よくあるアプローチは「データ取得ツール→コンポーネントツール」という2段階構成で、モデルがフライト情報を取得した後、その全フィールドをコンポーネントツールの引数として書き写す。IDや完全なISO日付などを一文字ずつ出力するこの処理は、出力トークンの無駄遣いであり、コンパクトなモデルには特に負担が大きい。
ツール呼び出しレンダラーはこの方向を逆転させる。ツールの実行結果をフレームワーク側がコンポーネントで描画し、モデルは添える文章だけを書けばよい。
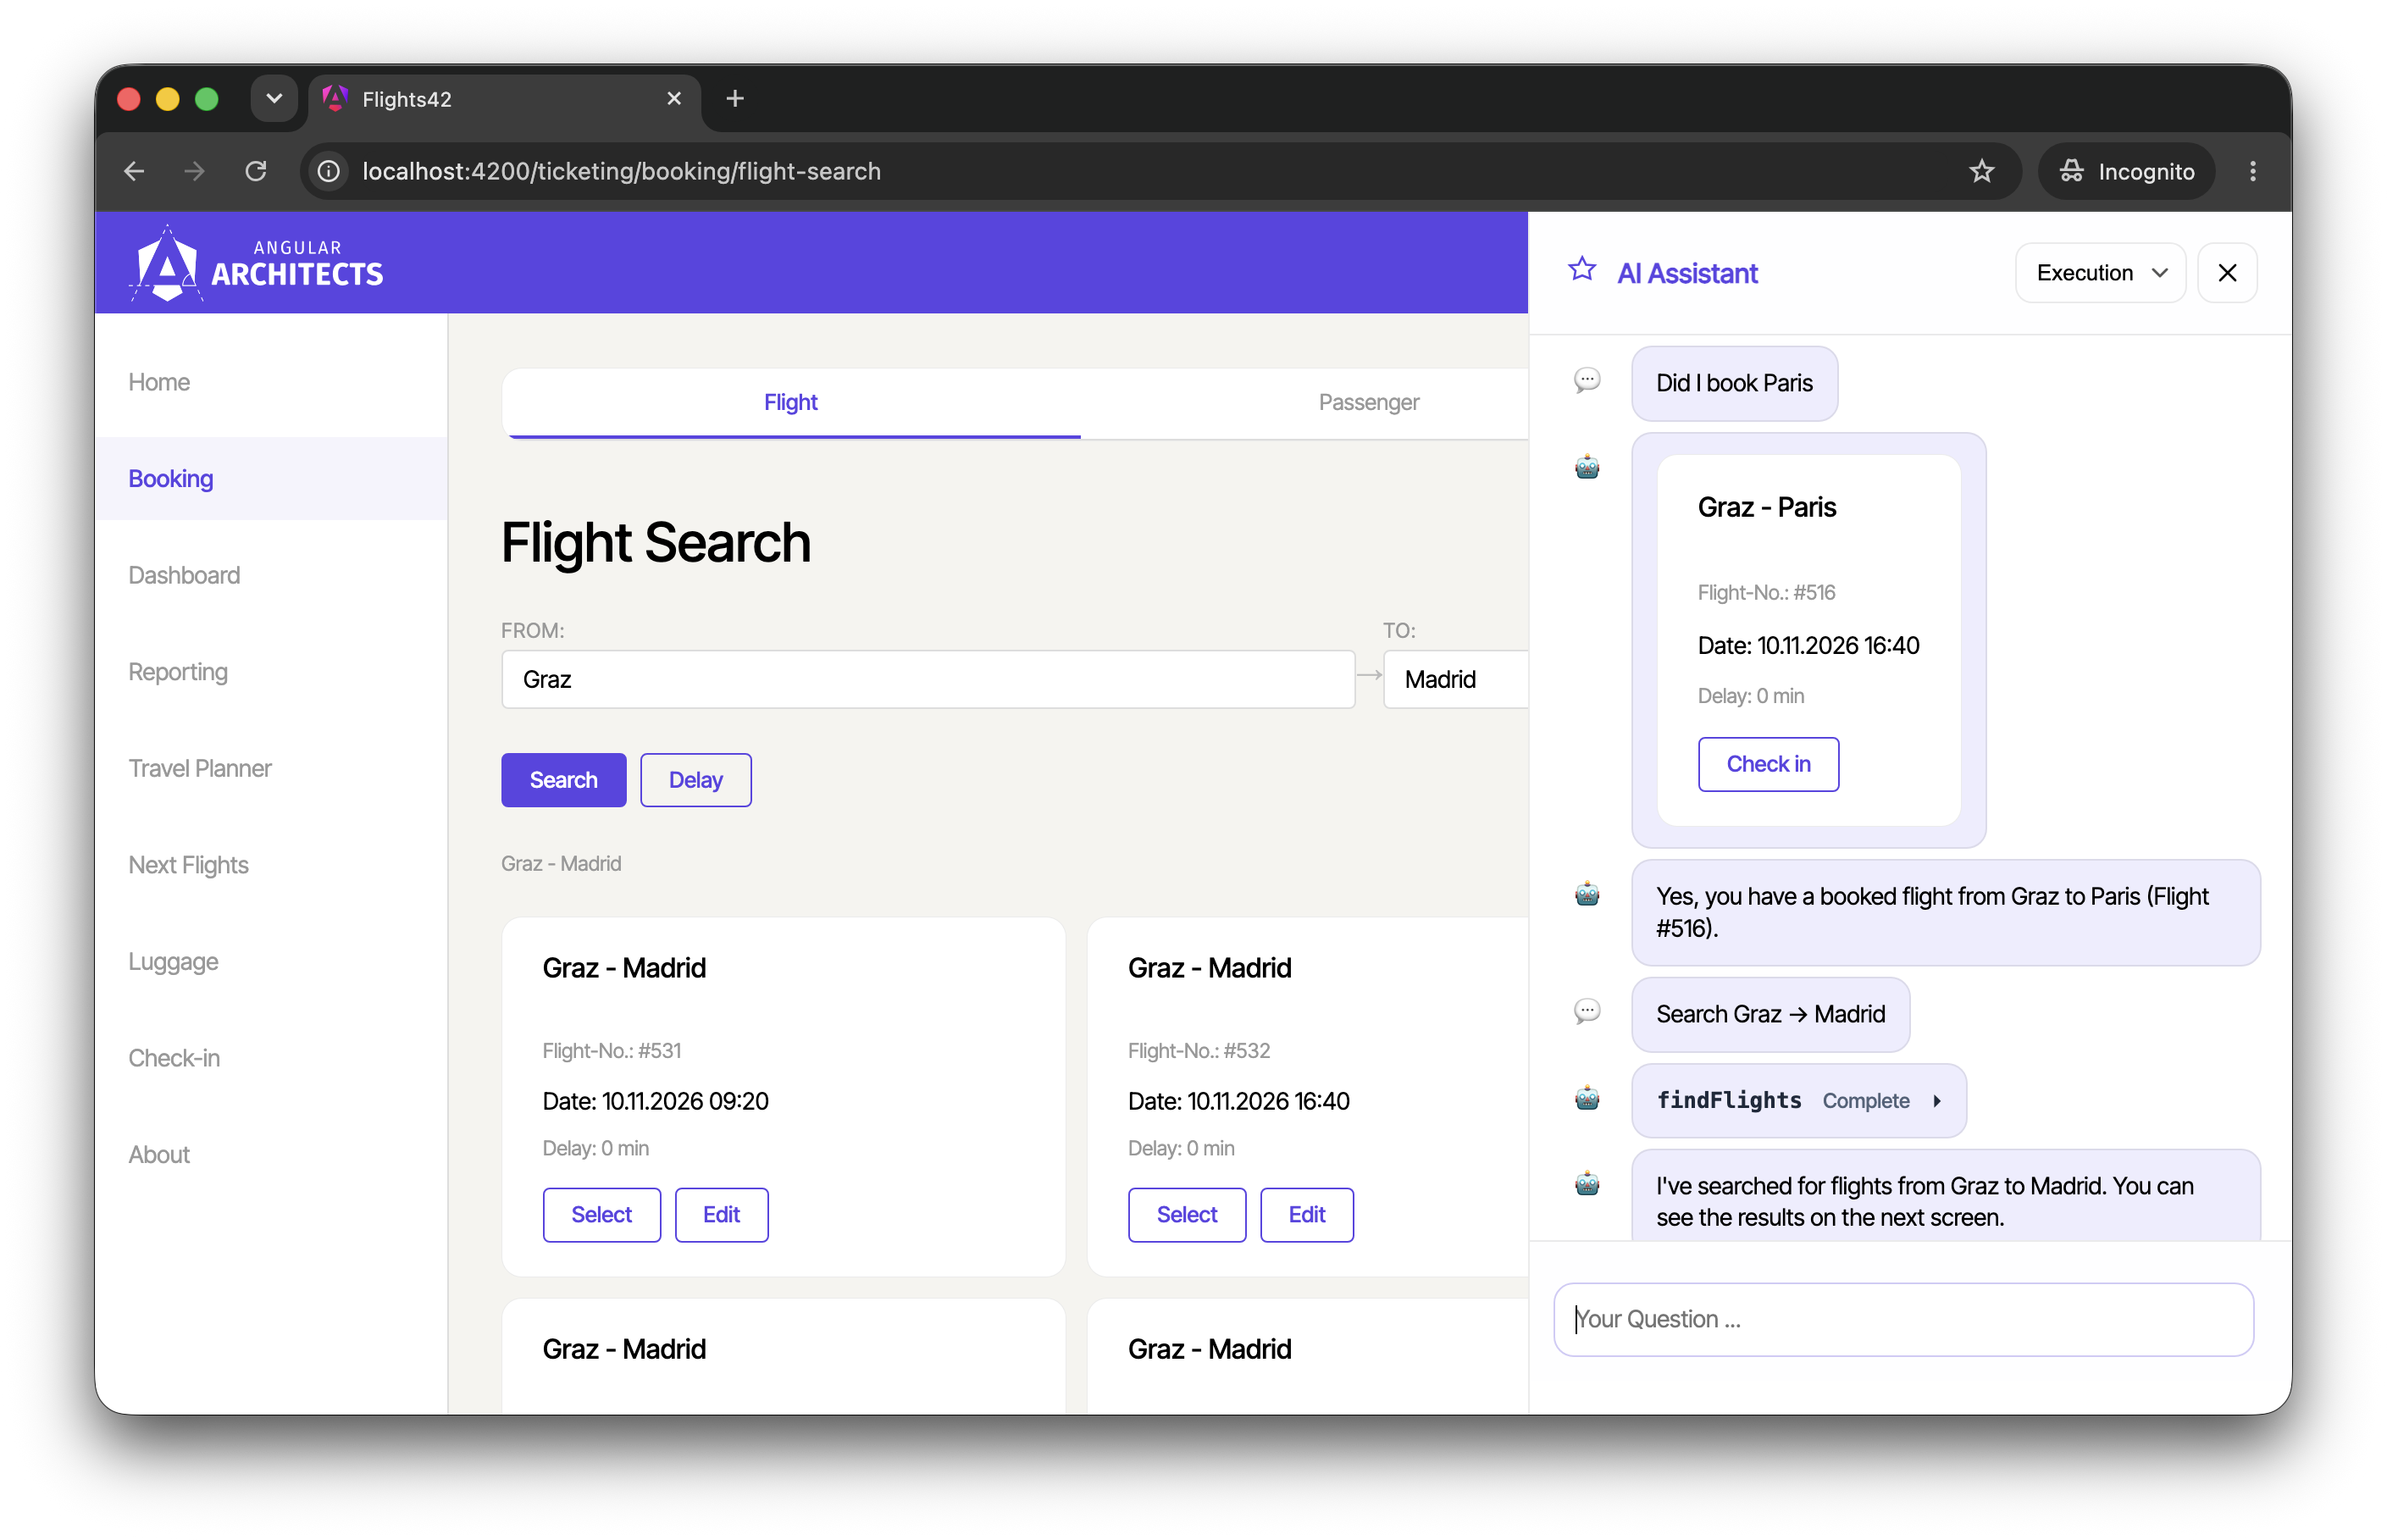
「Did I book Paris?」という質問に対して、この変更だけで回答速度が約3分の1短縮、出力トークンが約半減した。なお、この「3分の1短縮」はThinking無効化による3倍高速化とは別の最適化によるものだ。
狭いDSLでダッシュボードを43,000トークン→数百トークンに
ダッシュボードには独自のプロトコルとしてA2UIを採用している。モデルはUI構造を直接書くのではなく、以下のような簡潔なタイル仕様を renderDashboard ツールに渡すだけでよい:
{ "type": "delayShareChart", "from": "Graz", "to": "Hamburg" }
サーバー側がこの仕様をA2UIに変換してデータを取得する。この「狭いDSL(ドメイン固有言語)」アプローチにより、システムプロンプトは約2,300文字(数百トークン)に収まっている。以前の実装でモデルにA2UIを直接生成させていた頃は、1回のダッシュボード生成あたり43,000入力トークン以上を消費していた。A2UIのアプローチについては、同サイトの別記事「How I Made My A2UI Dashboard 300 Times Faster」でも詳しく解説されている(※編集部注:元記事からの関連リンクとして紹介されているものだ)。
評価(Eval)で効果を数字で確認する
記事では、「感覚的な改善」を避けるために、変更前後で必ずEvalを実行して数字で検証することを強調している。「明らかに効果がありそうに見えた修正が、実際には効果なし、あるいは悪化させた」というケースも複数あったとのことだ。
EvalはAngularのユニットテストとしてNode.js上で動作し、実際のエージェントストアとCopilotKitを通じて典型的なプロンプトを送信して検証する。temperature 0でも推論サーバーのバッチ処理やGPU上のわずかな丸め誤差でトークン選択が変わり得るため、1プロンプトあたり3回実行して傾向を確認している。
Evalのソースコードはリポジトリで公開されている。
詳細はOptimizing Agentic Applications for Local Models: Patterns for Speed and Reliabilityを参照していただきたい。