11月3日、Machine Learning Masteryが「Choosing an LLM Inference Optimization Technique: A Decision-Tree Approach」と題した記事を公開した。LLMをプロダクションで運用していると、トラフィックが増えるにつれて推論が遅くなり、コストが跳ね上がる。量子化、投機的デコード(Speculative Decoding)、プリフィル・デコード分離……手法は多数あるが、「どれを選ぶか」の判断基準が整理されていないケースは多い。この記事が提示するのは、ワークロードのボトルネックに基づいて手法を絞り込む6問のデシジョンツリーだ。誤った手法を選べば複雑さだけが増してパフォーマンスは改善しない——この記事はその選択ミスを防ぐための実践的なフレームワークを提供している。
なぜ「手法の前提条件」を理解すべきか
各最適化手法は、それぞれ異なる種類のボトルネックを対象としている。前提条件が自分のワークロードに合わない手法を選ぶと、複雑さだけが増してパフォーマンスは改善しない。記事では以下のように整理されている。
| 手法 | 前提とするボトルネック |
|---|---|
| 量子化 / スパース化 / 蒸留 | モデル自体がハードウェアやレイテンシ要件に対して大きすぎる |
| プレフィックスキャッシング(Prefix Caching) | 多くのリクエストが同一のプロンプト先頭部分を共有している |
| 連続バッチング(Continuous Batching) | 出力長が不均一なリクエストが並行して到着し、GPU待機時間が発生している |
| PagedAttention | KVキャッシュのメモリ断片化によりバッチサイズが制限されている |
| 投機的デコード(Speculative Decoding) | デコードがボトルネックであり、トークンごとのレイテンシを削りたい |
| プリフィル・デコード分離(Prefill-Decode Disaggregation) | プリフィルとデコードが同一GPU上で競合し、両方の指標を悪化させている |
| テンソル / パイプライン並列(Tensor / Pipeline Parallelism) | モデルが単一デバイスのメモリに収まらない |
| KVキャッシュオフロード | GPU上のKVキャッシュが不足し、有用なキャッシュが早期に破棄されている |
| オフラインバッチ推論 | インタラクティブな応答が不要で、全体スループットを最優先にしたい |
なお、現在広く使われている代表的なサービングエンジンとしては、vLLM、TensorRT-LLM、SGLangなどがある。これらのエンジンは上表の手法のうち複数をデフォルトまたはオプションでサポートしており、どのエンジンを選ぶかによって使える手法の組み合わせも変わってくる点は押さえておきたい。
6問のデシジョンツリー
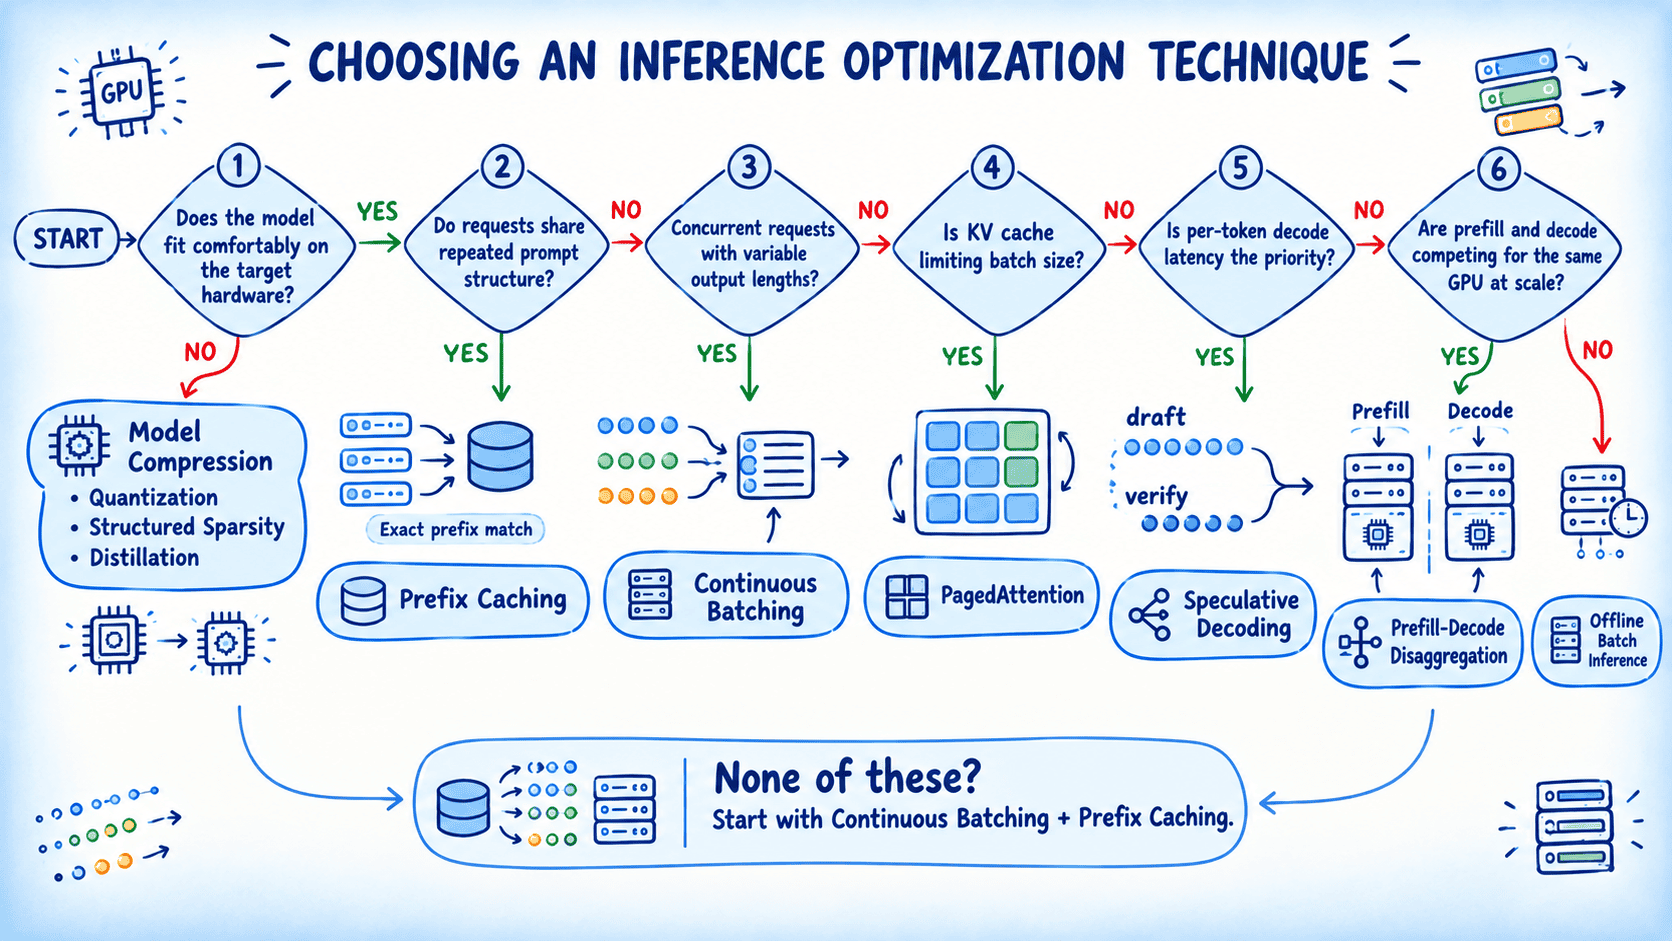
Q1: モデルはターゲットハードウェアに余裕を持って収まるか?
まず確認すべきはモデルサイズだ。メモリにギリギリ収まる状態ではKVキャッシュ用の領域がほぼ残らず、スケジューラがどれだけ優秀でもバッチサイズが頭打ちになる。モデルが大きすぎる場合、あるいはバッチサイズ1でも計算がボトルネックになる場合は、量子化・スパース化・蒸留のいずれかから着手する。余裕があればQ2へ。
Q2: リクエスト間でプロンプトの先頭部分が共通しているか?
チャットアプリは毎ターン会話履歴全体を再送する。エージェントフレームワークは同一のシステムプロンプトを何千回も使い回す。RAGパイプラインも同様だ。プレフィックスキャッシング(Prefix Caching)はこういった「共通先頭部分」のKVキャッシュ再計算をスキップする。会話が長くなるほど効果が大きくなる。
⚠️ 注意点:プレフィックスキャッシングはプロンプトが1文字単位で完全一致する場合にのみ有効だ。変動しない内容を先頭に、動的なコンテンツは末尾に配置する必要がある。プロンプトがほぼ固有でほとんど共通部分がなければQ3へ。
Q3: 出力長が不均一なリクエストが並行して到着しているか?
1文で終わるサポート応答と400行のコード生成が同じバッチに入ると、バッチ全体が最も遅いリクエストを待つことになる。連続バッチング(Continuous Batching)は完了したシーケンスをその場でバッチから外し、新しいリクエストをバッチ境界を待たずに開始させる。vLLMやSGLangなど多くのサービングエンジンではデフォルトで有効になっている。問題なければQ4へ。
Q4: KVキャッシュの断片化がバッチサイズを制限しているか?
一部のエンジンはリクエストごとに最大シーケンス長分のメモリを連続ブロックで確保する。実際には短いリクエストが多くても、そのメモリは他のリクエストに使えない。**PagedAttention**はKVキャッシュを固定サイズのページに分割し、小さな単位でメモリを割り当てる。vLLMが最初に実装した手法として知られており、現在では多くのモダンなサービングエンジンが既にサポートしている。まず有効になっているか確認するとよい。メモリが制約でなければQ5へ。
Q5: トークンごとのデコードレイテンシが主な課題か?
スループットではなくユーザーごとの体感速度(トークンストリーミングの速さ)を改善したい場合、投機的デコード(Speculative Decoding)が候補になる。小さなドラフトモデルが数トークン先を予測し、本体モデルが1パスで検証する。ドラフトモデルの予測が当たれば、複数のデコードステップをまとめて処理できる。ただし、ドラフトモデルの受理率が低いと逆効果になる。該当しなければQ6へ。
Q6: プリフィルとデコードが同一GPU上で競合しているか?
大規模トラフィックになると、長いプリフィル(Prefill)処理がデコードリクエストの遅延を引き起こす。プリフィル・デコード分離(Prefill-Decode Disaggregation)はプリフィル専用ノードとデコード専用ノードにハードウェアを分ける構成だ。ただし、ノード間のKVキャッシュ転送とルーティングのオーバーヘッドが発生するため、小規模ワークロードには割に合わない。
よくある落とし穴
手法を導入しても期待通りに動かないケースも多い。記事では以下のパターンが挙げられている。
| 症状 | 原因 | 対処 |
|---|---|---|
| プレフィックスキャッシュのヒット率がほぼゼロ | 動的コンテンツがプロンプト先頭に入っている | 静的コンテンツを先頭に移動し、シリアライズのキー順序を固定する |
| メモリが余っているのにバッチサイズが増えない | PagedAttentionが無効、またはページサイズの設定が不適切 | サービングエンジンのバッチ・キャッシュ設定フラグを直接確認する |
| 投機的デコードが通常デコードより遅い | ドラフトモデルの受理率が低い | ターゲットモデルに近い挙動のドラフトモデルに替えるか、この手法を外す |
| 分離構成にしたら逆にレイテンシが悪化した | ワークロードが小さすぎる、またはリクエストが短くキャッシュ重視 | ローカルプリフィルに戻し、一定トラフィック閾値を超えてから再検討する |
| 量子化してもスループットが上がらない | 重みだけ量子化し、活性化が全精度のまま | プロファイリングで時間消費箇所を特定してから判断する |
まとめ
6問のデシジョンツリーが示す本質は、「何を改善したいか」ではなく「どこがボトルネックか」から出発するという考え方だ。モデルサイズ、プロンプトの重複度、トラフィックの並行性、メモリの断片化、スループットとレイテンシのどちらを優先するか——これらの問いに順番に答えることで、適切な手法を絞り込める。
実際のシステムでは複数の手法を組み合わせることが多い。まずプロファイリングでボトルネックを特定し、デシジョンツリーの問いを一つずつ確認していくことが、無駄な複雑さを抱え込まない最短ルートになる。いずれの手法も、導入後は必ず実測で効果を検証する習慣をつけておきたい。
詳細はChoosing an LLM Inference Optimization Technique: A Decision-Tree Approachを参照していただきたい。