11月2日、zwischenzugs.comが「What I Learned Building a RAG Server on my Home Server – zwischenzugs.com」と題した記事を公開した。SlackなのかメールなのかWhatsAppなのか、どこで誰かと話したか思い出せない。Linuxでxrandrの設定手順をどこかに書いたはずなのに見つからない——そういった問題を解決するために、筆者はRAGシステムを自宅に構築した。現在このシステムは66,398ドキュメント(256,390パッセージ)を検索対象とし、引用付きで質問に回答する。さらに構築後に気づいた副次的な用途として、過去の自分の活動を振り返る「セルフレビューツール」としても機能するという——これは見逃しがたいユニークな切り口だ。
なぜ今、自宅RAGなのか
RAG(Retrieval-Augmented Generation)とは、LLM(大規模言語モデル)が回答を生成する前に、外部のドキュメント群から関連する情報を「検索して取得(Retrieve)」し、その内容を文脈として与える手法だ。これにより、モデルが学習時に持っていない知識や個人データに基づいた回答が可能になる。
クラウド型のRAGサービスも増えているが、自宅構築への関心が高まっている背景には複数の要因がある。GDPRをはじめとするプライバシー規制の強化でデータの外部送信リスクへの意識が上がったこと、OllamaなどのツールによりローカルLLMの実行ハードルが大幅に下がったこと、そしてクラウドAIへの個人データ提供に対する不信感の高まりがある。本記事はまさにその文脈に位置する実践報告だ。
筆者が既製品を使わなかった理由は明確だ。検索対象となるデータ(Gmail、WhatsApp、Slack、LinkedInのメッセージ、プライベートなメモ)はプライバシー上、外部サービスに渡したくない。ハードウェアはすでに手元にある(Ryzen 9 7900、RAM 122GB、GPU無し)。そして「実際に作って壊してみるまで本当には理解できない」という学習観がある。
スタック構成
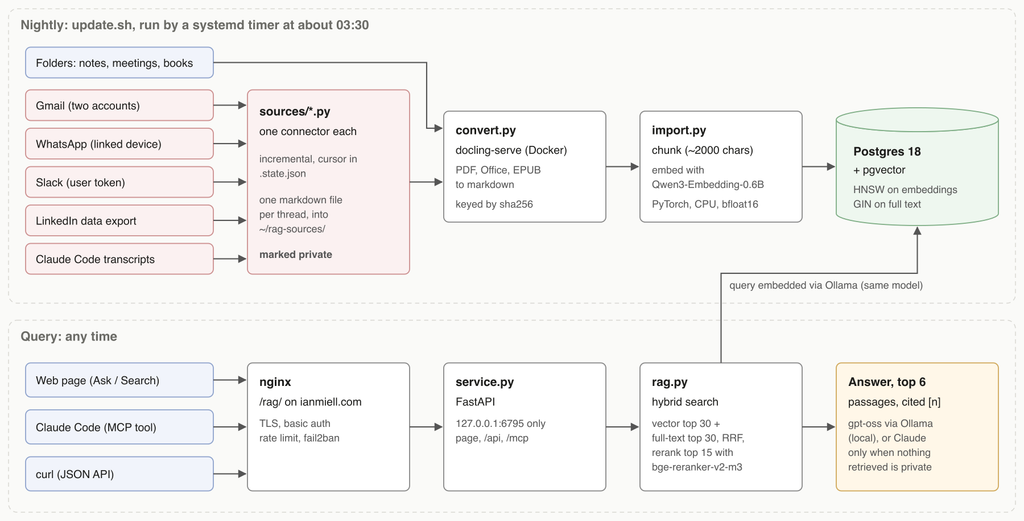
主要コンポーネントは以下の通りだ。
- コネクタ:ソースごとに1ファイルのPythonスクリプト。Gmail(公式API)、WhatsApp(whatsmeowを使ったリンクデバイス方式)、Slack(ユーザートークン)、LinkedIn(データエクスポートのZIPをパース)。
- 変換:docling-serveがPDF・Officeファイル・EPUBをMarkdownに変換。SHA-256で内容を照合し、同一ファイルの重複処理を排除。
- チャンキングと埋め込み:見出し単位で約2,000文字にチャンク分割し、Qwen3-Embedding-0.6Bで埋め込みベクトルを生成。
- ストレージ:Postgres 18 + pgvector。ベクトル検索用にHNSWインデックス(Hierarchical Navigable Small World:近似最近傍探索のための階層グラフ構造で、高速なベクトル類似度検索を実現する)、全文検索用にGINインデックスを併用。専用のベクターDBは使わない。
- 検索:ベクトル類似度上位30件と全文検索上位30件をRRF(Reciprocal Rank Fusion)でマージし、クロスエンコーダー型リランカー(bge-reranker-v2-m3)で上位15件を再順位付け。
- 回答生成:上位6パッセージをOllama上で動くオープンソースのローカルモデル(元記事では
gpt-ossと表記されているが、Ollamaで実行される汎称と読むのが自然だ)、またはプライベートデータが含まれない場合はClaudeに渡す。 - インターフェース:FastAPIでWebページ、JSON API、MCPエンドポイントを1つのアプリとして提供。Claude Codeからツールとしてノート検索が使える。
RRF(Reciprocal Rank Fusion)とは、異なる検索手法が返す複数のランクリストを統合するアルゴリズムだ。各ドキュメントの順位の逆数を合算してスコア化し、1つのランキングに融合する。実装はSQLとPythonで数行程度と軽量でありながら、検索品質を大きく改善できる。
クロスエンコーダー型リランカーとは、クエリとドキュメントのペアを同時にモデルに入力して関連度スコアを算出する手法だ。埋め込みベクトルを事前計算するバイエンコーダー型と異なり、ペアごとに推論が走るため精度は高いが低速になる。その速度面のトレードオフは後述する。
最も重要な教訓:ハイブリッド検索は必須
記事の中で最も実用的な知見がこれだ。「ベクトル検索だけで十分だろう」と思っていたが、そうではなかった。
コマンド名、フラグ、エラー文字列、ホスト名といったトークンの検索はベクトル検索が苦手で、全文検索が得意だ。意味的な類似性の検索はその逆。冒頭のxrandrの例では、正解ノートはベクトル検索で1位だったが全文検索では6位だった。別のクエリ(エラーメッセージや人名)では順位関係が逆転した。
「2つのランクリストをマージするのはSQLとPythonで数行だ。これを作るなら最初からやれ。」
CPU環境での落とし穴:モデルより実行方法が重要
GPUなし環境での埋め込み生成について、見落としやすい重要な知見が含まれている。
最初はOllamaで埋め込みを生成していたが、76,000チャンクの処理に「数日かかる」見通しだった。同じモデルをPyTorchで直接、bfloat16・12スレッドで実行したところ、約9倍高速になり、毎秒2〜3チャンク程度を処理できた。
ただし注意点がある。クエリの埋め込みはOllama経由(1文なので速い)、ドキュメントの埋め込みはPyTorch直接と使い分けているが、必ず同一モデルを使わなければならない。モデルが異なると、ベクトル空間が変わり比較が無意味になる。
リランカーのレイテンシも現実的な数字が示されている。検索単体では約0.6秒だが、リランカーを有効にすると約15〜18秒かかる。それでも上位3件の品質差が十分大きいため、常時有効にしているという。
インデックス対象を絞る判断
初回変換で約76,000チャンクが生成された。そのうち33冊のベンダーマニュアルPDFが約35,000チャンク、古いCSVが約16,800チャンクを占めていた。これらは結果を汚すノイズになるため、exclude.txtにglobパターンで除外リストを作成した。
Gmailは「自分が返信または送信したことがあるスレッドだけを取得する」というルール1つで、ニュースレター・領収書・スパムを追加フィルタなしに排除している。
セキュリティ設計
プライベートデータを扱うシステムの設計として、筆者は以下の原則を採用した。
- サービスは
127.0.0.1のみでリッスン。外部からのアクセスはnginx経由のTLS終端+Basic認証+fail2banのみ。 - OAuthトークン・Slackトークン・WhatsAppセッションは
~/.configと~/.local以下にモード600で保存。リポジトリには含めない。 - プライベートデータはローカルモデルのみで処理。取得した6パッセージのうち1つでもプライベートフラグがあれば、Claudeには渡さずローカルモデルが回答する。
Gmailの開発者同意画面では「アプリのホームページ」「プライバシーポリシー」「利用規約」へのリンクが要求されたため、ユーザーが自分1人のアプリのために3つの静的ページを公開することになった、という笑えない実態も記されている。
副次的な使い方:過去の自分を検索する
構築後に気づいた用途として、先月・先四半期・昨年に自分が何をやっていたかを振り返るレビュープロセスへの活用が挙げられている。全データが一箇所に集まったことで、ローカルモデルに問い合わせて要約させるだけで実行できるようになった。メッセージ・メモ・ドキュメントが横断的に検索できるシステムは、単なる情報検索ツールを超えて「自分の活動ログ」として機能する。プライバシーを守りながら自己振り返りを自動化したい人にとって、この観点は本構成の説得力をさらに高める。
詳細はWhat I Learned Building a RAG Server on my Home Server – zwischenzugs.comを参照していただきたい。