11月5日、The Decoderが「New open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operations」と題した記事を公開した。AIエージェントの失敗原因の約80%が「推論の欠如」に起因し、トップモデルでも正答率が60%止まり——クラウド運用ベンチマーク「CloudOpsBench」が明らかにしたこの数字は、現在のLLMエージェントが抱える構造的な限界を浮き彫りにしている。
AIエージェントはDevOpsタスクの何割を解けるか
CloudOpsBenchは、AIエージェントが典型的なクラウド運用タスクをどれだけ処理できるかを測定する新しいオープンソースベンチマークだ。バージョン1.0にはAWSを対象とした45のタスクが収録されており、いずれも経験豊富なDevOpsエンジニアによって設計された。
タスクの内容は実務に即したもので、障害サービスの修復、リソースの削除、アクセス権の制限、アップデートのロールアウト、プロジェクトの廃止処理といった操作が含まれる。単なるコマンド生成ではなく、複数のサービスにまたがる状態の確認・判断・実行を伴う点が特徴だ。
トップモデルでも正答率60%止まり
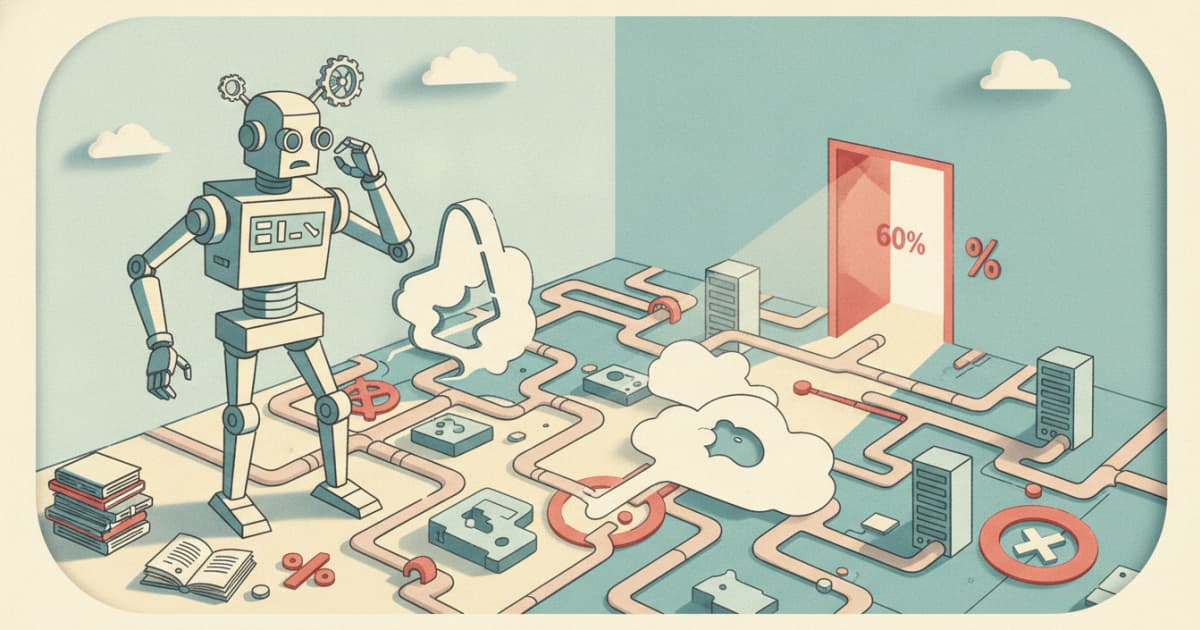
ベンチマークの結果は厳しい。元記事によると、評価対象となったモデルの中で最高スコアを記録したモデルでも正答率は**60%、次点のモデルは53%**にとどまった。どのモデルも全タスクを完走できていない。
※編集部注:元記事に記載のモデル名については、記事公開時点の情報を元記事原文で直接ご確認いただきたい。本稿では誤記・誤訳のリスクを避けるため固有名称を省略している。
ミシガン大学のAng Chenらの研究チームによる分析では、失敗の原因は「知識の不足」ではなく「推論の欠如」にあることが明らかになった。失敗全体の**約80%**は以下のような推論ミスに起因する:
- タスクのスコープ(範囲)を誤って判断する
- 関連するサービスをすべて確認しない
- 処理を途中で早期終了してしまう
残り約20%は誤った操作の実行であり、一部はインフラに取り消し不能な影響をもたらすケースも含まれる。

「知識があっても推論できない」という構造的な問題
この結果が示すのは、現状のAIエージェントがクラウド運用において直面している課題の本質だ。LLM(大規模言語モデル)はAWSのドキュメントや操作手順を学習済みであっても、「どのサービスまで確認すべきか」「ここで止めるべきか続けるべきか」といった状況判断で躓く。
ここでいう「推論の欠如」とは、単純な知識問答での誤りではなく、タスク全体を計画・分解し、途中の状態を評価しながら次の行動を決定する能力の不足を指す。LLMエージェントの実装では、思考ステップを明示させるChain-of-Thoughtプロンプティングや、「思考→行動→観察」のループを繰り返すReActフレームワークがこの能力を補う手法として広く用いられている。しかしCloudOpsBenchの結果は、現時点ではそうした手法を組み込んでいても、マルチステップのクラウド運用タスクでは限界があることを示唆している。
また、LLMエージェントがAWSのCLIやAPIをツールとして呼び出すツール呼び出し(Function Calling)アーキテクチャにおいては、個々のツール呼び出しの精度よりも、どのツールをどの順序で呼び出すかという計画立案能力がボトルネックになっているという今回の知見は、エージェント設計において重要な示唆を持つ。
特に80%が推論起因というデータは、ファインチューニングや追加学習でカバーしにくい領域に問題があることを示唆している。ツール呼び出しの精度よりも、タスク全体を俯瞰する能力がボトルネックになっている。
実環境とエミュレータで同一タスクを実行
CloudOpsBenchの設計上の特徴として、すべてのタスクが実際のAWSクラウド上とエミュレータ上で同一条件で動作する点がある。これにより、エミュレータでのみ通用する解法を排除し、実運用に近い条件での評価が可能になっている。ローカルモックでスコアが高くても実環境で崩れるという、既存ベンチマークの課題に対する設計上の回答といえる。
GCP、Azure、OCIへの拡張も計画されており、マルチクラウド対応が進めば比較評価の幅が広がる。
プロジェクトはGitHub上でApache 2.0ライセンスで公開されている。失敗パターンの詳細な分析レポートについては元記事内のリンクを参照されたい。
詳細はNew open-source benchmark reveals reasoning as the biggest bottleneck for AI in cloud operationsを参照していただきたい。