11月7日、Callstackが「Building a Software Factory: Write Specs an AI Agent Can Build From」と題した記事を公開した。AIコーディングエージェント(コードの実装・テスト・PR提出を自律的に行うAIツール)が途中で止まらず動き続けられる「ソフトウェアファクトリー」を実現するために、仕様書(スペック)をどう書くべきかを体系化した内容だ。
エージェントが自律稼働し続けるための仕様書
本記事はCallstackのシリーズ「Building The React Native Software Factory」の第2弾だ。著者はCallstackがメンテナンスするオープンソースツール「Simlock」に、実機iPhone/iPad/Androidへの対応機能を追加した際の経験をもとに、AIエージェント向けスペックの書き方を体系化している。
Simlockはシミュレーターおよび実機デバイスの予約・管理を行うデバイス管理ツールだ。エージェントがデバイスを借り、アプリを実行・テストし、次のエージェントへ返却するまでのライフサイクルを管理する。第1回では、承認済みスペックにプロダクト上の決定事項が漏れており、エージェントが一晩中人間の判断を待ち続けた失敗談が語られた。今回はそこから得た教訓をプロセスに落とし込んでいる。タイトルの「夜中に止まらない」はこのエピソードに由来する。
一番の肝:「計画会話」と「スペック」を分離する
著者のワークフローでは、計画エージェントとの会話の内容をそのまま実装エージェントに渡さない。計画会話には試行錯誤や廃棄されたアイデアが混在しており、実装エージェントがどの部分を採用すべきか判断できなくなるためだ。
代わりに合意した仕様のみをGitHub Issueに記録し、実装エージェントはそのIssueだけを読んで作業する。ユーザーからのリクエストと、エージェント向けのスペックIssueは別々に管理し、リンクで紐付ける。

「質問ラウンド」で意思決定を構造化する
スペック作成プロセスで特に実践的なのが、質問をラウンド制で整理するアプローチだ。
現在のインタビュー指示では:
- 各質問は1つの意思決定に対応し、推奨案・代替案・それぞれのコストをセットで提示する
- 独立した質問は同じラウンドにまとめ、ある回答が別の質問に影響する場合はその回答を待ってから次の質問をする
- エンジニアが理解できていない選択肢については、図・コマンド出力・コードサンプルで説明させてから再度質問する
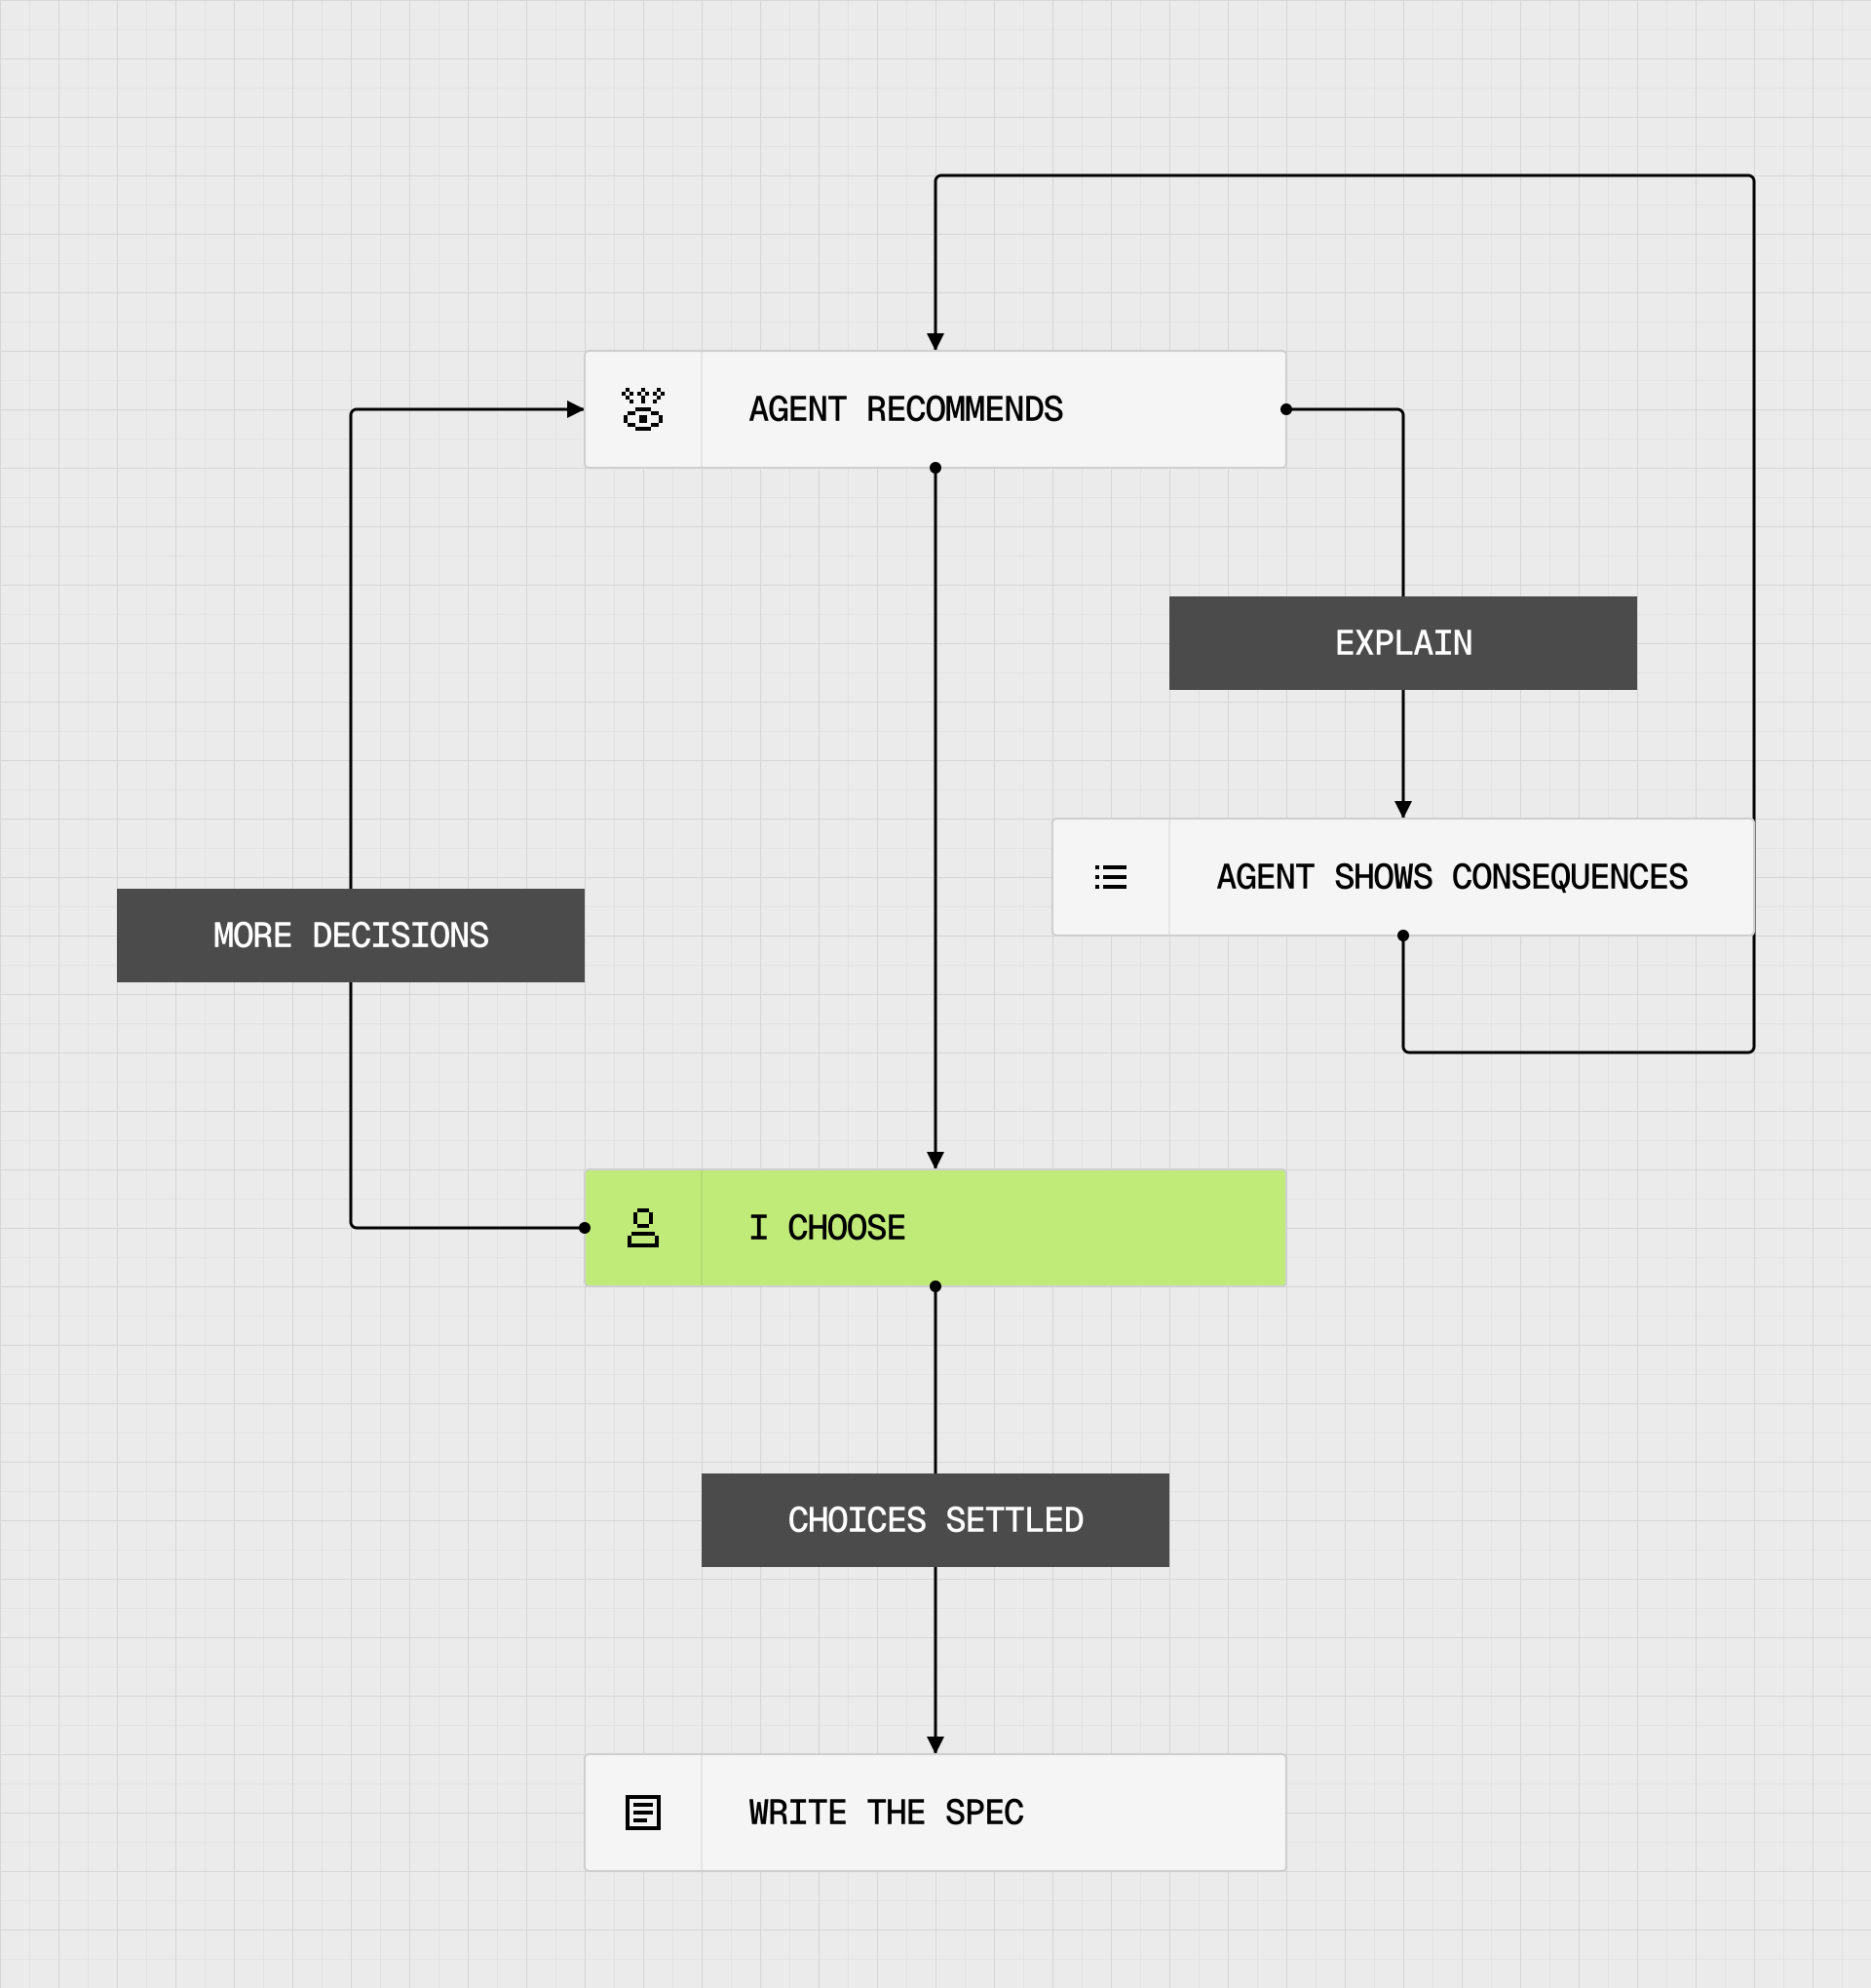
Simlockの実機対応でいえば、「返却後の端末クリーンアップをどうするか」という問題がある。エージェントは「アプリのアンインストール+再起動」を推奨したが、「再起動後にパスコード保護されたiPhoneは次のエージェントが使えない」という問題を著者が指摘し、再起動なし・ワイプなし・追加アプリのみアンインストールという方針に落ち着いた。推奨案を出させることで「何がマズいか」を具体的に議論できた点が重要だ。
スペックに書くべき3つの要素
Simlockのフィーチャースペックでは、クリーンアップの定義を次のように整理している。
| スペックの部分 | クリーンアップの例 | 答える問い |
|---|---|---|
| 定義 | エンロール時にないアプリを削除 | 「返却」とは何か |
| 非目標 | ワイプ・再起動はしない | この変更の範囲外は何か |
| 完了条件 | 次の貸し出し前に追加アプリが消えていること | 完了をどう確認するか |
またフィーチャーテンプレートには「誰が必要か」「どう使うか」「失敗時に何が見えるか」を記述する欄がある。UIユーザーだけが必要な機能なら、CLIやAPIへの実装は非目標として明示的に除外できる。
タスク分割と「2段階チェック」
大きなフィーチャーはエージェント向けに小さなタスクに分割し、それぞれがGitHub Issueとして管理される。タスクは1エージェントが実装・テスト・PR提出できる粒度にする。長いセッションは要件が文脈に埋もれるリスクがあるためだ。
各タスクにはFactsテーブルを設ける。これは仕様が依拠するコマンドやフラグなどの根拠を、ソースの場所(コミット単位)やコマンド出力とともに記録するものだ。存在しないフラグや、別ツールが拒否する識別子をスペックに書いてしまう問題を防ぐために追加された。
チェックは2段階構成だ:
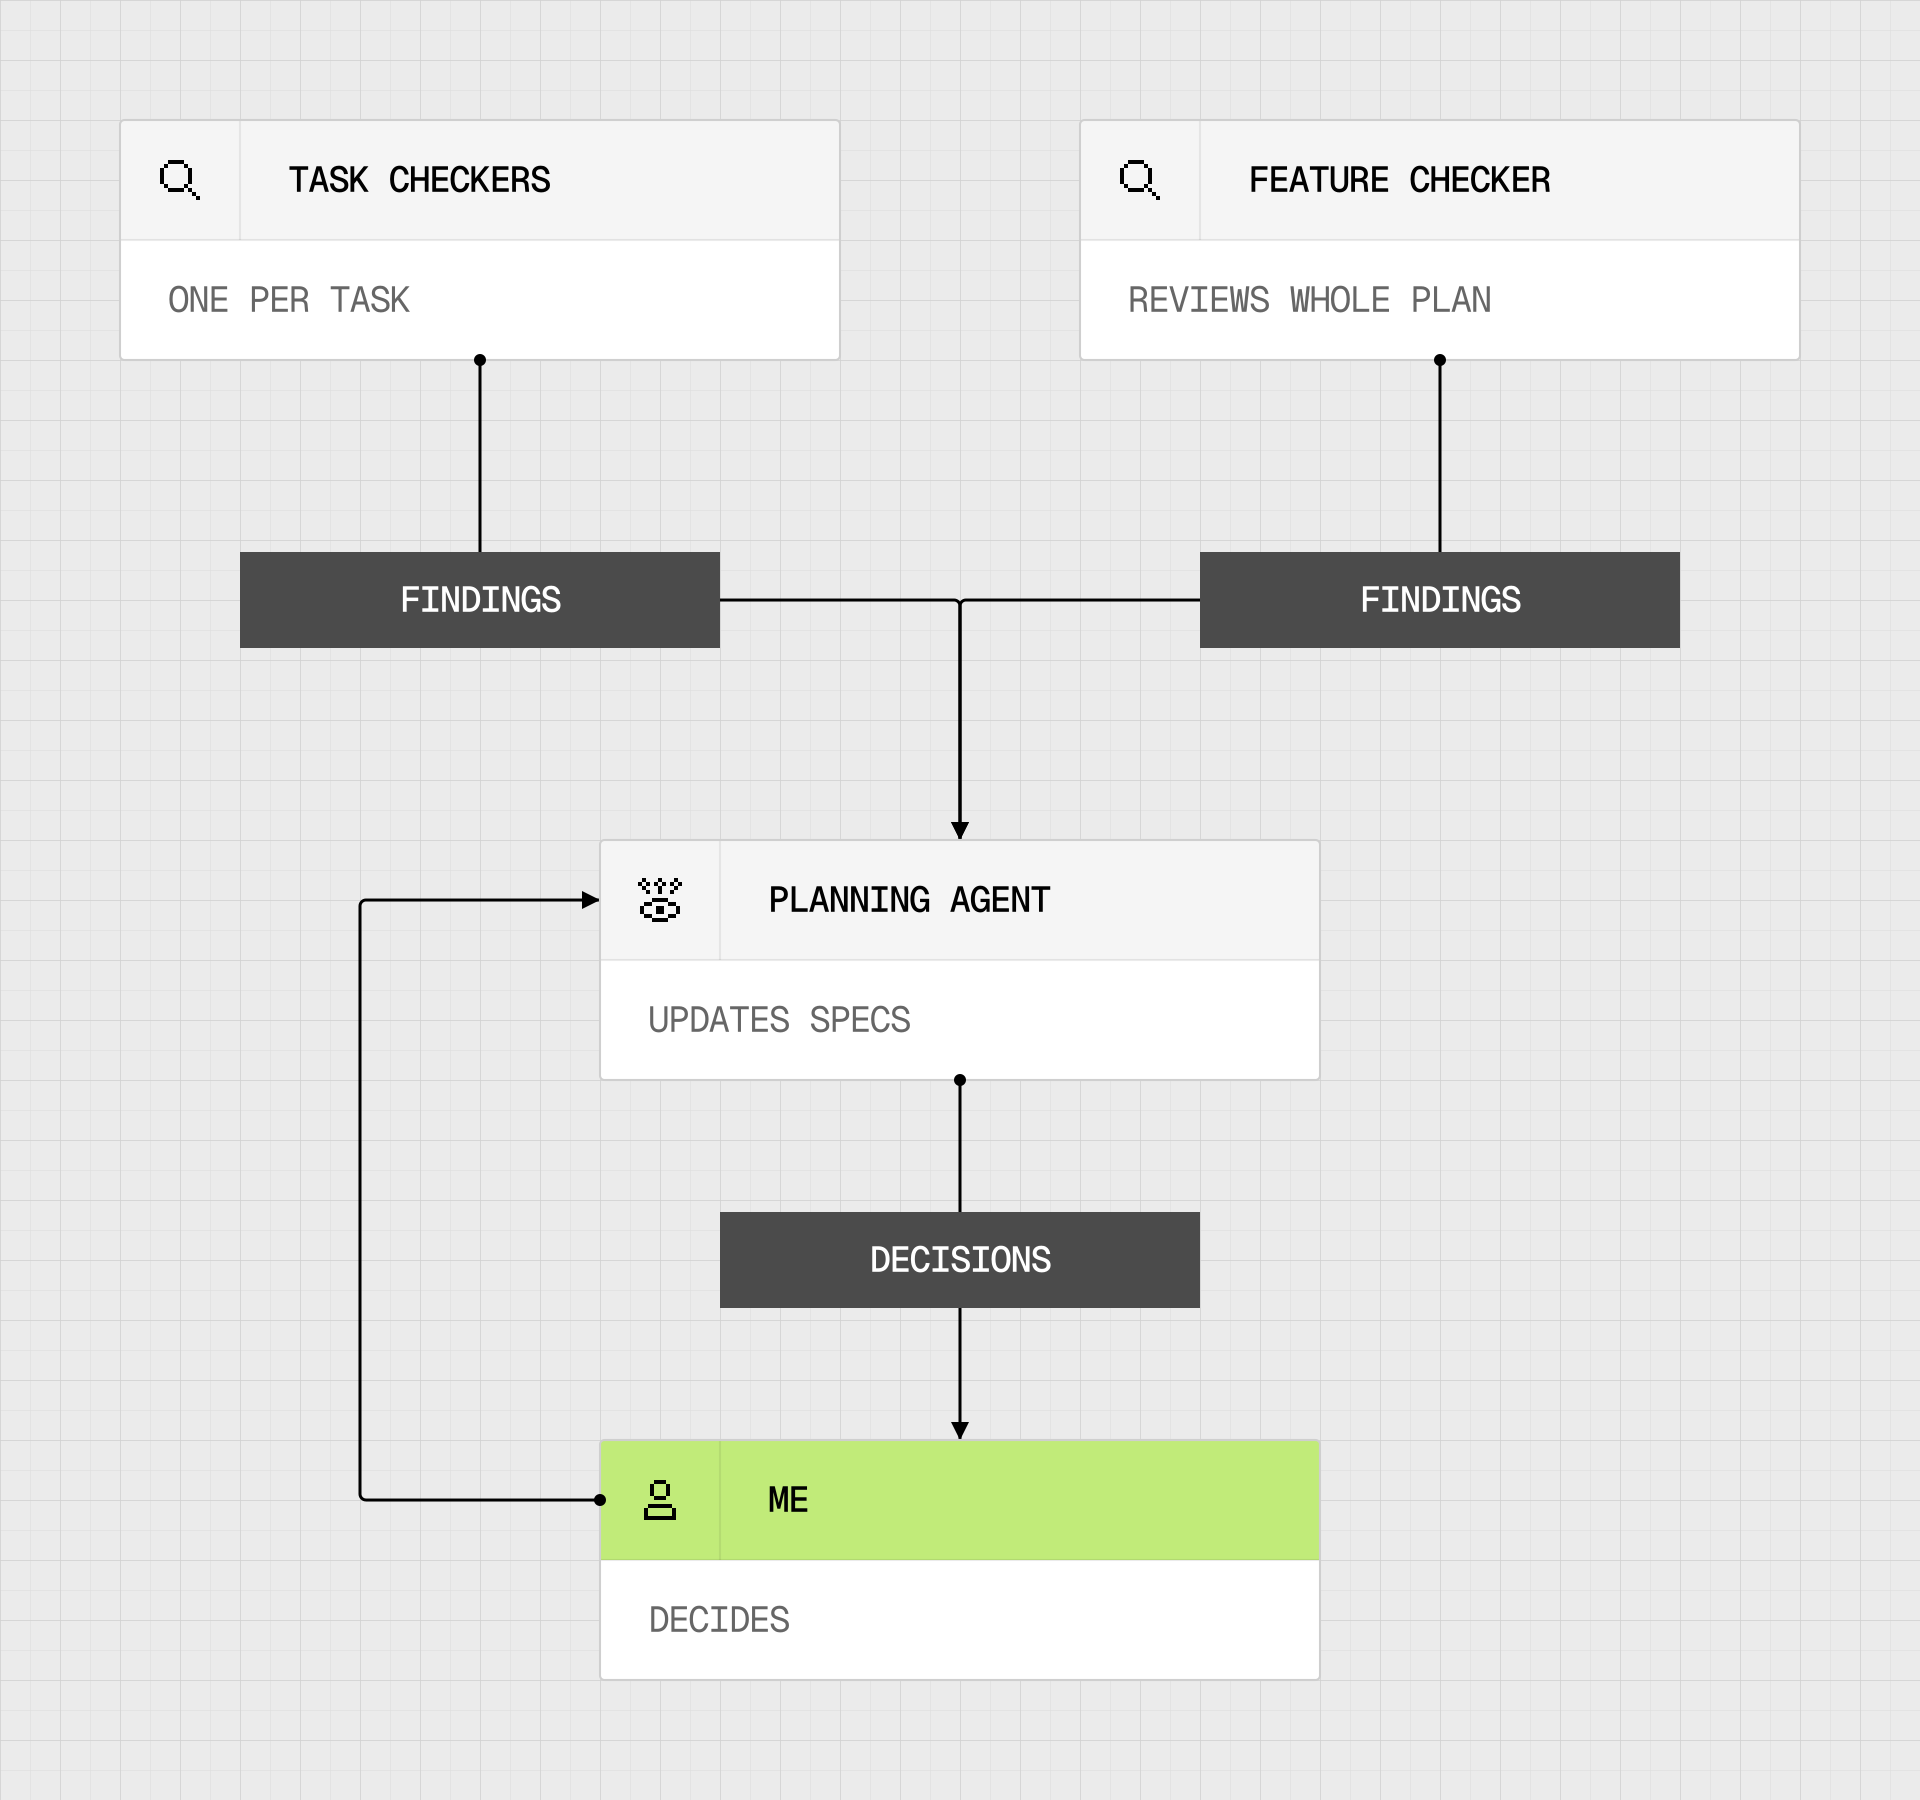
- フィーチャーチェッカー:スペック全体を読み、未解決の意思決定を探す
- タスクチェッカー:各タスクの技術指示とテスト、タスク間の整合性を検証する
チェック前には自動化されたスペックリント(spec lint)が走り、セクションの欠落・プレースホルダー・壊れたソース参照・依存サイクルを機械的に検出する。これにより、エージェントによるレビューは「計画が機能するかどうか」に集中できる。
実際にSimlockの実機対応で、チェッカーがAppleのdevicectlコマンドを調査した結果、ホストのファイルをスマートフォンのクリップボードにコピーして読み取るルートが見つかり、当初の制限設計では許容されてしまうことが判明した。実装前にスペックを修正し、使用可能なコマンドを審査済みリストに限定できた。
タスクのテスト方針
Simlockでは1タスクあたり約10件の振る舞いベースのテスト要件を目安にしている。振る舞いベースのテストとは、内部実装ではなく「システムが外から見てどう振る舞うか」を検証するアプローチで、BDD(Behavior-Driven Development)的な考え方に近い。これを大きく超える場合は、独立してビルド・テストできる振る舞いに分割できないか検討する。
テストは実機なしでも動かせるよう、プラットフォームのレスポンスをシミュレートする形で設計する。また「この要件が壊れていても、このアサーションはパスしてしまわないか」をチェッカーが確認する。クリーンアップ機能であれば、「クリーンアップ関数が成功を返した」だけを確認するテストでは、実際にアプリが消えているかどうかを検証できないからだ。
詳細はBuilding a Software Factory: Write Specs an AI Agent Can Build Fromを参照していただきたい。