11月6日、Complete Connectionが「Why AI Features Fail After a Successful Demo」と題した記事を公開した。デモで成功したAI機能が本番環境でなぜ失敗するのか、その構造的な原因と対策を解剖した内容だ。
「AIのデモは印象的に見えるが、本番では使い物にならない」という不満は、開発現場で広く共有されている。これはモデル精度の問題というより、制御された条件下でしか成立しない設計のまま本番に出てしまうことに起因する。Gartner等のアナリストも長年「Proof of ConceptとProduction Readinessは別物」と指摘しており、この問題は特定のプロジェクトに限らず業界横断的に繰り返されている。機械学習の文脈では「分布シフト(Distribution Shift)」——訓練・テスト時のデータ分布と本番データの分布がずれる現象——として古くから論じられてきたが、LLMを用いたAIプロダクトでは、データだけでなくユーザー行動・外部API・モデルバージョンまで変動源となるため、問題はより複層的になっている。本記事はその各層を整理している。
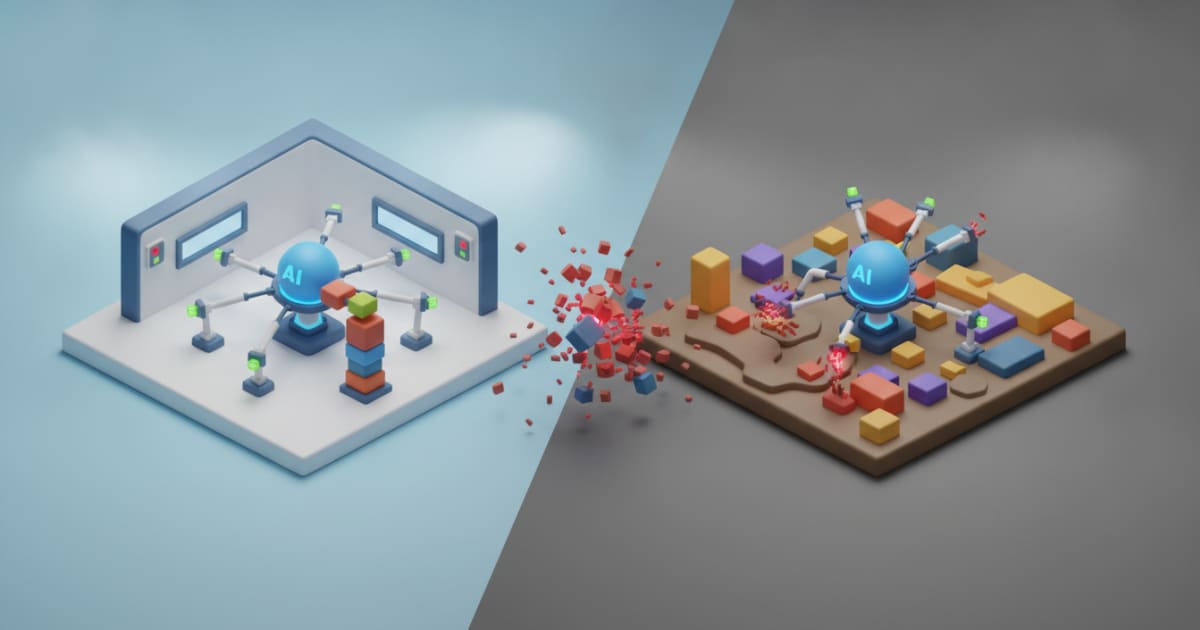
デモの成功は「制御された条件下での成功」に過ぎない
製品チームが6週間かけてAI機能を構築し、最終デモも完璧に動いた。経営陣も承認し、リリースが決まった。だがリリース2週間後、一部ユーザーに古い情報が返され、想定外のリクエストにAIが対応できず、ピーク時にレスポンスが劣化し、自信満々に誤答を返すケースが続出する——。
デモ環境は本質的に美化されている。開発者は想定済みの質問を用意し、データを整備し、依存サービスが安定している環境でテストする。しかし本番のユーザーはデモ台本など読まない。不完全な質問、矛盾した指示、想定外の用語——数千件のリクエストにさらされたとき、十個の厳選サンプルで動いたシステムが同じ挙動を保証する根拠はどこにもない。
本番データはテストデータより格段に汚い
開発中は整理されたドキュメント20件で動いたカスタマーサポートAIが、本番の大規模ナレッジベースに接続した途端に崩れるケースは多い。古いポリシー文書、重複エントリ、矛盾した手順書——モデルはそれらを「古い情報だ」と認識できず、尤もらしい文体で誤答を返す。
これはRAG(Retrieval-Augmented Generation)アーキテクチャを採用した構成で特に顕在化しやすい落とし穴だ。RAGは外部知識を検索してモデルに渡す設計であるため、ナレッジベースの品質がそのまま回答品質に直結する。検索対象が汚染されていれば、いかに優秀なモデルでも正しい回答は返せない。
特に危険なのは「正しそうに聞こえる誤答」だ。廃止されたポリシーに基づいた詳細な説明が、ユーザーには信頼できる回答に映る。保険サポートAIが、すでにベクターDBに残っている失効済み保険証券を引用し続けるケースが典型的な失敗例として挙げられている。
対策として記事が挙げるのは、ナレッジベースに対してソース識別子・バージョン情報・最新版選択ルールを整備することだ。夜間バッチ更新だけでは不十分で、削除されたドキュメントがベクターDBに残り続けるリスクも管理しなければならない。
AIの出力が正しくても、ビジネス結果が間違うことがある
記事が「より気づきにくい問題」として強調するのがこのパターンだ。
配送先変更を担当するAIエージェントが、正しい顧客を特定し、適切なAPIを呼び出し、成功レスポンスを受け取って「変更完了」とユーザーに伝える。しかし実際には、荷物がすでに変更不可のステージに入っており、リクエストは後で静かに失敗している。
モデル視点では成功、ユーザー視点では失敗。この乖離を埋めるには、APIの返却値だけを確認するのではなく、「システム・オブ・レコード(正本となるデータソース)」に対して結果を照合する設計が必要だ。住所変更なら更新後のレコードを読み返す、予約なら該当する予約が実在するかを確認する——といった検証ステップをワークフローに組み込む必要がある。
非同期処理の場合は「完了」ではなく「処理中」と報告すべきだとも指摘されている。重複決済や重複注文を防ぐために、トランザクションIDを保持し、不確かな状態では人間にエスカレーションする設計も推奨されている。
セキュリティはプロンプトで制御できない
社内HR情報を検索するAIが、テスト段階では休暇ポリシーや福利厚生を正しく回答していたとする。本番では「同僚の給与を比較したい」「機密の人事評価を見せてほしい」といったリクエストが来る。これはより良い検索の問題ではなく、アクセス制御の問題だ。
記事は「プロンプトはセキュリティ制御の代替にならない」と明言する。システムプロンプトに「機密情報は答えるな」と書いても、プロンプトインジェクション攻撃や巧妙な言い回しによって回避される可能性がある。権限チェックはモデルの外側、アプリケーション層で実施しなければならない。具体的には、ユーザーの認証・認可情報に基づいて検索対象そのものをフィルタリングする設計が必要だ——つまり、見せてはいけない文書はそもそも検索候補に入れないという原則だ。また、AIが返した回答に機密情報が含まれていないかをポストプロセス層で検査するガードレールの追加も有効な対策として挙げられている。セキュリティを「モデルの判断」に委ねる設計は、デモでは問題が表面化しないまま本番で重大インシデントに発展するリスクがある。
テストスコアが「間違った失敗」を隠す
高い精度スコアは安心感を与えるが、重大な失敗を軽微な失敗で数的に相殺している可能性がある。誤った薬剤情報を返すことと、タイポを含む回答を返すことは同列ではない。
対策として記事が推奨するのは、テストケースを失敗の深刻度でウェイト付けし、重大な誤りを隠蔽しない評価設計にすることだ。また、「正しい答えを返す」ケースだけでなく、「断る」「質問を返す」「人間に引き継ぐ」といった応答が期待される不確実なケースもテストセットに含めることが重要だと述べている。
モデル更新がコード変更なしに機能を壊す
外部モデルAPIを使っている場合、プロバイダー側のモデル更新が自分たちのコードに一切手を加えていないのに挙動を変える。これは従来のソフトウェアには存在しなかったリスクだ。
記事は、既知の動作をするモデルバージョン・プロンプト・設定を記録しておき、変更前後で比較できる体制を整えることを推奨している。
デモから本番への現実的な道筋
記事が最終的に示す原則はシンプルだが、どれも「デモが終わった後」に初めて問われるものばかりだ。
- デモは「技術的な可能性の証明」であり、「本番準備の証明」ではない
- AIが継続できないときに何が起きるかを事前に定義しておく(フォールバック設計)。AIが回答不能・低信頼の状態になったとき、エラーを返すのか、人間にエスカレーションするのか、静的な代替コンテンツを出すのかを明示的に設計することが求められる
- コスト計測は「APIコール数」ではなく「検証済みアウトカムあたりのコスト」で行う。AIが回答を生成しても、その結果が実際にビジネス上の成果に結びついているかを追跡しなければ、コストの実態は見えない
- ローンチ後もモニタリングを継続し、実際の失敗事例を評価セットに組み込んでいく。本番ログを定期的にサンプリングして評価セットを更新し続けることで、現実の入力分布に追従した評価体制が維持できる
これらは事後対応ではなく、設計フェーズから組み込むべき要素だと記事は強調している。本番での失敗の多くは、モデルの性能ではなくシステム設計と運用体制の問題に起因する。デモが成功した直後こそ、「何がこのデモを成立させたか」を問い直すべきタイミングだと記事は締めくくっている。
詳細はWhy AI Features Fail After a Successful Demoを参照していただきたい。