11月7日、Kiro.devが「How Kiro Auto uses model cascading to match the model to the work」と題した記事を公開した。この記事では、AIコーディングアシスタント「Kiro」のAutoモードが採用する「モデルカスケード」という技術——セッションの難易度に応じてモデルを動的に切り替えるアーキテクチャ——について詳しく紹介されている。
モデルは最初から決めなくていい
LLMを使ったコーディングエージェントで生じる典型的なジレンマがある。強力なモデルを最初から使えばコストが嵩む。非力なモデルを選べば複雑なタスクで詰まる。しかし、タスクの難易度は開始時点では分からない。「日付パーサーのバグ修正」が、タイムゾーン前提の問題として3つのモジュールに波及するリファクタリングに化けることもある。逆に、大きく見えたタスクが2行の変更で終わることもある。
Kiroが採用したアプローチは「セッション開始時にモデルを1つ選ぶ」のをやめることだ。
カスケードの仕組み
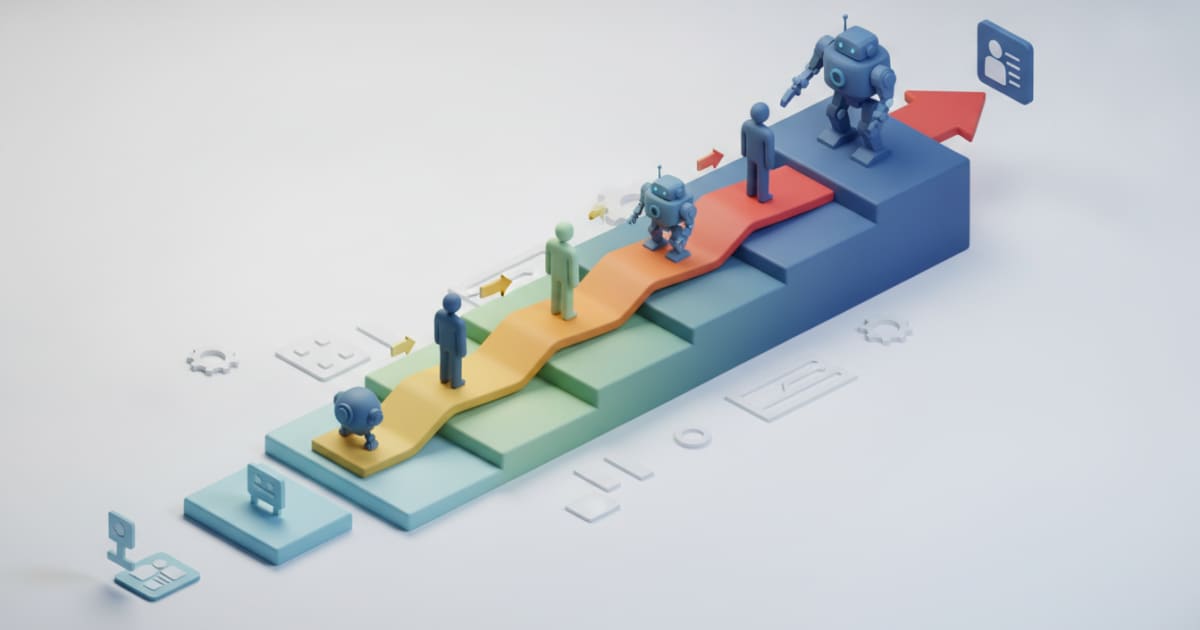
モデルカスケードとは、1回のエージェントセッション中にモデルを段階的に切り替える手法だ。Kiro Autoは以下の4ステップで動作する。
軽量モデルからスタート。 全セッションは初期モデル(efficient initial model)で始まる。多くのタスクはこのモデルだけで完結する。
バックグラウンドで独立レビュー。 セッションとは別のモデルが、非同期でこれまでの作業軌跡をレビューする。セッションはこのチェックを待たずに進行し続ける。作業中のモデルが自分の進捗を自己採点しない点が重要だ。
ハンドオフ。 チェックが「同じコードを繰り返し探索している」「完了済みの作業をやり直している」といった非効率の兆候を検出したとき、より高性能なモデルにセッションを引き継ぐ。引き継ぎはそれまでの作業内容を持ち越すため、最初からやり直しにはならない。
必要なら繰り返す。 最上位モデルに達するまで繰り返せる。現時点では上方向のみ(下位モデルへの引き戻しは将来の課題)。
「チケットに取り組むエンジニアと、傍らでレビューする人間」というアナロジーが記事中で使われている。エンジニアは自分の進捗を自分で採点しない——それはレビュワーの仕事だ、という設計思想だ。
ベンチマーク結果:タスクの8割は初期モデルで完結し、残り2割でハンドオフが発生する
KiroチームはDeepSWE v1.1で3つの構成を比較評価した。DeepSWE v1.1はDatacurveが公開する長期ソフトウェアエンジニアリングベンチマークで、実際のGitHubリポジトリから収集した複数ステップにわたるタスクを対象に、エージェントの問題解決能力を測るものだ。SWE-benchと並んでコーディングエージェント評価の文脈で参照されることが多い。各構成はベンチマーク全体を3回独立して実行している。
| 構成 | pass@1(平均 ± 標準偏差) |
|---|---|
| 初期モデル単独 | 63.96% ± 2.70 |
| 高性能モデル単独 | 70.57% ± 2.08 |
| カスケード(初期→高性能) | 69.37% ± 1.56 |
カスケードは69.37%を達成した。高性能モデル単独(70.57%)とほぼ同等(差は誤差範囲内)で、初期モデル単独(63.96%)より5.40ポイント上回る。さらに、3回の実行間でのばらつきが最も小さかった。
タスクの内訳も重要だ。80.48%のタスクは初期モデルだけで完了し、ハンドオフが発生したのは19.52%(約5タスクに1つ)にとどまった。
ハンドオフが発生したタスクには共通の傾向があった。型・API・CLI・設定など複数レイヤーにまたがる変更や、キャッシュ・状態保存・実行順序に依存する挙動など、全体を通して正確に動かすことが難しい変更だったという。
エンジニアとして気になるポイント
このアーキテクチャで設計上の肝となるのは独立チェック(independent check)の存在だ。作業モデルとは別のモデルがセッションを監視することで、「自分の出力を自分で評価する」という自己採点バイアスを排除している。LLMが同じ場所をぐるぐると試行し続けるいわゆる「ループ問題」への対策として、外部オブザーバーを非同期で走らせる構成は実装上の参考になる。
なお、チームやエンタープライズ向けにモデルガバナンスの仕組みも用意されており、管理者がAutoで使用可能なモデルを制御できる。ハンドオフ先も同じガバナンス設定に従う(詳細はモデルガバナンスドキュメントを参照)。
詳細はHow Kiro Auto uses model cascading to match the model to the workを参照していただきたい。