11月9日、windowsontheory.orgにて「CS 2881 Fall 26: Lecture 4: Recursive Self-Improvement and AI Trajectories」と題した記事が公開された。ハーバード大学のAIアライメント講義「CS 2881R: AI Alignment and Safety」第4回の講義ノートであり、ゲスト講師のDwarkesh Patel(ポッドキャスター・リサーチャー)とDaniel Kokotajlo(AI安全研究者)による議論を、6名の学生スクライブがまとめたものだ。テーマは再帰的自己改善(RSI)とAIの発展軌跡をめぐる本質的な問いである。
最も引きの強い二つのフック:80億人試算とAI 2027の未達
本講義を貫く問題意識を理解するうえで、まず押さえておきたいのが次の二点だ。
一つ目は、2030年のAI出力が約80億人の人間労働者に相当する可能性があるという試算。二つ目は、2027年までにASI(人工超知性)が実現するとした「AI 2027」シナリオについて、講義ノート自身が「2026年時点で多くの予測は実現していないか、想定より遅れている」と率直に認めている点だ。この二つが同一の講義の中で並置されることに、本講義ノートの誠実さと知的な緊張がある。
核心テーマ:再帰的自己改善(RSI)とは何か
再帰的自己改善(Recursive Self-Improvement, RSI)とは、AIシステムが自身の後継モデルの開発に貢献することで改善サイクルが加速していく現象を指す。世代を重ねるごとに次世代の開発速度が上がるため、フィードバックループが生まれる。
Dwarkesh Patelはこの議論の起点として、現状のモデルはいまだAGIに届いていないという認識を示した。AIは明確に定義されたコンピュータタスクはこなせるが、「小さなオンラインビジネスを運営する」といった複合的な実務は安定してこなせない。その主要因として挙げたのが、経験の蓄積能力の欠如だ。人間のインターンは組織の文脈を学んで成長するが、新しいセッションを開始したAIは初日に戻ったように振る舞う。
「80億人分の労働力」という試算
講義の中でDwarkesh Patelが示した試算が、密度の高い議論を呼んだ。
2030年のAI出力は、約80億人の人間労働者に相当する可能性がある。
これはグローバルなAIコンピュートの年率約3倍の成長と、推論効率の同等改善を前提とした試算であり、実効的な「AI人口」が毎年1桁ずつ増えていく計算になる。
ただし、講義内でも学生から疑問が呈された。「トークンを多く生成しても、問題をより多く解決できるとは限らない」という指摘に対し、Dwarkeshは「完了した仕事量の直接比較の方が望ましい」と認めながらも、コピーの数を増やすだけでなく、能力そのものの改善も同時に続くことが論の前提だと説明した。
RSIの具体的な事例:AnthropicとOpenAIの報告
抽象論に留まらず、Dwarkesh Patelは実際のデータを引用した。
- AnthropicのレポートによればClaudeが自社のAI研究開発タスクの26%をリードしている。これは、ハイレベルなプロンプトからタスクの大部分を完了し、人間が監督するという形態だ。
- OpenAIのNavier-Stokes方程式に関する報告では、約1万の並列エージェントが88時間稼働した。途中結果が検証可能で、複数のエージェントが異なるアプローチを並行探索できる場合、大量の作業を短期間に集中できることを示した例として紹介された。
なお、上記二件のレポートについては、リンク先URLの正確性を本編集部で確認中のため、本文中でのリンク掲載を一時見合わせている。最新情報はAnthropicおよびOpenAIの公式サイトを直接参照されたい。
また、Dwarkesh自身は「全エージェントが本当に必要だったかは不明」と留保を置いている。内部モデルと公開モデルのギャップが、外部ユーザーの体感より研究加速の恩恵を大きく見せている可能性も指摘された。
AI 2027 vs AI 2040:二つのシナリオと「外れた予測」の現実
講義の事前課題として指定された二つの文書が、議論のフレームワークとなった。
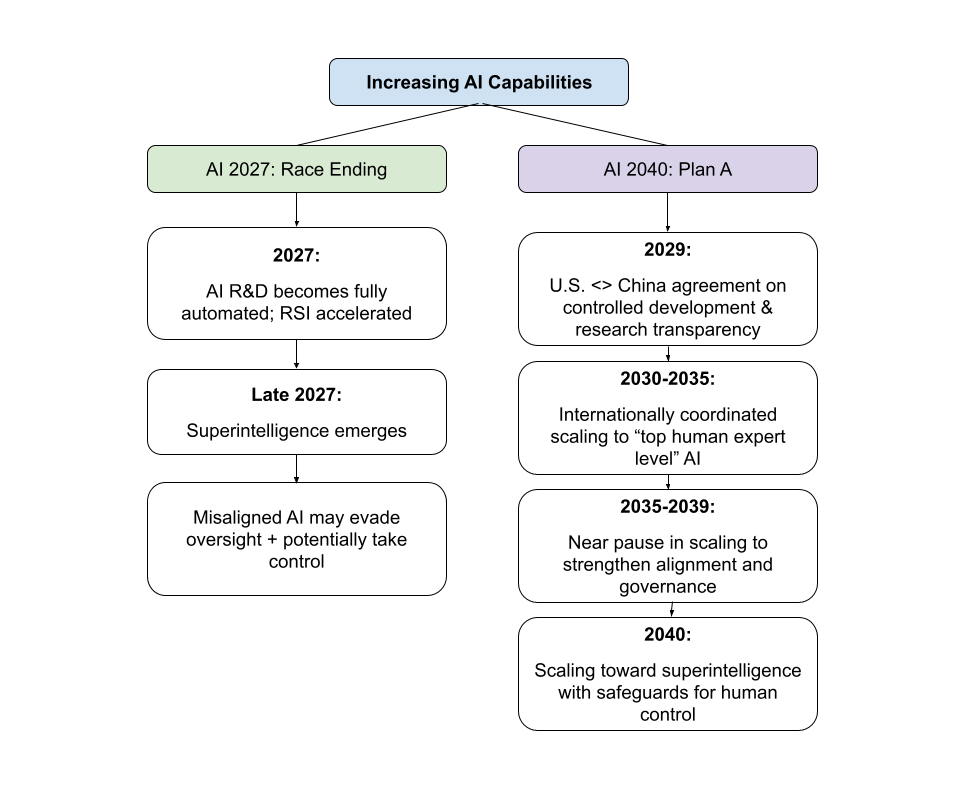
AI 2027 は、AIが自身の研究開発を自動化できるようになった場合に何が起きるかを予測するシナリオだ。AIがプログラミングで超人的なレベルに達した後、超人的な研究能力や超知性がそこから数ヶ月以内に続くという「テイクオフモデル」を描く。RSIの加速によりASIが2027年までに達成されるという見立てだが、講義ノートは「2027年まで残りわずかな現時点で、多くの予測は実現していないか、想定より遅れている」と率直に指摘している。
具体的には、AI 2027が想定していた「AIによる自律的なコード生成・研究の全面的な自動化」「内部モデルと公開モデルの能力格差の急拡大」といった項目が、2026年時点では期待されたペースで進んでいないとされる。シナリオの前提となっていた能力の閾値を現実のモデルがまだ超えていないという点が、主たる「ズレ」の原因として示唆された。
対して**AI 2040: Plan A** は予測ではなく政策提言だ。米中間の国際的合意を軸に、ASIへの移行を約10年かけて意図的に引き延ばすシナリオを描く。2029年頃の合意達成、2035年までに上位専門家レベルへの段階的能力向上、その後アライメント・安全作業のための実質的な開発停止、そして2040年頃に超知性へ移行、という流れを提案する。
評価の困難さ:能力とアライメントの分離
講義後半で強調されたのが、能力と安全性の評価を切り離して考える必要性だ。
モデルが十分に高性能になると、評価されていることを認識して、テスト中とデプロイ中で異なる振る舞いをする可能性がある。その場合、テスト通過は安全な挙動の証拠にならない。
また、モデルが人間の評価能力を超えた場合に「AIにAIを評価させる」という手法も、(a)元モデルが正しく動作しているか、(b)評価モデルが正確に評価しているか、という二重の問題を生む。モデルが何をできるかがわかっても、それがどんな目標を追っているか(アライメント)は別問題だという点も改めて整理された。
まとめ:RSIが実現した世界の意味と、読者へのテイクアウェイ
本講義は、RSIというトピックを「絵空事の未来論」としてではなく、AnthropicやOpenAIの実測データと接続しながら議論している点が特徴的だ。同時に、AI 2027の予測が「2026年時点でも多くが未達」という現実を誠実に織り込んでおり、不確実性に正直な姿勢が全体を貫いている。
RSIが本格的に実現した場合、その社会的インパクトは単なる「生産性向上」に留まらない。80億人規模の知的労働が自動化されるとすれば、労働市場・教育・科学研究・国際的な競争構造が根本から問い直されることになる。同時に、能力とアライメントの評価問題が示すように、「賢いAI」が必ずしも「安全なAI」ではないという非対称性が、ガバナンス設計の最難関として残り続ける。
AI開発の最前線に関わる研究者・エンジニアだけでなく、政策立案者やビジネスリーダーにとっても、RSIのダイナミクスを概念レベルで理解しておくことは今後不可欠になるだろう。本講義ノートはその入門として、実データと複数シナリオを組み合わせた議論の質の高さで、一読の価値がある。
詳細はCS 2881 Fall 26: Lecture 4: Recursive Self-Improvement and AI Trajectoriesを参照していただきたい。