11月11日、Software Testing Magazineが「How AI Is Changing the Role of QA Engineers」と題した記事を公開した。AIの台頭によってQAエンジニアの仕事が「テストを実行する役割」から「テスト結果を判断する役割」へとシフトしている現状について、具体的なツールや調査データを交えながら詳しく論じている。
「テストを実行する」から「判断を下す」へ
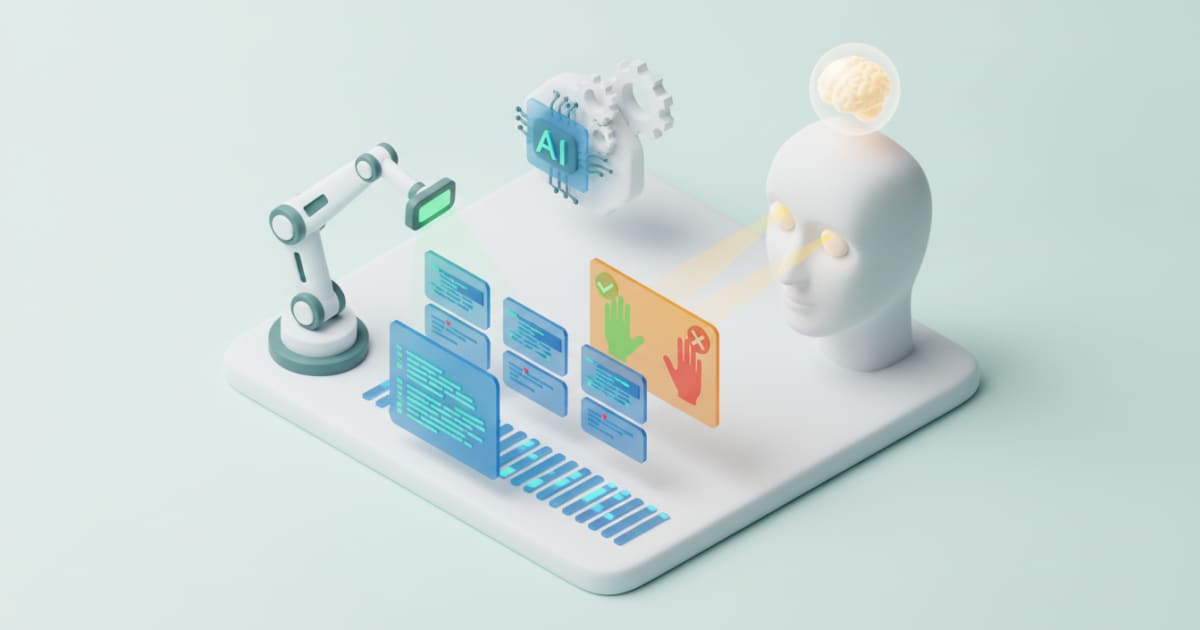
記事の著者(LITSLINKというソフトウェア開発会社でQA実務に携わる立場)が提起するのは、AIがテストの実行・分類・修復を担うようになった結果、QAエンジニアの仕事が「機械が出した結果が正しいかどうかを判断すること」に変わりつつあるという指摘だ。
たとえば、従来であれば金曜日の大半を費やしていたリグレッションサイクルが、今では「失敗の分類済み・ロケーター修正済み・ノイズ除去済み」の状態で届くようになった。だが問題は、その自動分類が正しいかどうかを誰かが確認しなければならない点だ。「これはほんとうにオートメーションのバグか?」「修復されたセレクターは正しいボタンを指しているか?」——こうした問いがQAエンジニアの主戦場になった、というのが著者の主張の核心だ。
自動化ツールが吸収した仕事、残った仕事
記事では代表的なツールが具体的に紹介されている。それぞれのツールが何を自動化し、何を人間に委ねているかを把握することが、この記事の論旨を理解するうえで重要だ。
- **Playwright Test Agents**:アプリを自動探索してテストプランを生成し、失敗したテストを修復する。healerがバグと判断した場合、テストを"fix"ではなく"skip"することもある。
- **Healenium**:SeleniumのドライバーをラップしてNoSuchElement例外を検知し、機械学習で最も近い要素を自動選択してロケーターを修復する。
- ReportPortalのAuto-Analysis:過去の分類済みログとXGBoostモデルを使い、未調査の失敗を自動分類する。元記事によれば、一定の確信度を持った時点で確定ラベルを付与する設計であり、著者は「確信を持ったコイン投げ」と表現している。
- **Applitools Eyes**:ピクセル比較ではなく知覚的マッチングで視覚的リグレッションを検出する。
いずれも「作業の自動化」は達成しているが、「その判断が正しいか」という検証は人間に残る。各ツールの出力を鵜呑みにせず、サンプリングや承認フローを設けることが著者の推奨だ。これを整理したのが以下の表だ(記事原文より):
| QAタスク | AIがやること | QAエンジニアが持つべきもの |
|---|---|---|
| リグレッションテスト作成 | テストプラン・ファイルの草案生成 | アサーションのレビュー、カバレッジの判断 |
| ロケーター保守 | 壊れたセレクターの自動修復 | 修復の承認、誤った要素への適用検知 |
| 失敗のトリアージ | 過去ログとの照合で自動分類 | 分類結果のサンプリング、ラベルの修正 |
| ビジュアルリグレッション | 知覚的マッチングで比較 | マッチレベルの設定、差分の意図判断 |
| AIフィーチャーのテスト | 自動メトリクスでスコアリング | 評価セットの構築、閾値設定、バイアス検出 |
LLMが壊す「アサーションの前提」
記事で最も技術的に重い論点が、AIフィーチャー(LLMを使った機能)のテストだ。
従来の決定論的なコードは「同じ入力→同じ出力」が保証されていた。LLMはそれを崩す。Thinking Machinesの研究(2025年9月)では、Qwen3-235Bに同じプロンプトを温度0で1000回入力したところ、80通りの異なる回答が返ってきた。原因は乱数ではなく、サーバー負荷によるバッチサイズの変動と、バッチ非不変な推論カーネルだとされる。「Temperature 0は決定論のスイッチではない」という指摘は、LLMを組み込んだシステムをテストするすべてのQAエンジニアが意識すべき事実だ。
さらに深刻なのがドリフトの問題だ。2023年のarXivの研究では、GPT-4が素数判定の正解率を3月の84%から6月に51%へ落としていたことが確認されている。リポジトリに何もコミットしていなくても、依存先のホスト型モデルが変われば挙動が変わる——このことは、テストをコミット時だけでなくスケジュール実行する必要性を示している。
LITSLINKのML Engineer、Yevhenii Melikovは社内での評価計画についてこう述べている:
「通常のコードならアサーションを書けば成立するかしないか決まる。LLMフィーチャーは評価セット・スコアリングルール・事前合意した閾値が必要だ。同じプロンプトでも明日は違う表現で返ってくるかもしれない。QAに求めるのは、そのセットのオーナーシップ——どのケースを入れるか、誰がラベルを付けるか、スコアがどれだけ落ちたらリリースを止めるか——の決定だ。」
彼が「プロンプトを書いてくれ」「モデルをチューニングしてくれ」とは言っていない点が重要だ。QAに求めたのは「正しさの定義を持つこと」——それはQAが昔から担ってきた役割そのものだ、と著者は強調する。
「AIがテスターを置き換える」論の誤り
Stack Overflow 2025年開発者調査では、84%がAIツールを使用または使用予定と回答した一方、46%がAIの出力精度を信頼していないと答え、66%が「ほぼ正しいが完全ではないAIの回答」を最大の不満として挙げた。また45.2%がAI生成コードのデバッグに余計な時間がかかると回答している。
「ほぼ正しい」ものを検出することこそがテストの存在意義だ。コード生成が速くなれば、それだけ「もっともらしいが少し間違っている」成果物が増える。テスト生成が速くなれば、期待値を誰かが確認しなければならないテストが増える。どちらも「判断する人間」への需要を増やす方向に働く。
World Quality Report 2025(OpenText・Capgemini・Sogeti、22カ国2000人超の調査)によると:
- **89%**がGenAI拡張ワークフローを試験・展開中(本番稼働37%、パイロット52%)
- 企業全体への実装に達したのは15%のみ、43%は実験段階
- 平均生産性向上は**19%**だが、3分の1の組織では効果がほぼゼロ
- 信頼性・幻覚への懸念を課題に挙げたのは60%
- AI/MLの専門知識不足を訴えた組織は50%で前年から変化なし
著者の見立てでは、19%の生産性向上は「判定を人間が持っているチーム」で実現しており、「ツールに判定を任せているチーム」では停滞している。数字の差は技術選定よりも、判断の所在をどこに置くかで生まれているというのが記事の核心的な主張だ。
QAリードが今後2四半期でやるべきこと
記事はQAリード向けのチェックリストを提示して締めくくっている。自動化の恩恵を受けながら判断の質を落とさないための具体的な行動指針として読める。
- AIが加えたテストへの変更(修復済みロケーター、生成テスト等)はすべてレビューを通す。セルフヒーリングスイートにレビューなしのデプロイは禁止。
- トリアージ分類器の精度を週次サンプリングで追跡する。
- AIフィーチャーはQAがオーナーになった評価セットなしでリリースしない。
- モデル出力への完全一致アサーションを廃止し、スキーマチェック・根拠チェック・ルーブリックに替える。
- 評価をコミット時だけでなくスケジュール実行する。ホスト型モデルはリポジトリと無関係に変わる。
- トリアージで浮いた時間を探索的テストとrisk-based testingに使う。
- チームにモデルの挙動を読む力をつける——スコア分布の解釈、スライス単位の失敗検出、MLエンジニアとの閾値議論。
これらはいずれも「ツールを使いこなす」ためではなく、「ツールの判断を検証する」ための施策だ。自動化が進むほど、こうした判断の枠組みを意識的に設計するQAの価値は高まると著者は主張している。
詳細はHow AI Is Changing the Role of QA Engineersを参照していただきたい。