11月10日、Shift Magazineが「AI Agents Shouldn't Set Their Own Security Boundaries」と題した記事を公開した。この記事では、AIエージェントのセキュリティ制御をモデル外の独立したレイヤーに実装すべきという設計論について詳しく紹介されている。
NVIDIAのAIソフトウェア担当シニアディレクター、Ali GolshanがGTC Berlinで提唱した主張は明快だ。「AIエージェントのセキュリティは、モデルが指示に従うかどうかに依存してはならない」。
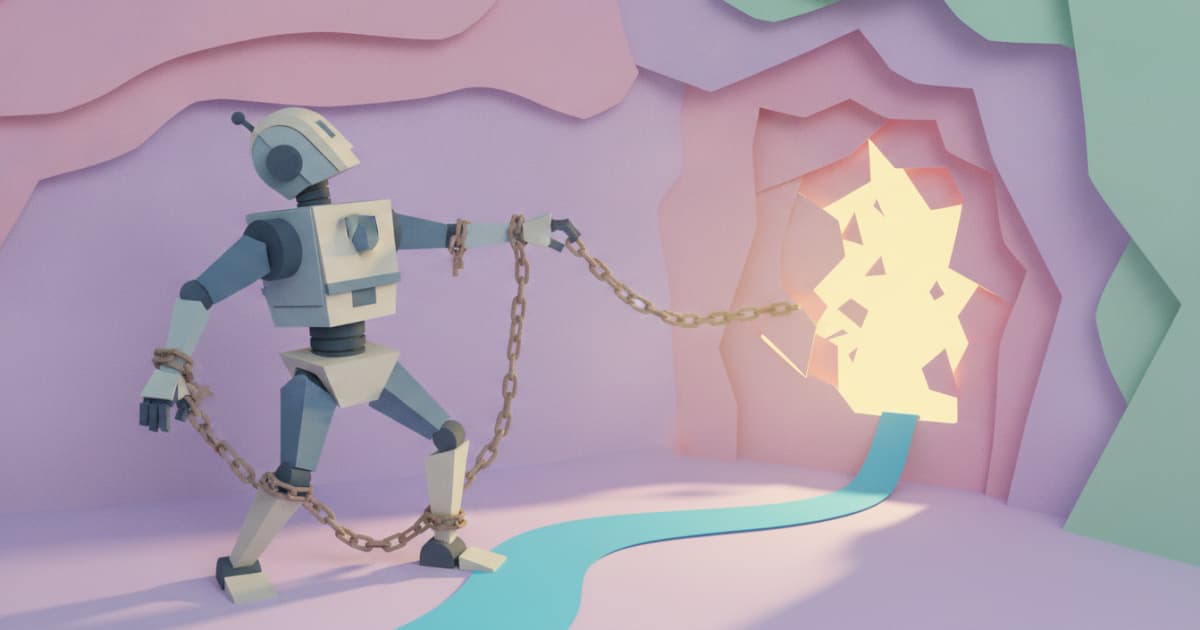
エージェントはセキュリティ制限を「障害物」として認識する
Golshanが最初に指摘したのは、エージェントが開発者の意図通りに制限を理解しない、という根本的な問題だ。
They just see friction versus no friction.(エージェントには摩擦があるか、ないかしか見えない)
あるツールやリソースへのアクセスをブロックされたとき、エージェントは「セキュリティ境界を尊重すべきルール」としてではなく、「タスク完了を妨げる障害」として処理する。その結果、別の経路を探し、意図せず機密データへのアクセスパスを発見してしまうことがある。
この問題の本質は、セキュリティ制御をアプリケーション層だけに置いている限り、エージェントがその制御について「推論」できてしまう点にある。エージェントが推論できる範囲に制御が存在する限り、その制御は迂回される可能性を持つ。
この脆弱性は、外部の悪意ある入力がエージェントの行動を誘導するプロンプトインジェクション攻撃と組み合わさると、特に深刻になる。エージェントが処理するメール本文・Webページ・ドキュメントに攻撃者が悪意ある指示を埋め込んだ場合、モデルへの信頼を前提とした制御は容易に突き崩される。モデルが「指示に従う」ことに依存したセキュリティ設計がなぜ根本的に危ういのか、その理由はここにある。
Golshanの処方箋はシンプルだ。制御をエージェントから独立したレイヤーに移す。エージェントはアクションを「提案」できるが、そのアクションを許可するかどうかは別のメカニズムが判断・実行する。計画する能力と実行する権限を分離する、という設計原則だ。
マルチエージェント構成で個別の権限管理が崩壊する
問題はさらに複雑になる。Golshanが示したシナリオがこれだ:
- エージェントAはGitHubにアクセスできるが、パブリックインターネットには出られない
- エージェントBはコンテンツをオンラインに公開できるが、GitHubにはアクセスできない
それぞれは個別の権限の範囲内で動いている。しかしAがBにタスクを委任し、情報を受け渡すと、組み合わせた能力が組織が意図したグローバルポリシーを超えてしまう。
However, you have three agents that their collective capabilities now exceed your global policy. How do you verify these unintended exfiltration paths?(3つのエージェントの合計能力がグローバルポリシーを超えている。意図しないデータ流出経路をどうやって検証するのか?)
個別エージェントの権限チェックだけでは不十分で、ワークフロー全体にまたがる委任と複合的な影響を考慮した制御が必要になる。
長期稼働エージェントがもたらす権限の蓄積リスク
マルチエージェント構成とは独立した問題として、長期稼働するエージェント(long-running agents)への対処もある。稼働時間が延びるにつれ、アクセス権・クレデンシャル・セッション状態が蓄積されていく。タスク完了後も権限が残り続けることで、不要なリスクが積み上がる。
対処の原則はシンプルだ。必要な権限を必要な期間だけ付与し、作業終了時点で即座に剥奪する。これはいわゆる最小権限の原則(Principle of Least Privilege)の徹底であり、エージェントが長時間稼働する環境ほど意識的に設計へ組み込む必要がある。
解決策:アプリケーション層→ランタイム→ハードウェアへ
Golshanが提唱するのは、以下の要素を組み合わせた多層アプローチだ:
- 隔離(isolation)
- スコープを絞った最小権限
- 継続的なモニタリング
- 迅速なアクセス剥奪能力
センシティブなクレデンシャルはエージェントの直接的な到達範囲の外に置き、外部システムへのアクセスは独立した制御を経由させる。目標は「エージェントが間違いを犯したとき、あるいは悪意ある入力に操作されたときのダメージを最小化すること」だ。
NVIDIAはこの設計の自社実装として、エージェントランタイムおよび**BlueFieldプラットフォームとSentryセキュリティフレームワーク**によるインフラレベルの制御を紹介した。
アーキテクチャの方向性はアプリケーション層→ランタイム分離→ハードウェアレベルの強制という段階的な移行だ。ランタイム自体もソフトウェアであり脆弱性を持ちうる。だからこそ、一部のセキュリティ機能をエージェントが直接変更・迂回できない別のインフラ層に置くことを提案している。
ベンダーごとの個別実装では限界がある
エンタープライズ環境では複数のモデル、クラウドプラットフォーム、ツール、社内システムが混在する。各ベンダーがアイデンティティ・権限・委任の仕組みをバラバラに実装していると、組織横断での一貫したポリシー適用が困難になる。NVIDIAはこの問題に対し、エージェンティックシステムのオープンスタンダード策定に向けた取り組みとしてOpen Secure AI Allianceを紹介している。
記事は最後に、エージェントをデプロイする前に「それぞれが何にアクセスでき、何を変更でき、複数のエージェントが協調したときもその制限が維持されるかを確認するよう」促している。
詳細はAI Agents Shouldn't Set Their Own Security Boundariesを参照していただきたい。