


11月13日、Craig Risiが「Netflix Turns Operational Data Into a Knowledge Graph for AI-Driven Observability」と題した記事を公開した。この記事では、NetflixがオントロジーベースのKnowledge Graphを構築し、AIエージェントによる障害原因分析(RCA)を自動化しようとしている取り組みについて詳しく紹介されている。
障害調査に平均4時間かかる問題
Netflixは1日あたり20億件以上のリクエストを処理し、リアルタイムのログイベントを毎秒3,800万件以上収集している。2024年11月のジェイク・ポール対マイク・タイソン戦では、約6,500万の同時ストリームを支えたインフラ規模を誇る。
にもかかわらず、アプリケーションのリグレッション(性能低下や障害)が発生した際、調査に平均約4時間を要していた。その大半は、根本的な原因を分析する時間ではなく、複数のシステムに分散した情報を人手でつなぎ合わせる作業に費やされていた。
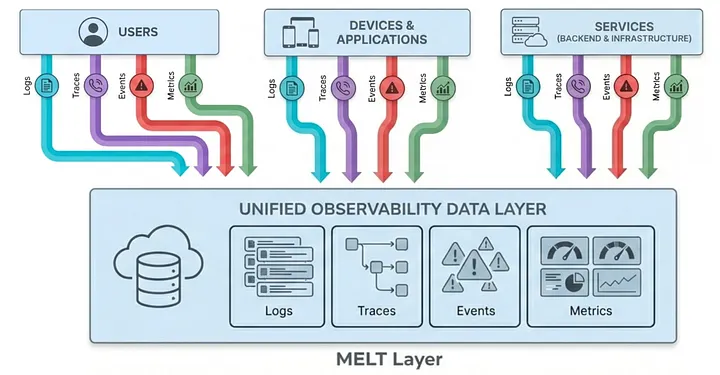
Netflixはすでにメトリクス、イベント、ログ、トレースをまとめたいわゆるMELT(Metrics, Events, Logs, Traces)を収集している。しかし、これらのシグナルはアラートシステム、インシデント管理ツール、デプロイツール、エンジニアリングコミュニケーション基盤など、各システムに分散したまま存在していた。
オントロジーとKnowledge Graphによる解決策
Netflixが選んだアプローチは、各コンポーネントの「関係性」を明示的に定義することだ。
その中核となるのが可観測性オントロジー(Observability Ontology)である。オントロジーとは、エンティティの種類・属性・関係を形式的に定義した概念モデルを指す。NetflixはここにRDF、OWL、SHACL、SPARQLといった標準仕様を採用した。生成されたKnowledge Graphの保存先はQuipuDB、Rustのredbストレージエンジン上に構築したNetflix独自の分散RDFトリプルストアだ。
グラフへのデータ投入は「エンリッチャー(enricher)」と呼ばれるコンポーネント群のパイプラインで行われる。各エンリッチャーは運用システムからの情報を、主語・述語・目的語のトリプル(RDFの基本単位)として構造化された関係性に変換する。
処理は決定論的なものもあれば、LLMや確率的技術を使って非構造化情報を解釈するステージも含まれる。これらの出力はエンティティ型の一貫性、URI命名規則、ソフトウェアカタログとの照合といった厳格な検証ルールで制約される。
さらに特徴的なのは、インシデント対応中の議論内容もグラフに取り込む点だ。仮説、棄却された説明、緩和措置の決定など、人間の推論プロセスが一時的なチャットで消えることなく、運用ナレッジとして蓄積される。
複数シグナルを横断する相関エンジン
Netflixの相関エンジンは以下の9種類のシグナルを検査する。
- ログエラー
- メトリクス異常
- トレース
- アラート
- インシデント
- デプロイ
- 設定変更
- 実験(A/Bテスト等)
- コード変更
これらから潜在的な因果関係を探索し、時間的近接性や深刻度といった証拠を評価して、根本原因の仮説をランク付きで提示する。
「Knowledge Flywheel」とAIエージェントへの接続
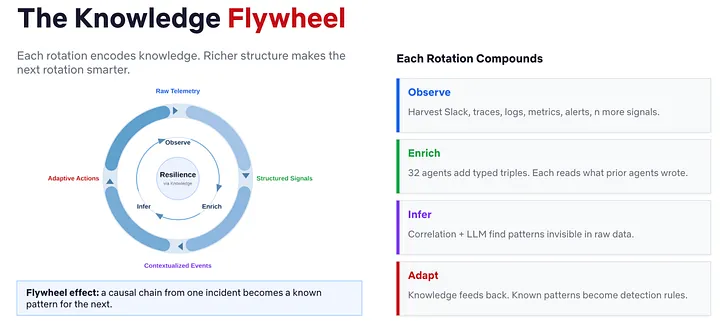
Netflixはこのプロセスを「Knowledge Flywheel」と表現している。Observe(観測)→ Enrich(エンリッチ)→ Infer(推論)→ Adapt(適応)のサイクルを繰り返す構造で、各ステップの出力が次のステップの入力を改善し続ける自己強化サイクルになっている点が「フライホイール」と称される所以だ。障害調査で得た知見がそのまま次の検知・分析の精度向上に還元されるため、稼働を重ねるほどシステム全体が賢くなる設計といえる。
このKnowledge Graphは、Netflixの社内AIエージェントシステムAutoRCAの基盤にもなっている。トレース、ログ、デプロイをそれぞれ担当する専門エージェントは、オントロジーを共通インターフェースとして使うことで、互いの内部実装を知らなくても同一の運用エンティティに対して知見を書き込める。
現時点では、提案された変更や修復措置に対して人間が承認権限を持つ設計になっている。Netflixが最終的に目指すのは、根本原因分析の自動化から自動修復・自己修復インフラへの拡張だ。同社はNetflix Unified Data Architectureとの統合も計画しており、運用情報をより広いビジネス・技術ドメインに接続することも検討中だという。
商用製品との差異
Datadog、Dynatrace、Splunkはすでに観測可能性シグナルの相関分析にAIを組み込んでいる。Netflixのアプローチが異なるのは、それらシグナルの背後にあるセマンティックモデル(意味的な関係性の定義)を永続的に管理し、エンジニアとAI双方から直接アクセス可能にしている点だ。
詳細はNetflix Turns Operational Data Into a Knowledge Graph for AI-Driven Observabilityを参照していただきたい。


