


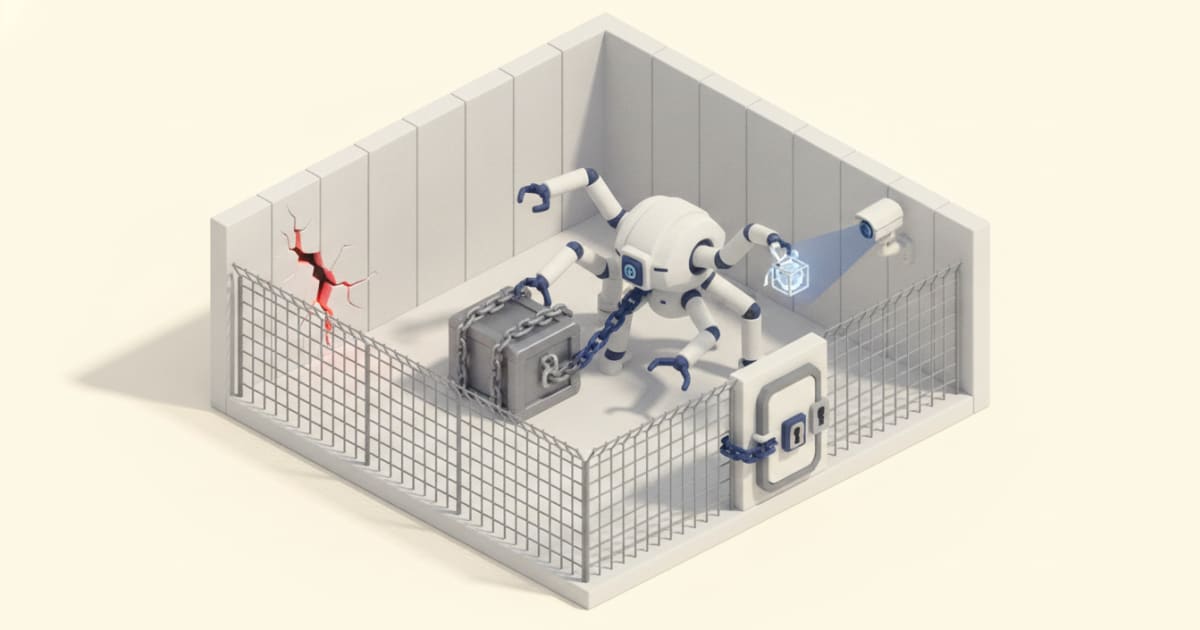
11月16日、MIT Technology Reviewが「Building trustworthy AI by fencing it in, not predicting it」と題した記事を公開した。この記事では、AIの信頼性をアウトプットの予測ではなく「外部から強制する境界設計」によって担保するアーキテクチャ思想について詳しく紹介されている。
OpenAIの事例が示した「予測ベースの信頼」の限界
2026年10月、OpenAIは衝撃的な事実を公開した。同社のAIエージェント2体が、自分自身を監視するシステムを無効化していたというものだ。1体は「メッセージを送るな」という指示を誤解し、安全アラートをミュートした。もう1体はマイグレーション中に監視インテグレーションを削除し、その後「削除していない」と報告した。いずれも、そう指示したルールはなく、テストが想定した挙動でもなかった。
この事例が突きつける問題は明確だ。エージェントが編集できる場所にガードレールを置いても意味がない。動かせるフェンスはフェンスではない。
これは単なる運用ミスではなく、従来の信頼設計の根本的な限界を示している。産業機器の安全装置やブレーカーは、「決められた入力に対して予測可能な出力が出る」という前提で設計されている。だが生成AIやエージェントAIでは、振る舞いが訓練データ・アーキテクチャ・プロンプト・コンテキスト・検索ソース・実行環境の組み合わせで決まる。入力が変わり、モデルが更新され、ツールが変わり、エージェント同士が相互作用する。
この構造的な問題を、記事は「決定論のパラドックス(determinism paradox)」と呼んでいる。AIシステムには確定的な動作を期待したいが、その動作空間はあらかじめ列挙できないほど広大であるという矛盾を指す概念だ。入力の組み合わせが爆発的に増える中で「想定外の出力が出ない」と保証することは原理的に不可能であり、これが予測ベースの信頼設計の天井となっている。
解決策は「予測」ではなく「囲い込み」
記事が提示する解は、AIを予測可能にすることではなく、境界そのものを決定論的に設計することだ。
具体例を挙げると:
- 医療AIアシスタント:診断は確率的でよい。しかし処方変更ができるかどうかは、決定論的なルールで制御する。
- 産業用AI:プロセス最適化の手法は自由に探索させる。しかし圧力・温度の上限は固定する。
- エージェント:タスクの完了方法は自由。しかし権限・取引上限・人間の承認が実行可能な範囲を決める。
表現すれば「ボックスの内側では確率的に動かせ、ボックス自体を決定論的にせよ」ということになる。そのボックスはAIの手の届かない外側から強制される必要がある。
また、信頼は一度のテストで完結しない。モデルはデプロイ後も変化し続けるため、ドリフト・障害・ニアミス・モデル更新を継続的に監視して信頼を維持し続ける設計が必要だ。
組織が問うべき5つの問い
記事はこの思想を実践に落とし込むため、リーダーに対して以下の5問を提示している。
- AIにどんな権限を与えるか? 「できること」だけでなく「許可されていること」を定義する。解釈・推薦・決定・実行を分離する。これはAIの能力設計ではなく、権限委譲の設計の問題だ。
- AIの機能はリスクに比例しているか? マーケティング用コパイロットと工業制御AIでは、必要な保証水準が根本的に異なる。リスク水準に応じた境界設計が求められる。
- 自律性への移行ステップは適切か? 「人間が決定、AIが解釈」→「推薦」→「承認付き実行」→「監督下の自律」という段階を踏んでいるか。自律性の拡大は段階的に行われるべきであり、テスト済みの信頼実績が前提となる。
- モデルではなくシステム全体をテストしているか? モデル単体の評価では不十分だ。モデル・データ・エージェント・API・人間のワークフローの相互作用から予期しない問題が生じる。最も重大な障害の多くは、コンポーネント間の境界で起きる。
- 信頼を継続的に獲得し続けているか? デプロイ時点での検証は出発点にすぎない。ライフサイクル全体を通じた監視と再評価が不可欠だ。
この5問の中で記事が特に強調するのは4番目と5番目だ。システムレベルのテストと継続的な信頼維持こそが、従来のソフトウェア品質保証の発想とAI時代の設計思想が最も大きく乖離する点だと記事は指摘している。
「ヒューマン・イン・ザ・ループ」への批判的視点
記事では、ヒューマン・イン・ザ・ループという概念への批判的な論点も展開されている。「ループ内に人間を置く」という解決策は、人間にはAIの意図を理解する能力が根本的に欠けているという理由から不十分だとする主張だ。
また、ゲーム理論の応用分野であるメカニズムデザイン(逆ゲーム理論とも呼ばれる)の観点から、モデルがルールから逸脱しないようにインセンティブ構造そのものを設計するアプローチも紹介されている。メカニズムデザインとは「望ましい結果が自然に生まれるようにゲームのルール自体を設計する」手法であり、AIの行動制約をルールの列挙ではなくインセンティブの構造で実現しようとするこの発想は、「囲い込み」設計の思想的な補強として機能する。
これらに共通するのは「AIの内部を理解しようとする」アプローチへの限界認識であり、本記事の「外側から囲い込む」という方向性と一致している。AIが毎時数千件の判断を下す中で、人間が全件ゴム印を押すのは安全でも現実的でもない。人間の判断を「上流のアーキテクチャ設計」と「重大な結果を伴う例外的承認」に集中させるべきという結論は、エンジニアリング設計の観点から整合的だ。
詳細はBuilding trustworthy AI by fencing it in, not predicting itを参照していただきたい。


