11月19日、OpenAIが「How OpenAI's Performance Factory keeps ChatGPT fast」と題した記事を公開した。ChatGPTのパフォーマンス低下をAIが自動で検出・調査・修正する社内システム「Performance Factory」の設計と運用を詳細に解説したもので、稼働からわずか3ヶ月強で1,700件以上の調査を追跡し、600件超の根本原因を特定したという。
AIサービスの継続的デリバリーが一般化するなか、パフォーマンス劣化(リグレッション)の検出・調査・修正を人手で追い続けることには限界がある。Performance Factoryはその課題に正面から向き合ったシステムで、1日あたり17件の自動調査が走っている計算になる。エンジニアが介入すべき判断を絞り込みつつ、調査の大半をエージェントに委ねる設計は、同様の課題を抱えるサービスチームへの実践的な参考資料として読める。
手作業から「工場」へ——6段階の進化
記事が丁寧に説明しているのが、チームがどうやって自動化へ至ったかのプロセスだ。
- 手動調査:エンジニアがメトリクス・ログ・トレースを手動で読み解く。30以上のパフォーマンスツールを蓄積してきた。
- Codexをパートナーとして使う:「なぜ遅くなったか?」をCodexと協力して調査。ただしエンジニアが方向を都度指示する必要があった。
- スキルの再利用:調査プロセスを
perf-forensicsという共有スキルに落とし込む。ツールの使い方・調査手順をCodexに伝えるプレイブックとして機能する。 - 人間がプロキシになる:アラートが来るたびにエンジニアがコピペしてCodexに流し、結果をSlackに貼り返す作業が発生。
- 自動調査:アラートをトリガーにクラウド上でCodexセッションを起動し、結果をSlackに投稿。ただし修正・検証はまだ手動。
- 工場化:調査→修正提案→レビュー→回復確認までをワークフローとして定義し、タスクとして管理・自動実行。
ここで登場する「Codex」は、OpenAIが提供するコーディングエージェントだ。コード生成・実行・調査を自律的に行う能力を持ち、Performance Factoryの中核エンジンとして機能している(OpenAI Codex 公式ページ)。
システムの4つのコンポーネント
Performance Factoryは以下の4つで構成される。
- タスクサービス:ワークフローをMarkdownの設定ファイルとプロンプトで定義。タスクが通過できる状態(ステート)と遷移ルールを管理する。
- ディスパッチループ:準備完了のタスクを定期的にチェックし、エージェントにアサインする。
- クラウド上のCodex実行環境:社内ネットワーク内で動作し、コードリポジトリ・メトリクス・ログ・トレース・CPUプロファイル・メモリスナップショットにアクセスできる。エージェントはサービスアイデンティティ(サービス単位で付与された認証情報)で動くため、権限スコープの管理と操作の追跡が可能だ。
- サブスクリプション(イベント待機):GitHubのレビューコメントやCI失敗など、外部イベントを待機してエージェントを再起動する仕組み。エンジニアのレビュー待ち中にエージェントが無駄に動き続けることを防ぐ。
最も参考になる仕組み——「対立的レビュー」が精度を上げる
エンジニアリング的に最も示唆深いのが、Adversarial Review(対立的レビュー)の仕組みだ。
初期実装では、エージェントが最初に見つけた「もっともらしい説明」で調査を止めてしまい、誤診が発生した。これに対応するため、根本原因の仮説を別のCodexセッションが反証しようとするレビューを追加した。「当該変更がロールアウトされていないリクエストは正常だったか?」「変更ロールバック後、メトリクスは回復したか?」といった反実仮想を検証する。
実際のケースとして、あるエージェントが「画像ダウンロードのエラーが原因」と特定してクローズしようとしたところ、レビュアー役のCodexが「ファイル位置を管理するサービスはすでに回復しているのに画像リクエストはまだ失敗している。診断が継続中の障害を説明できていない」と指摘し、調査を差し戻した事例が紹介されている。
手動での100件のレビューでは、根本原因提案の70%が正確だった。残り30%はさらなる精査が必要という結果で、完全自律には至っていないが、熟練エンジニアが一から調査する工数を大幅に削減できる水準とOpenAIは評価している。
修正の自動化は「根本原因の特定より難しい」
記事はフィックスの自動化が最も難しい部分だとはっきり述べている。エージェントが提案する修正が必要以上に複雑だったり、新たな問題を引き込むケースがあるためだ。
修正ステップにも同様の対立的レビューを追加したほか、エンジニアへの引き継ぎを円滑にするため、タスクレポートにはメトリクスの時系列グラフ、CPUフレームグラフ、トレースが自動生成される。
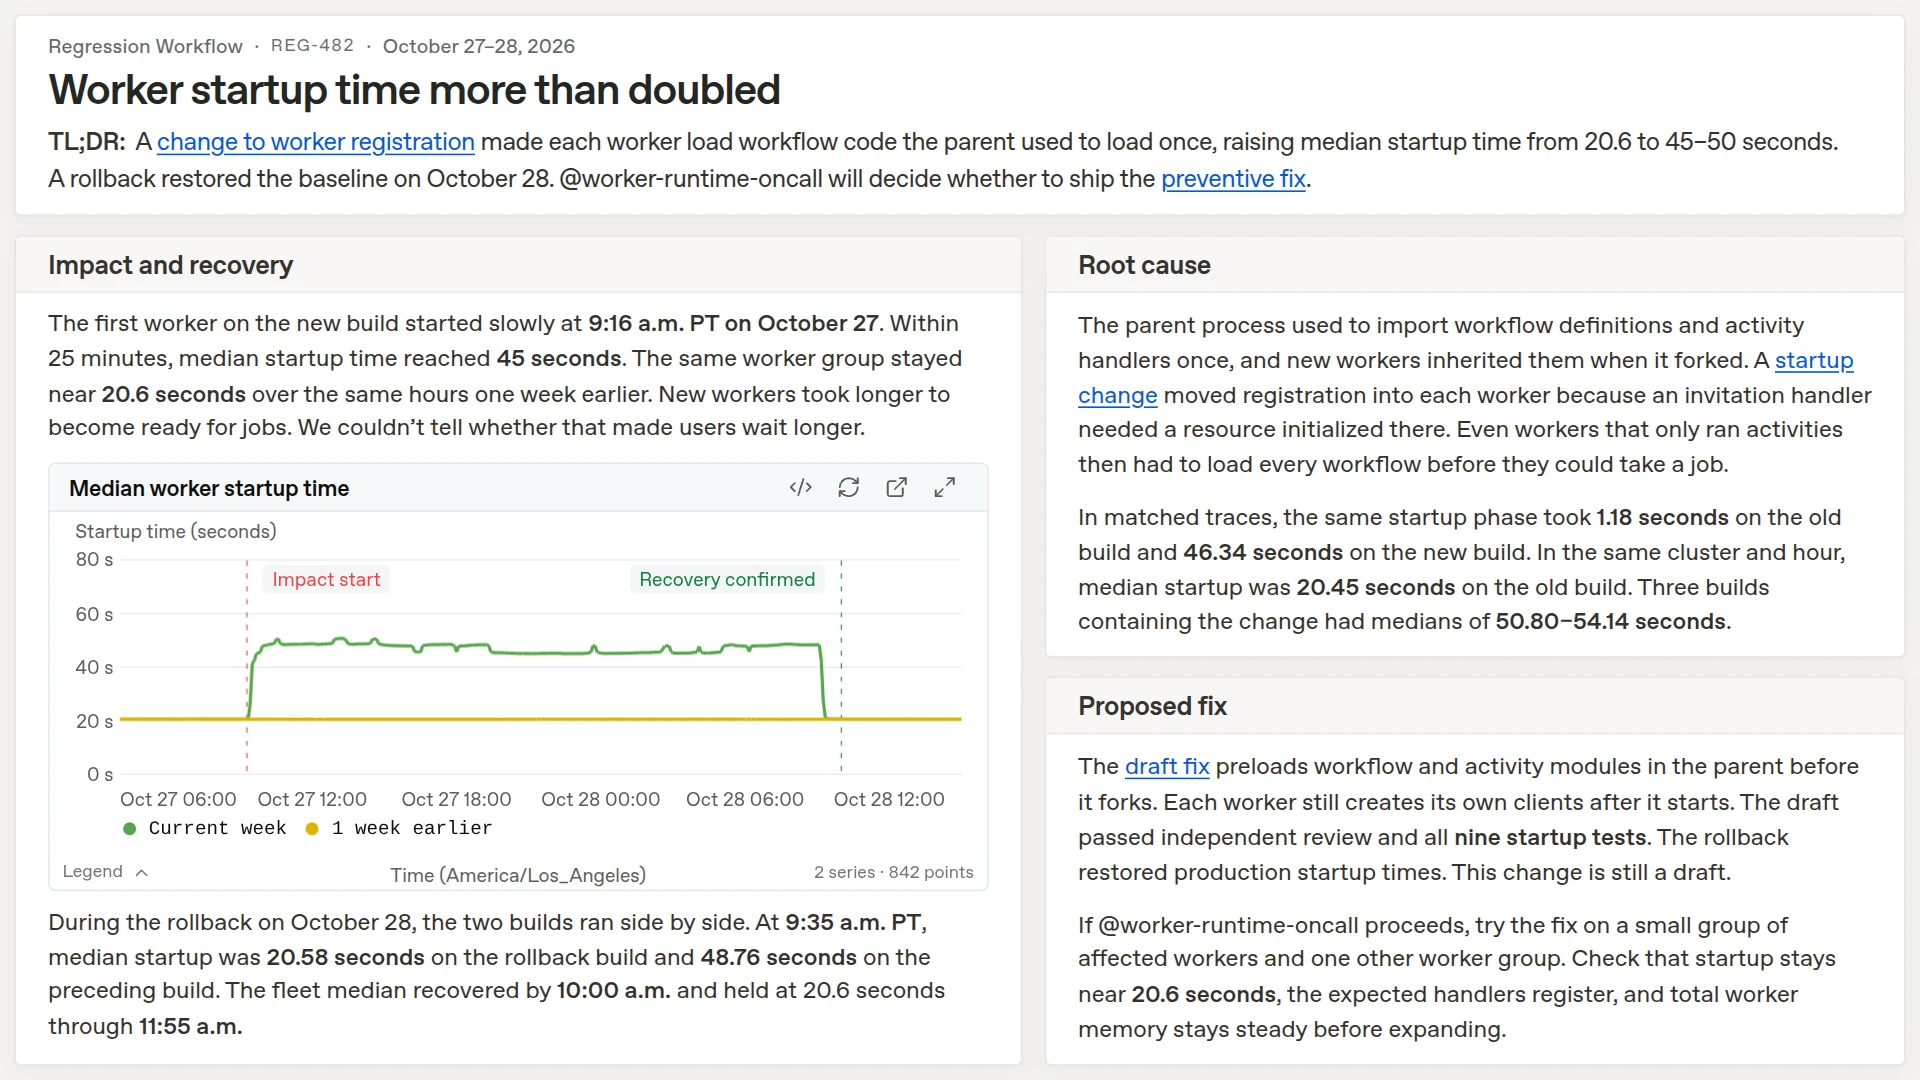
ワーカー起動時間が2倍以上に跳ね上がったリグレッションの実際のタスクレポート
キャッシュ導入のようにパフォーマンス改善とトレードオフ(データの鮮度など)が絡む判断は、引き続きサービスを知るエンジニアが担う設計になっている。今後は合成パフォーマンステストをエージェントに使わせ、レビュー前に自己検証・修正させる仕組みも構築中とのことだ。
設計思想——エンジニアの「注意」を守る
記事が「学んだこと」として強調するのが、エンジニアの認知負荷を下げる設計だ。Codexの調査結果をそのまま出力するとテキストの塊になり、何を主張しているのか読み解くだけで時間がかかる。エンジニアが費やすべき注意は、エージェントの作業を再構築することではなく、判断に集中することだという考え方がシステム全体に貫かれている。
AIエージェントを「ツールとして使う」段階から「ワークフローの主体として組み込む」段階へ移行する際の具体的な設計判断が詰まった一次資料だ。
詳細はHow OpenAI's Performance Factory keeps ChatGPT fastを参照していただきたい。