


11月19日、Salesforceが「Building Predictive AI Models When Synthetic Data Is All You Have」と題した記事を公開した。最も注目すべき知見は「精度95%でも役に立たないモデルを、シナリオベースの検証でいかに見破るか」という問いへの実践的な答えだ。SLA違反のような低頻度イベントを予測する場合、集計精度だけで検証するとモデルの欠陥を見逃しやすい——このクラス不均衡問題を、Salesforceのエンジニアリングチームは統計指標ではなく「スコアの振る舞いを直接検査する」アプローチで回避した。
「本物のデータがない」ところから始める予測AI
機械学習モデルを構築するうえで最大の壁のひとつが「学習データの不足」だ。Salesforceのシニアマネージャー Taniya Ghosh のチームはこの問題を正面から受け止めた。ミッションはITサービス管理(ITSM)を「事後対応」から「予測的介入」へ転換すること。しかし、SLA違反や重大インシデントを予測するモデルを作りたいのに、学習に使えるリアルな顧客インシデントデータがない——という矛盾した状況でプロジェクトは始まった。
チームが構築したのは、3つの予測モデルテンプレートだ。
- SLA Breach Prediction(SLA違反予測)
- Major Incident Prediction(重大インシデント予測)
- Change Risk Score(変更リスクスコア)
いずれも、サービスマネージャーがデータサイエンティストなしでリスクスコアと主要な予測因子をインシデントレコード上で確認できる設計になっている。
合成データをどう「使えるもの」にするか
顧客データがない状態でモデルを開発するため、チームは合成データを活用した。ただし「とりあえず乱数で生成する」ようなアプローチは取らなかった。
プロセスは以下の流れだ。
- プロダクトマネージャーに現実のITSMシナリオを網羅したサンプルデータを提供してもらう
- そのサンプルをベースに特徴量を変化させてデータを拡張する
- オープンソースのLLMを使って、プロダクトマネージャーの定めたガイドライン内で追加レコードを生成する
このプロセスによって、特徴量の妥当性を評価し、テストシナリオを設計するための合成学習データが得られた。ポイントは、あくまで「顧客が自分のData 360(※後述)のデータでテンプレートを学習させる前の開発段階」で使うものとして位置付けた点だ。
「精度95%でも役に立たない」モデルをどう検出するか
ここがこの記事で最も面白い部分だ。
SLA違反は発生頻度が低い(レアイベント)。そのため、単純に「何もしない」モデルでも精度95%を達成できてしまう。集計精度だけで検証すると、実際には役に立たないモデルを見逃す。これはクラス不均衡問題(解説: imbalanced-learn公式ドキュメント)として機械学習の現場ではよく知られた落とし穴だが、チームはシナリオベースの検証でこれを回避した。
具体的には、1つの要因だけを変化させて予測がどう動くかを確認するという方法を採用した。例として挙げられているのは次のシナリオだ。
インシデントの全特徴量を固定し、担当者だけを変える。一方は過去のマイルストーンの10%を未達成、もう一方は未達成なし。未達成率の高い担当者のインシデントがより高いSLA違反スコアを受けなければならない。
このようにして「スコアが期待通りの方向に動くか」と「上位3つの予測因子が経験豊富なサービスマネージャーが着目するものと一致するか」の2点を確認した。統計的指標は開発の補助として使いつつ、予測の振る舞いを直接検査するアプローチだ。
顧客ごとに学習パラメータを分離する設計
モデルの再利用性とプライバシーの両立も重要な課題だった。ある顧客のモデルが別の顧客に流用されることは許されない。かといって、顧客ごとにゼロからパイプラインを組ませるのでは本末転倒だ。
解決策は「学習の契約(training contract)を配布する」という設計だ。テンプレートはDMO(Data Model Object、Salesforceのデータクラウド基盤であるData 360上でデータを構造化するためのスキーマ定義単位)のAPI名、変換ロジック、モデル構造を持つ。学習済みの重みではなく、構造だけを渡す。重みは各顧客のインシデント履歴から決まる。
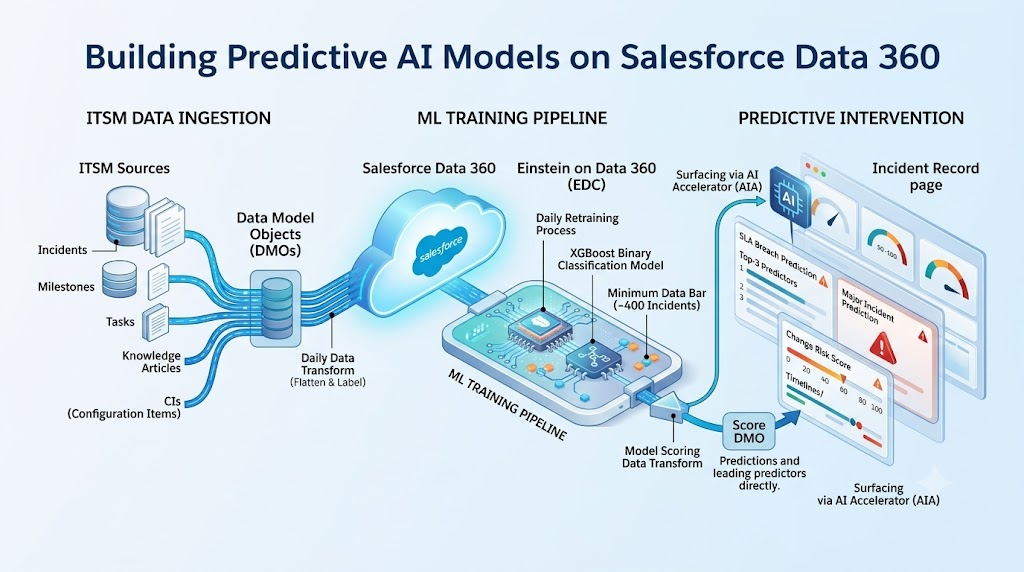
パイプラインの流れはこうだ。
- インシデント、マイルストーン、タスク、ナレッジ記事、構成アイテムがData 360(Salesforceのデータクラウド製品。顧客データを統合・管理するプラットフォーム)のDMOに同期
- 日次のデータ変換でレコードを1つの学習オブジェクトにフラット化・ラベル付け
- Data 360上のEinstein(SalesforceのAI機能群の総称。予測分析や生成AIなど複数の機能を含む)がXGBoost(勾配ブースティングベースの機械学習ライブラリ。表形式データの分類・回帰タスクで広く使われる)の二値分類モデルを学習
- スコアリング変換が予測値と上位3つの予測因子をスコアDMOに書き込む
- AI Acceleratorカード(SalesforceのLightningページ上にAI予測スコアをインラインで表示するためのUIコンポーネント)がインシデントページにスコアをUI表示
顧客はパイプラインを再構築することなく、また他の顧客の学習済みモデルを受け取ることもなく、ワークフローを利用できる。
残課題:バッチ処理と顧客データ品質
現状の制約として、スコアリングは約1時間ごとのバッチ処理で行われる。開発中にはリアルタイム処理も検討されたが、大規模顧客でのスケーラビリティ懸念(ジョブ失敗リスクを含む)からバッチ方式を選択した。
また、モデルの学習には約400件の完了済みインシデントが必要で、顧客のData 360の履歴データの品質が予測品質に直結する。テンプレートは2026年2月に一般提供を開始したが、記事執筆時点では顧客フィードバックを収集中であり、開発段階での検証はあくまでシナリオベースにとどまっている。
詳細はBuilding Predictive AI Models When Synthetic Data Is All You Haveを参照していただきたい。


