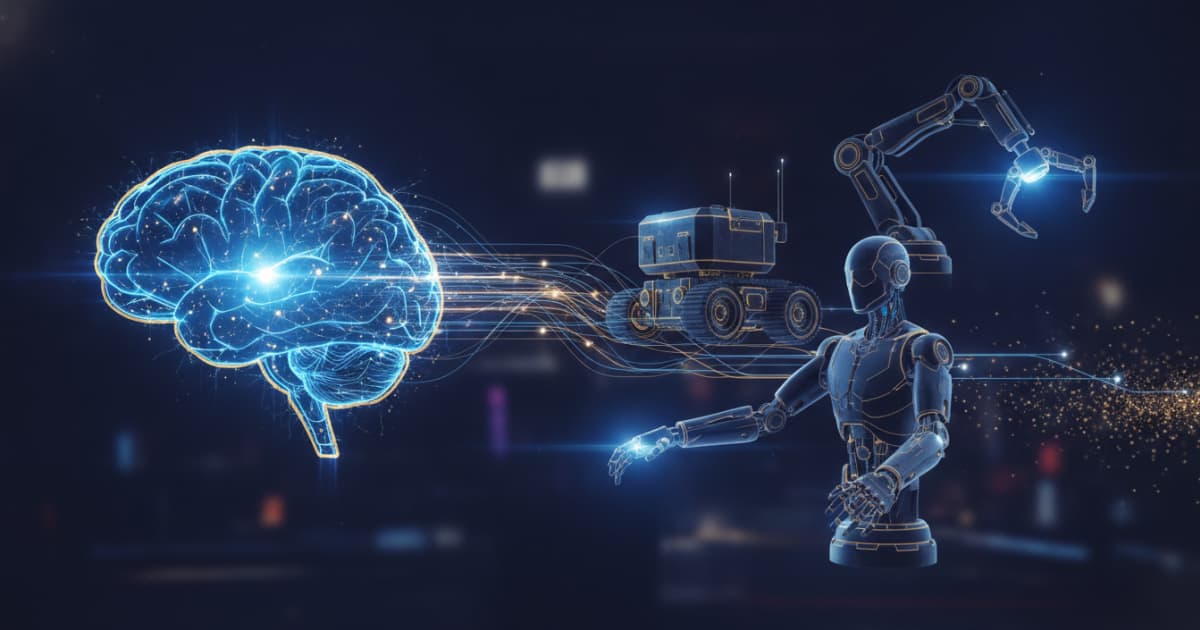
9月15日、Scientific Americanが「Google DeepMind wants to build an AI brain that can jump between robot bodies」と題した記事を公開した。この記事では、Google DeepMindがGeminiを複数の異なるロボット本体に跨って動作させる「フィジカルAI」アーキテクチャの開発について詳しく紹介されている。スマートフォンのOSが機種を問わず動作するように、一つのAIモデルがあらゆるロボット本体を動かす——その構想が現実味を帯びつつある。
「一つの頭脳、多くの体」を目指すGemini Robotics 2
2025年7月末、Google DeepMindはGemini Robotics 2を発表した。前世代が人型ロボットの上半身制御に留まっていたのに対し、新バージョンは脚・胴体・腕・指を含む全身制御に対応している。対象ハードウェアは2アームの研究用プラットフォームから、Apptronikが製造する人型ロボットApollo 2まで多岐にわたる。スナック菓子の取得、電球の交換、ロープの結索といったタスクをこなすデモが公開されている。
このプロジェクトの核心にあるのは、LLM(大規模言語モデル)が実現した「転移学習」の考え方をロボティクスに持ち込むことだ。あるタスクで学んだことが別のタスクや、別のロボット本体でも機能する——そういう汎用的な知能を構築しようとしている。
ソフトウェアスタックの構造
ポップコーンを取りに行くという単純な指示の裏側では、2層構造のソフトウェアが動いている。
- 上位モデル(Gemini Robotics ER 2): 自然言語の指示を複数のステップに分解する高レベルの推論を担う
- 下位モデル: カメラ映像と指示を統合し、毎秒4〜5回の頻度で次の動作を予測・更新する
さらにER 2はタスクの進捗を監視し、完了度を5段階に分類する。DeepMindが公表した進捗分類テストの精度は**57.4%。これはDeepMindが比較対象として示した既存モデルの数字を上回るものだが、実用水準とは言えない数字だ。ゴミ箱への掃き集め(dustpan)タスクにいたっては、Apollo 2の成功率は32%**にとどまった。
なぜ「巧みな操作」がこれほど難しいか
バク転や武道の動きをこなすロボットはすでに存在する。それらは「自分の体を深く理解する」ことで動いている。一方、スクランブルエッグを作ったり洗濯物を畳んだりするには「世界を理解する」必要がある、とDeepMindのプリンシパルソフトウェアエンジニアであるKanishka Raoは語る。
現在のGemini搭載ロボットは視覚入力に依存する、いわゆるVision-Language-Action(VLA)モデルだ。ロボットハンドは22自由度(独立した動作軸が22個)を持ちながらも、触覚フィードバックはほぼゼロに等しい。ブドウを掴む際に潰れかけていることを感知できないし、ワイングラスをどの程度の力で持てばよいかも「感じる」ことができない。
コロンビア大学のロボット工学者Matei Ciocarlie氏(ロボットハンド企業Tangent Roboticsの共同創業者でもある)はこの問題を明確に指摘している。
「インターネットには膨大な視覚データがあるが、触覚データや力覚データ、固有受容感覚(proprioceptive data)はほぼ存在しない」
固有受容感覚とは、自分の体の位置や動きを感知する能力のこと。人間では筋肉・腱・関節に組み込まれているが、現在のロボットにはこのデータが決定的に不足している。
市場の熱量と技術的現実のギャップ
ロボティクス市場への資本流入は凄まじい。Morgan Stanleyの2025年レポートは、人型ロボット市場が2050年までに5兆ドル超に達すると予測。BMWはすでに工場に人型ロボットを導入し、TeslaはOptimus開発を主力事業の一つに据えている。中国のUnitreeは9億ドルのIPOを進めている(FCCが外国製人型ロボットの新規導入を禁じる直前に、複数モデルの米国認証を取得している)。
こうした熱量の一方で、DeepMindの研究者たちは技術的課題を冷静に認識している。「データを十分に与えれば知性が生まれる。言語モデルと同じだ」とRaoは言う。しかしその「十分なデータ」をどこから調達するかは、未解決の問題だ。
安全性への対応として、DeepMindはSF作家アイザック・アシモフにちなんだ新ベンチマークAsimovを公開した。人間が近づきすぎた場合にロボットを安全に停止させる仕組みも実装されている。ハードウェア側でも、Apptronikは Apollo 2に独自のセンサーと安全システムを組み込んでいる。
「一つの頭脳で複数の本体を」を阻む身体ギャップ
「一つのAIで複数のロボット本体を動かす」という構想において、最大の技術的障壁の一つがembodiment gap(身体ギャップ)だ。これは、AIモデルが学習した身体の特性と、実際に制御するロボット本体の物理的特性との差異を指す概念で、差が大きいほど転移学習の効率が落ちる。
なぜ現在の取り組みが人型ロボットに集中しているかは、この概念で説明できる。ロボットが人間のデモンストレーションを模倣して学習する「模倣学習(imitation learning)」では、ロボットの体が人間の体に近いほど身体ギャップが小さくなり、学習が効率的になる。また実用面でも、人間が設計した環境(カウンターの奥行き約63cm、ドア幅約91cm)を動き回るには人型が合理的な選択だ。
逆に言えば、身体ギャップを乗り越えることこそが「一つの頭脳で多様なロボット本体を動かす」という本構想の核心的課題でもある。シェフィールド大学のJames Marshall教授が指摘するように、「四足歩行機から人型、ドローンへの移行は、脳がそれをどう解決するかをまだ完全には理解していないため、より困難でデータ集約的だ」。
関連リンク
- Asimov Benchmark(公式サイト) — DeepMindが公開した安全性評価ベンチマーク
- Gemini Robotics(Google DeepMind公式) — Gemini Roboticsシリーズの技術解説
詳細はGoogle DeepMind wants to build an AI brain that can jump between robot bodiesを参照していただきたい。