9月19日、n8nが「Reducing AI Workflow Latency: Patterns That Actually Work」と題した記事を公開した。800msかかるAPI呼び出しが3つ直列に並ぶと合計2.4秒かかるが、並列化すれば約800msで済む——このような構造的な問題は、モデルをより速いものに替えるだけでは解決しない。記事はAIワークフローのレイテンシがどこで発生するかを3層で整理し、並列実行・タイムアウト・キャッシュといった実践的なパターンで削減する方法を詳しく紹介している。
「モデルを速いものに替えれば解決」は間違い
単体のLLM呼び出しが速くても、ワークフロー全体では複数のAPI呼び出しが直列に積み重なり、体感レイテンシが一気に悪化する。記事が最初に指摘するのは、この「層ごとに原因が異なる」という点だ。
レイテンシの発生源は3層に分かれる:
- モデル推論:プロンプトの処理とトークン生成にかかる時間
- ツール・API呼び出し:外部エンドポイントへのネットワーク往復とその処理時間
- オーケストレーションオーバーヘッド:ステップ間の調整、メモリ、ファイル転送などの積み重ね
モデルを替えてもツール呼び出しや直列構造の問題は残る。最適化の順序として記事が強調するのは「まず計測、次にワークフローパターン、最後にモデルレベル」という優先順位だ。
最も効果が大きい:並列ツール呼び出し
記事が最も厚く紹介しているのが、n8nのAI Agentノードを使った並列ツール実行だ。
例として、2つの通貨レートを取得してから計算を行うエージェントを挙げている。2つのレート取得は互いに独立しているため、同じターンで並列実行できる。計算ステップはその結果を待って直列に動く。
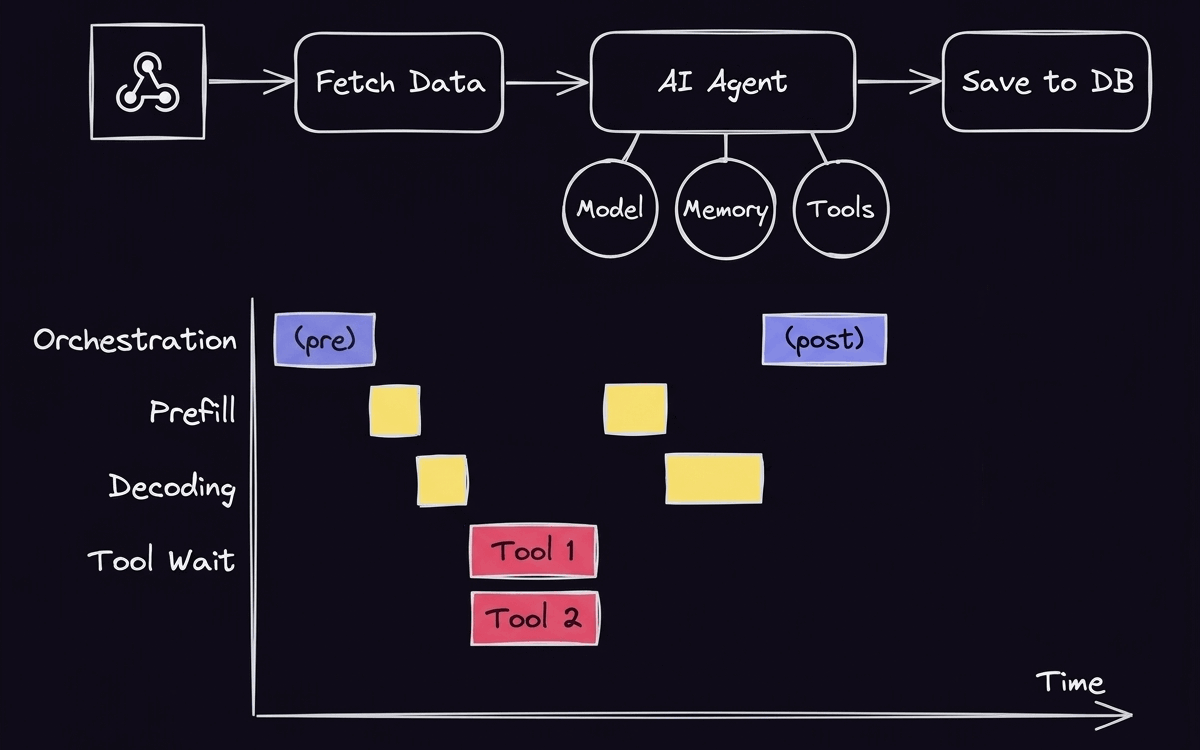
並列実行により、ツールの実行時間が重なるだけでなく、LLM呼び出し回数も削減できる(両ツールの完了後に1回だけ呼び出す)
最近の主要LLMはパラレルツールコールをサポートしており、プロンプトでこの機能の使用を指示することで対応できる。より複雑な構成では、AI Agent Toolノードを使って専門エージェントに処理を委譲することも可能だ。
フェイルファスト:タイムアウトとガードレール
ハングしたAPI呼び出しは最もコストの高いレイテンシの一つで、それが解決するまで後続の処理が一切動けない。
HTTP Requestノードにはタイムアウトを設定でき、遅いエンドポイントに対してワークフロー全体を止めるのではなく、意図的なフォールバックへ切り替えられる。
リトライは一時的な障害への対策として有効だが、レイテンシを増やす諸刃の剣でもある。1秒かかるAPI呼び出しを3秒タイムアウト×3リトライで処理すると、失敗時に最大9秒超を消費する。ノード設定の「Retry On Fail」とワークフロー設定のタイムアウトを組み合わせて上限を設けることが推奨されている。
入力の段階で悪いリクエストを弾くにはGuardrailsノードが使える。URL、正規表現、シークレットキー、個人情報などの検出・サニタイズを設定でき、違反を検出した場合はFailブランチに分岐させることも可能だ。
モデル選択とトークン削減
ワークフロー設計が整ったら、モデルレベルの最適化に移る。
タスクに合ったモデルサイズへのルーティングが基本だ。分類や短い抽出タスクは小型モデルで十分処理できる。70Bの大型密結合モデルをMoE(Mixture of Experts)などの小型モデルに切り替えると、1クエリあたり数百ミリ秒の削減になる。大型モデル(特に推論機能付き)はマルチステップの複雑な自動化に絞って使う。
出力トークンの削減はさらに直接的だ。OpenAIのレイテンシ最適化ガイドによると、出力とレイテンシの関係はほぼ線形で、出力トークンを50%削ればレイテンシも約50%削減できる。最大出力長を設定し、短いフィールド名の構造化出力を指定し、回答語数を制限することが有効な手段として挙げられている。
セマンティックキャッシュで推論をスキップ
プロンプトキャッシュ(同一プレフィックスの再利用)はモデルプロバイダー側の機能だが、セマンティックキャッシュはより踏み込んだ最適化だ。
「返品期間はいつまでですか?」と「いつまで返品できますか?」は言い方が違っても意味は同じ。セマンティックキャッシュはこれを検出し、モデルを呼び出さず過去の回答を返す。n8nではRedis Vector Storeがこのゼロ推論ヒットを実現する。
Redis Vector Storeを使ったセマンティックキャッシュでは、入力クエリをベクトル化してRedis上に保存された過去のクエリと類似度比較を行い、閾値を超えた場合にキャッシュ済みの応答を返す構成が一般的だ。類似度の閾値設定はキャッシュヒット率と回答精度のトレードオフになるため、ユースケースに応じた調整が必要になる点には注意したい。また、回答の鮮度が重要なユースケース(在庫状況や価格情報など)では、TTL(Time to Live)を短めに設定するか、セマンティックキャッシュの対象外とする設計が求められる。
レイテンシ計測の基準値
記事では以下の指標と目安が示されている:
- TTFT(Time to First Token):最初のトークンが届くまでの時間。目安は300〜500ms以下。1秒以上かかる場合はサーバー過負荷の可能性がある
- Output TPS(Output Tokens per Second):初回応答後のトークン生成速度
- TTCR(Time to Complete Response):TTFT+Output TPSの合計
ワークフロー種別ごとのレイテンシ予算の目安:
| ワークフロー種別 | 目標レイテンシ |
|---|---|
| リアルタイム(チャットbotなど) | 500ms以下 |
| バッチ処理 | 5〜20秒 |
| バックグラウンド処理 | 30秒以上でも可 |
レイテンシが本当の問題なのか、精度やリトリーバルの問題なのかを先に確認することも推奨されている。計測なしに最適化に入ると、ボトルネックでない箇所に時間を費やすことになりかねない。
詳細はReducing AI Workflow Latency: Patterns That Actually Workを参照していただきたい。