9月22日、Redpandaが「8 engineering lessons on running AI agents in production」と題した記事を公開した。この記事では、ペタバイト規模のセキュリティデータをAIエージェントで処理するRed Canaryの本番運用から得た8つのエンジニアリング知見について詳しく紹介されている。以下に、その内容を紹介する。
AIエージェントをデモで動かすのは簡単だ。難しいのは、実際のデータ・権限・オペレーターが絡む本番環境に持ち込んだときに何が起きるかだ。
この記事は、セキュリティ会社Red Canary(現Zscaler傘下)の共同創業者兼CEOであるBrian Beyerと、同社元CTOでその後furlを創業したJoe Molesへのインタビューをベースにしている。二人は、1日ペタバイト規模のセキュリティデータを比較的少人数のエンジニアチームで処理するプラットフォームを構築し、その上にAIエージェントを乗せた経験を持つ。
最も刺さる教訓:「決定論的な処理を先に書け、エージェントはその次だ」
Joe Molesが語る教訓の中で最も実践的なのが、「エージェントを使うべき場所の見極め方」だ。
判断の出発点はシンプルで、「その処理はすでに決定論的か?」を問うことだ。ルールを書けるなら書け。A+B=Cで完結するならコードにしろ。それは安く、速く、余計なスタックを必要としない。
エージェントが本領を発揮するのは「その上の層」だ。処理が完全に決定論的ではないが、よく理解されている領域、つまり「聞くべき質問は分かっているが、スクリプトやフローチャートには落とし込めない」領域がそれに当たる。
「AIと考えるのではなく、自然言語による自動化だと思え」— Joe Moles, CTO, furl
例えばRed Canaryでは、特定のデータソースとふるまいに対して「聞きたい質問が20〜30個ある」という状況があった。そうなるとプロンプト化できる。「このエンドポイントデータをある挙動について調査し、これらの質問に答えて、サマリーを返せ」という指示だ。エージェントはモデルに全部やらせるのではなく、ツール群を自然言語でコーディネートする小さなレイヤーとして機能させるのが正しい。
複雑なシステムは単純なコンポーネントで作れ
Brianが建築原則として挙げるのが、「複雑なシステムは、非常に単純なコンポーネントの組み合わせで作れ」というNetflixの初期アーキテクトの言葉だ。
Red Canaryのデータフローでは、各コンポーネントが単一の責務を持つ。テレメトリがインジェスターに入り、整形・標準化され、検知エンジンを通った後、エージェント調査か自動調査にルーティングされ、必要に応じて検知エンジニアが介入する。
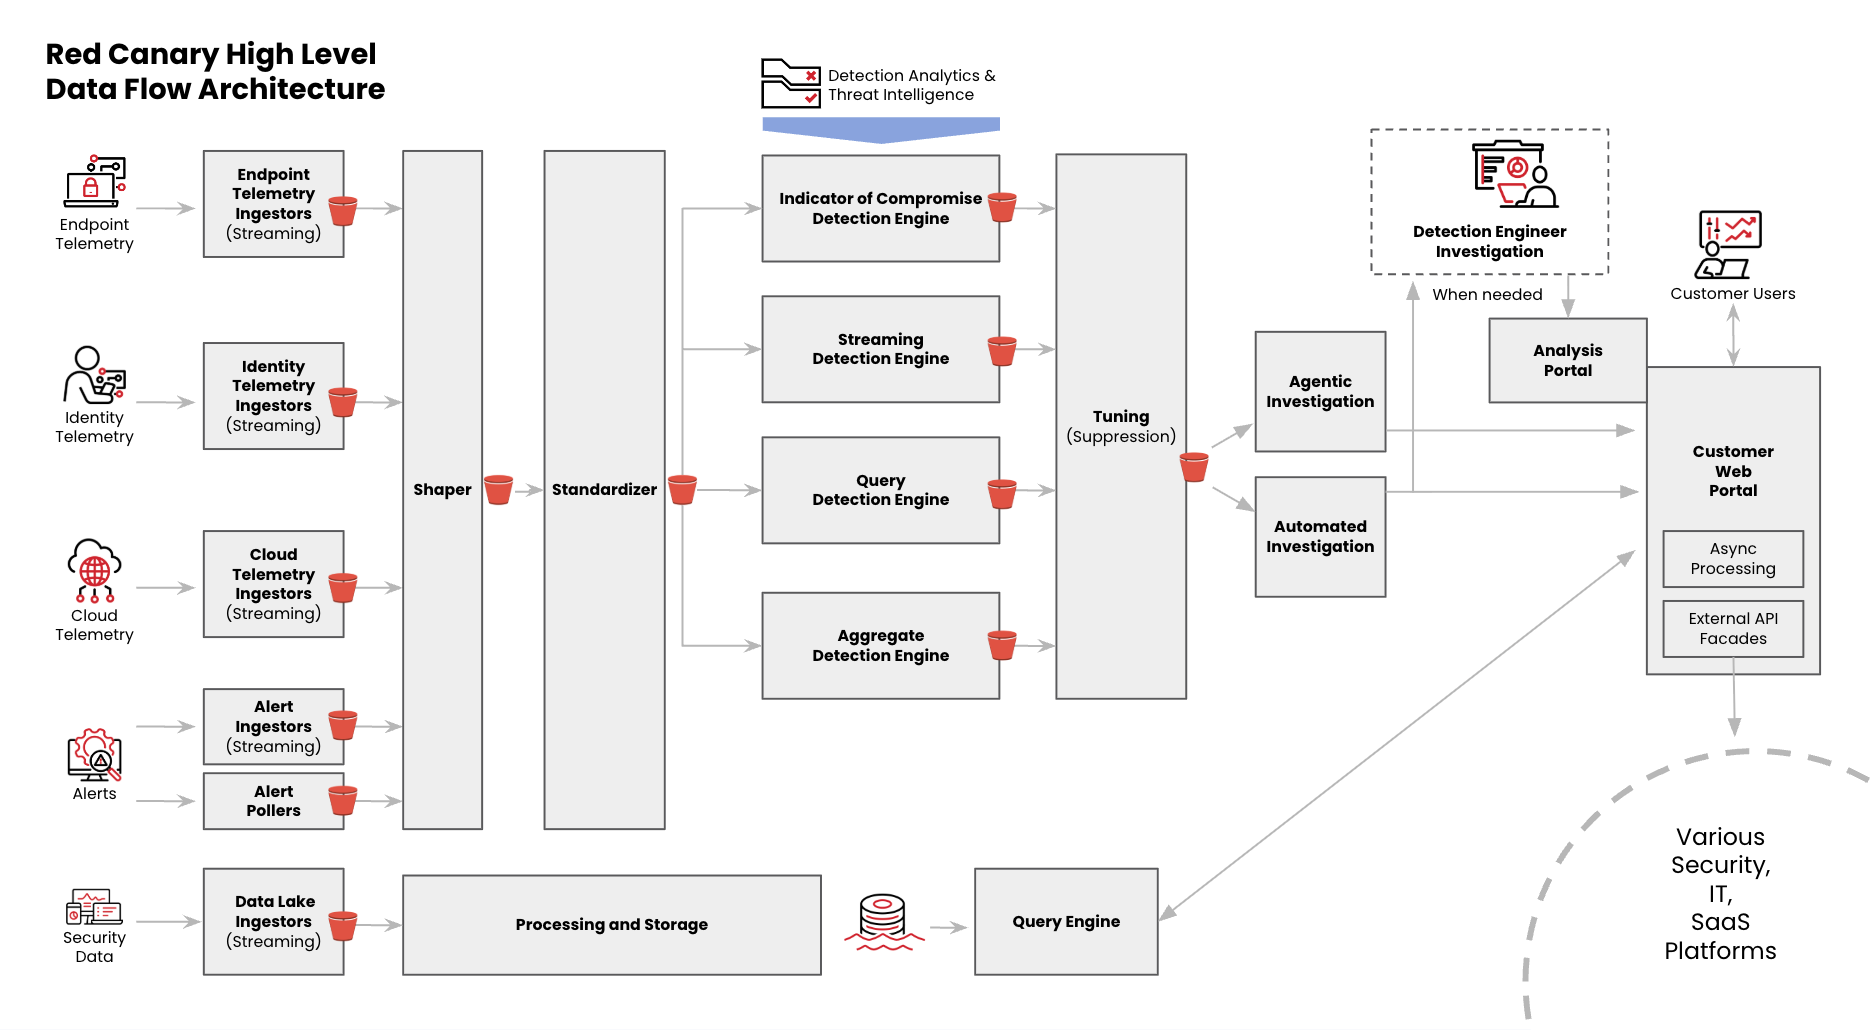
このアーキテクチャの恩恵は、エージェント実験のコストを下げられる点だ。新しいアイデアがあれば、標準化されたデータをサブスクライブする新しいボックスを一つ追加し、フィルターでサンプルトラフィックだけを流す。本番パスには触れない。うまくいけばメインパイプラインに組み込み、そうでなければQAプロセスを通す。
エージェントを「新入社員」として扱え
Joe Molesが語る失敗パターンは明確だ。「手近なエージェント環境に全データを突っ込んで、一気に全部解決しようとすること」。彼の言葉を借りると「それは悲劇に終わる(it leads to sadness)」。
Red Canaryでは、各エージェントに「ベースボールカード」と呼ばれるドキュメントを用意した。タスク・必要なもの・期待するアウトプットを明記したものだ。新しいエージェントは最初は厳しい監視下に置き、成果物に対してコーチングを行い、品質が安定してから監視を緩める。まさに新入社員のオンボーディングと同じプロセスだ。
KPI設定も同様で、コスト・速度・品質など測定可能な指標でパフォーマンスレビューを行う。
土台がない場合はどこから始めるか
「10年分の意思決定ログも、クリーンなトレーニングデータもない場合はどうすればいいか?」という問いに対して、BrianとJoeは同じ答えを返した。
「今やっていることを書き出せ」
Joeの比喩が分かりやすい。「ピーナッツバターとジャムのサンドイッチの作り方を説明しろ」という古典的な演習と同じで、自分のプロセスをステップバイステップで説明できるかを確認する作業だ。
ただし全プロセスを一度に文書化しようとしてはいけない。「サンドイッチ全体を文書化するな。まずパンにピーナッツバターを塗るところだけ文書化しろ」とJoeは言う。そうすると、これまで意識していなかったステップが浮かび上がり、それをさらに文書化できる。
図は「人間が読むために描け」。クラウドプロバイダーの公式アイコンを使ったデータフロー図が最も有効な成果物だとBrianは言う。コンポーネント間の依存関係は自動生成できても、「なぜそのデータフローなのか」の意図は自動生成できない。
残り3つの教訓を簡潔にまとめると
- データの質が精度を決める:Red Canaryの調整が速かった理由は、専門家が記録した大量のヒューマントレーニングデータがあったからだ。信頼できないデータをエージェントに渡せば、それをもとに学習してしまう。
- アクセス制御は「新入社員テスト」で判断:「新しく雇ったエンジニアに本番データ全部を渡すか?」という問いを使え。渡さないならエージェントにも渡すな。
- 成果から逆算して始めよ:技術やデータを起点にするのではなく、どんな状態を達成したいかを定義し、そこから必要な決定ポイントとデータを逆算する。
Joeの最後の一言が、この記事の本質をよく表している。
「全部システム構築の話だ。エージェントシステムも、また別のシステムに過ぎない」— Joe Moles, CTO, furl
詳細は8 engineering lessons on running AI agents in productionを参照していただきたい。