9月28日、Stack Overflowが「Why model versioning is not enough for production AI」と題した記事を公開した。この記事では、本番AIシステムにおいてモデルのバージョン管理だけでは不十分であり、プロンプト・検索設定・サービング構成を含む「リリース全体」を単位として管理・評価・ロールバックする必要があるという実務的なMLOpsの考え方について詳しく紹介されている。
モデルバージョンだけでは本番は守れない
「モデルは変えていない。サービスは正常だ。デプロイチェックも全部通った。でも本番が壊れた」――こういう障害はMLOpsをある程度経験したエンジニアなら身に覚えがあるはずだ。
記事が冒頭で提示する仮説的なインシデントはこうだ。ドキュメントアシスタントが、検索(リトリーバル)の設定を変更した後にタイムアウトを起こすようになった。原因は、リトリーバルが送るコンテキストが増えたことで生成に時間がかかり、推論サーバーのキューが詰まったことだった。アプリケーションコンテナを以前のバージョンに戻しても、検索設定は別の場所に存在するため効果がない。
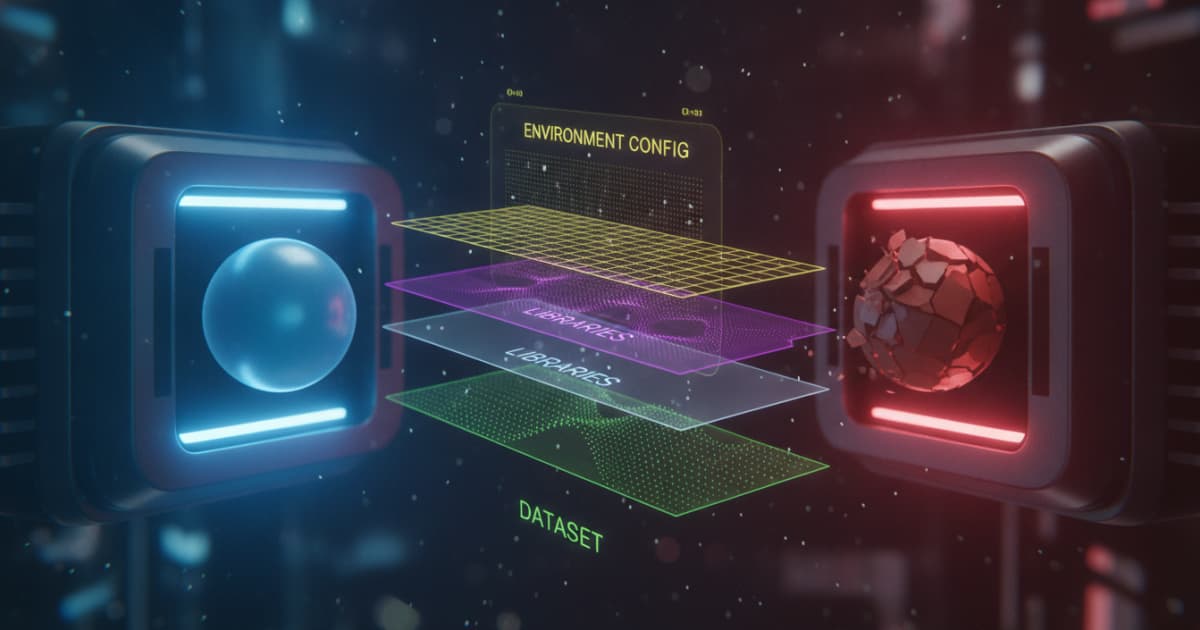
この問題の本質は「何をデプロイしたか」の定義にある。AIアプリケーションにおいてモデルバージョンは答えの一部に過ぎず、入力前処理・プロンプト・検索パイプライン・ツール定義・サービング設定のそれぞれが独立してシステムの挙動を変える。GoogleがMLOpsガイダンスで指摘する「学習時と推論時の特徴変換のズレ(training-serving skew)」は従来のMLでも既知の問題だったが、生成AIアプリケーションはその依存関係の数をさらに増やす。
解決策の起点:リリースマニフェスト
記事が提示する実践的な出発点は「大きなプラットフォームを導入すること」ではない。バージョン管理されたリリースマニフェスト、意味のある評価ゲート、実際にテスト済みのロールバックパスの3点だ。この3つが揃って初めて、「何がデプロイされていたか」を障害時に確実に特定できる。
RAG(Retrieval-Augmented Generation)アプリケーションを例に、記事は以下のようなマニフェストを提示している。
release_id: docs-assistant-r17
app_revision: git-8f2a1c
model_revision: model-snapshot-42
prompt_revision: support-v7
retrieval:
  index_revision: docs-index-2026-09-01
  embedding_revision: embed-v3
  pipeline_revision: chunk-and-rank-v4
runtime_revision: serving-config-v6
evaluation_suite: support-regression-v12
previous_release: docs-assistant-r16
ポイントはいくつかある。runtime_revisionはトークン上限・バッチサイズ・タイムアウト・リソース配置といった実行に影響する設定を含むべきだ。ツールを呼び出すアプリケーションであれば、そのスキーマやアダプターもバージョン管理する。シークレットの値ではなく参照のみを記録する。
また、このマニフェストはビット単位の完全再現性を保証するものではないと記事は明記する。外部サービスは変わるし、生成は非決定的であり続ける。フローティングエイリアスを固定バージョンに見せかけるのではなく、その限界を記録する方が誠実だ。データが継続的に変化する場合は、インジェストのウォーターマークとインデックス設定を記録しておくことで、完璧なリプレイができなくても障害を調査できる。
重要な設計原則として記事は強調する:「4つの設定ストアを順番に更新していくのはアトミックなリリースではない」。
評価ゲート:モデル単体をテストしても意味がない
HTTPステータスが200を返してもユーザーへの回答が失敗することはある。評価ゲートはエンドポイントの死活監視とは別物だ。
記事が推奨する評価データセットの構成:
- 通常の質問
- 過去に観測された失敗ケース
- 曖昧なリクエスト
- 証拠が不足しているケース
- 認可境界を越えようとする試み
評価はリリース全体のパスを通して実行することが肝心だ。冒頭のインシデントで言えば、モデル単体のテストでは検索コンテキストの変化を捉えられない。検索→生成→出力検証の全経路を同じリリースで実行し、長い入力・複数言語・証拠が薄いリクエストといった意味のあるスライスで結果を確認する。
承認基準は「候補を見る前に決める」。実用的なポリシー例として記事は挙げる:アクセス制御違反が1件でも観測されたらブロック、重要なタスクスライスが許容レンジを超えて退行していたらブロック、代表的なワークロードでレイテンシ・コストのバジェットが維持されていること。
評価が失敗したときは、候補とベースラインのリリースID・データセットリビジョン・失敗ケース・関連トレースをデバッグアーティファクトとして残す。「品質が下がった」とだけ書かれた赤いビルドは、次のエンジニアに別の調査プロジェクトを押し付けるだけだ。
レイテンシ計測の落とし穴
LLMワークロードをRPSだけで表現するのは不十分だ。短い質問と短い回答、長いドキュメントと長い回答では推論サーバーへの負荷が大きく異なる。
ストリーミングレスポンスの場合、Time to First Token(TTFT)・後続トークンの生成速度・完了までの総時間を分けて計測する必要がある。vLLMのメトリクスドキュメントはキュー深度ゲージやトークンカウンターを含むこれらの計測を公開しているが、それはサーバーサイドの数値であって、検索・ネットワーク・レンダリングを含むクライアント側のレイテンシとは別物だ。
各ステージのp95を足し合わせてエンドツーエンドのp95と呼ぶのは誤りだ。それぞれのパーセンタイルは異なるリクエストを表しているかもしれない。リクエスト単位のタイミングを使って、遅いリクエストがどこで時間を使っているかを特定する。
バッチングのトレードオフについても言及がある。NVIDIA Tritonのドキュメントがダイナミックバッチングのキュー遅延設定でこれを明示しているように、スループット向上とユーザー体験の遅延増加はトレードオフの関係にある。「実際に動かすスケジューラをベンチマークする」という教訓は汎用的だ。
カナリアリリースとロールバックの現実
カナリアリリースの価値は「特定の割合が普遍的に安全だから」ではなく、「露出を限定して比較を作れるから」だ。GoogleのSREガイダンスも、ロールアウトを拡大する前にカナリアとコントロールのシグナルを比較することを強調している。
割り当て方法は慎重に選ぶ。リクエストのランダム割り当てが独立したタスクには問題ないとしても、会話セッションでは途中で挙動が変わらないよう安定した割り当てが必要になる場合がある。
ロールバックで最も重要な点は「モデルの重みを戻せば終わりではない」ということだ。候補リリースが検索インデックスを上書きしていた場合、古いアプリケーションイメージに戻しても新しいインデックスを読み続ける可能性がある。互換性のあるインデックスバージョンを保持するか、可逆なマイグレーションを設計する必要がある。
ルーティング変更は未アサインのリクエストにしか効かない。進行中の生成には明示的なドレインまたはキャンセルポリシーが必要だ。ツールの副作用(メール送信、レコード更新)はモデルバージョンを切り替えても取り消せない。冪等性と適切な承認境界で別途保護する。
最小限の実装から始める
記事は既存のリポジトリで始められる最小実装を提示して締めくくる:リリースマニフェスト、評価ジョブ、代表的な負荷テスト、リリースを認識したトレース、そして実際に演習済みの前バージョンへの切り戻し手順。プラットフォームの機能追加は、繰り返し発生するオペレーション上の痛みが正当化するときに行えばよい。
記事の最後の問いが鋭い:「次のリリース前に、オンコールエンジニアは不正な回答の背後にある完全なリリースを特定し、互換性のある既知良好バージョンを復元できるか? できないなら、デプロイを速くする前にそのパスを改善せよ」。
詳細はWhy model versioning is not enough for production AIを参照していただきたい。