10月9日、PyTorchが「Session-Aware Agentic Inference with NVIDIA Dynamo」と題した記事を公開した。NVIDIA Dynamoがセッションレベルの識別子を軸にエージェント型推論を最適化する仕組みについて詳しく紹介されており、マルチターンエージェント基盤の設計に携わるエンジニアには見逃せない内容だ。
なぜ「エージェント推論」は難しいのか
LLMを単純なチャットに使う場合と、AIエージェントとして使う場合では、推論サーバーが受けるトラフィックの形が根本的に異なる。
チャットは「ユーザー→モデル→ユーザー→モデル」のシンプルな往復だ。しかしエージェントは、数万トークンのシステムプロンプトやツール定義を含む大規模なプリフィル(初期入力処理)から始まり、ツール呼び出しのたびに同じコンテキストを再送し、複数のサブエージェントが並列で動き続ける。そしてGPU上のKVキャッシュ(前の計算結果を再利用するためのメモリ)は、ツール実行の待ち時間中も居座り続ける。
問題は、ほとんどのオープンソース推論スタックが「1リクエスト単位」で設計されており、セッションをまたぐ文脈を持っていない点だ。リクエストごとにルーティングし、キャッシュし、アドミッション制御する——これはチャット向けには合理的だが、エージェントには致命的な非効率を生む。KVキャッシュの退避が頻発し、次のターンのたびに毎回フルプリフィルが走るという状態に陥りやすい。

Figure 1: 標準的なチャットボットと、ツール呼び出しを含むエージェント型ワークフローの比較。エージェントでは1つのユーザーリクエストが複数の推論呼び出しを引き起こす。
NVIDIA Dynamoはこの問題に対し、「セッションID」という単一のプリミティブを軸に解決策を組み上げた。
Session IDで推論スタックをプログラム認識型に変える
session_id は、1つのエージェントの推論チェーン全体を通じて一貫して付与される識別子だ。同一セッション内のすべてのLLMリクエストが同じsession_idを共有し、サブエージェントはparent_session_idを持つことで親子関係も追跡できる。
Claude Code・Codex・OpenCodeはそのまま動く
主要なコーディングエージェントはすでに独自のセッションヘッダーを送信している。DynamoはこれらをそのままマッピングしてSessionIDとして扱う。追加設定は不要だ。
| コーディングエージェント | セッションヘッダー | 親ヘッダー |
|---|---|---|
| Claude Code | x-claude-code-session-id / x-claude-code-agent-id | x-claude-code-parent-agent-id |
| Codex | thread-id | x-codex-parent-thread-id |
| OpenCode | x-opencode-session-id | x-opencode-parent-session-id |
対応していないハーネス(エージェントフレームワーク)向けにはagent-pluginsリポジトリが提供されており、HermesなどのミドルウェアプラグインによってSession IDを透過的に付与できる。
カスタムハーネスの場合は、HTTPヘッダーX-Dynamo-Session-IDを1行付けるだけで全最適化がオプトインできる:
curl http://localhost:8000/v1/chat/completions \
  -H 'Content-Type: application/json' \
  -H 'Authorization: Bearer sk-dummy' \
  -H 'x-dynamo-session-id: research-run-42:researcher' \
  -d '{"model":"my-model","messages":[{"role":"user","content":"..."}]}'
リクエスト単位ルーティングの根本的な問題
Session IDがなぜ重要かを理解するには、リクエスト単位ルーティングの限界を知る必要がある。
KVキャッシュの膨張問題。 エージェントのターンとターンの間、KVキャッシュはHBM(GPU上の高帯域メモリ)を占有したまま解放されない。N個のエージェントがステップkを並列実行しているとき、合計ワーキングセットはN × context_kに達する。リクエスト単位のルーターはこの合計量を把握できないため、HBMが枯渇するとライブセッションのキャッシュを強制退避し、次のターンで毎回フルプリフィルが走る。これが本記事の主題とする「エージェント推論における再計算コスト問題」の本質だ。
ツール境界でのバックプレッシャーなし。 ワーカーが過負荷になったとき、リクエスト単位のルーターができることは「キャンセル」か「キュー待ち」しかない。どちらも非効率だ。本来は次のターンが来る直前、つまりアイドル状態になるツール実行境界でセッションを一時停止するのが最善だ。
セッション認識型アドミッション制御:ThunderAgentポート実装
Dynamoが実装した解法は、ThunderAgentペーパー(Kang et al., 2026)のスケジューラーをRustでネイティブプラグインとして移植したものだ。ThunderAgentは、エージェントの推論フェーズとツール実行フェーズを明示的に区別し、フェーズ境界を利用してKVキャッシュ圧迫を緩和するスケジューリング手法を提案した研究である。DynamoはそのコアロジックをRustで実装し、vLLMやSGLangといった既存エンジンのフロントに差し込める形で提供している。
スケジューラーは各セッション(program_id)を(REASONING | ACTING) × (ACTIVE | PAUSED)という2軸の状態機械で管理する。ツール呼び出しに入るとACTING状態に遷移し、メモリ圧迫時にはACTINGセッションから優先的に一時停止をかける。
制御ループはワーカーごとの利用率U(KVプール容量に対するアクティブセッションのトークン占有率)を軸に動作する:
U_worker = (ACTINGプログラムのトークン重み合計) / (ワーカーのKVプール容量)
3つの閾値でループを制御する(デフォルト値):
- U ≥ 0.95(一時停止閾値): 最小のACTINGセッションからUが0.80に戻るまで停止
- 0.80 ≤ U < 0.95(ソフトデモートバンド): 停止はしないが優先度を-2.0ペナルティ
- U ≤ 0.85でのみ再開: フラッピング(停止→再開→停止の繰り返し)防止のヒステリシス
再開はビンパッキングで処理される——一時停止中のセッションをトークン数昇順に並べ、次のセッションを追加すると閾値を超えるまで順番に再開する。また30分の強制再開キャップがあり、無限スタベーションは防止される。
トレースとリプレイ:推論側の可視化
環境変数DYN_REQUEST_TRACE=1を設定するだけで、プロンプト内容を保存せずにセッション単位のトレースが取れる。各request_endレコードにはKVキャッシュのヒット率、ツール呼び出し名、トークン数、シーケンスハッシュが含まれる。
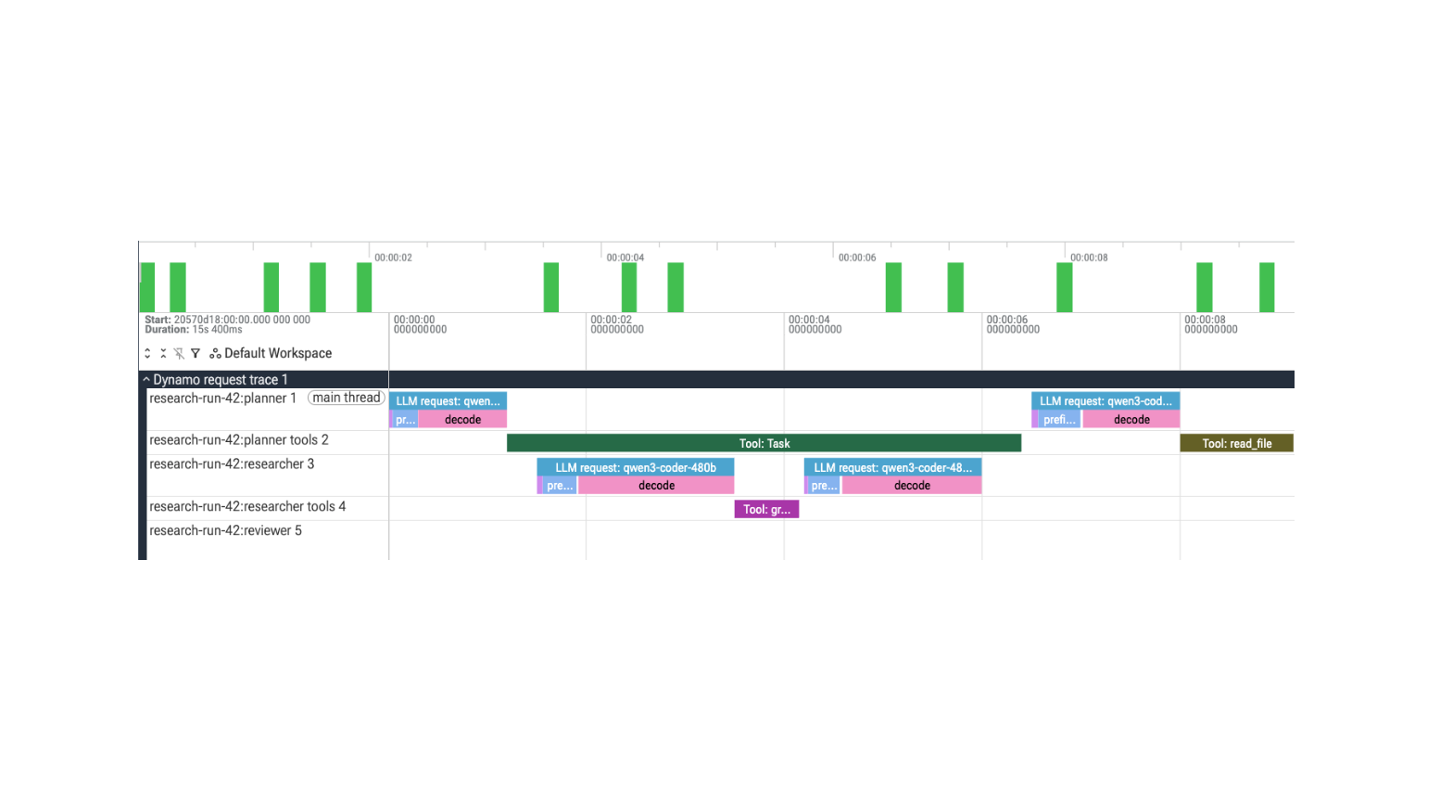
Figure 2: プリフィル・デコード・ツール実行が同一タイムライン上に表示され、作業のシーケンスと並列度が確認できる。
このトレースは再利用可能なベンチマークとして機能する。AISimulateでオフラインシミュレーション(GPU不要)を実行し、ルーティングポリシーやキャッシュ容量を比較できる。実GPU上でのファイナル計測にはAIPerfで同じトレースをリプレイする。内部ではこれらのトレースをAIによるルーティング戦略の自動探索にも活用しているという。
まとめ
Session IDという単一の識別子を起点に、ルーティング、アドミッション制御、KVキャッシュ管理、トレース収集が連携する——これがDynamoのアプローチだ。vLLMやSGLangをエンジンとして使いつつ、セッション認識の恩恵を受けられる点も実用的で、既存スタックへの段階的な導入がしやすい。ThunderAgentスケジューラーのRust実装はソースコードごと公開されており、マルチターンエージェント基盤を自前で構築・運用しているチームにとっては実装参照としての価値も高い。エージェント推論のKVキャッシュ圧迫や再計算コストに課題を感じているならば、まずHTTPヘッダー1行の追加という低コストな入口から試してみるのが現実的な第一歩となるだろう。
詳細はSession-Aware Agentic Inference with NVIDIA Dynamoを参照していただきたい。