10月7日、Stack Overflowが「Part 4: Safety and governance for LLM systems: guardrails, PII, audit, and memory」と題した記事を公開した。この記事では、LLMシステムをプロダクション環境で運用する際に必要な安全・ガバナンス設計(ガードレール、PII処理、監査台帳、メモリスコーピング)の具体的な実装方法について詳しく紹介されている。
LLMが「デモ」から「実データ・実判断に触れるシステム」へ昇格する瞬間、「だいたい動く」はもはや合格基準にならない。本記事はStack Overflowが展開するLLM成熟度モデルシリーズの第4弾であり、チームが後付けで追加しがちな4つの規律——ガードレール、PII処理、監査台帳、メモリスコーピング——を、設計段階から組み込む方法を解説している。
過去3回のシリーズでは、Part 1でLLMシステムの基本設計方針、Part 2でプロンプト設計と評価(evals)、Part 3でエージェント設計(プランニング・ツール・メモリ)がそれぞれ扱われてきた。本稿はその最終章として、プロダクション運用に不可欠なセキュリティとガバナンスの実装を論じる。
多層ガードレール:「1枚のフィルタ」では話にならない理由
多くのチームがやりがちなのは、モデル出力に1つのモデレーションフィルタを追加して「ガードレール完了」とすることだ。これはファイアウォールルールを1行書いて「セキュリティ対策済み」と言うのと変わらない。
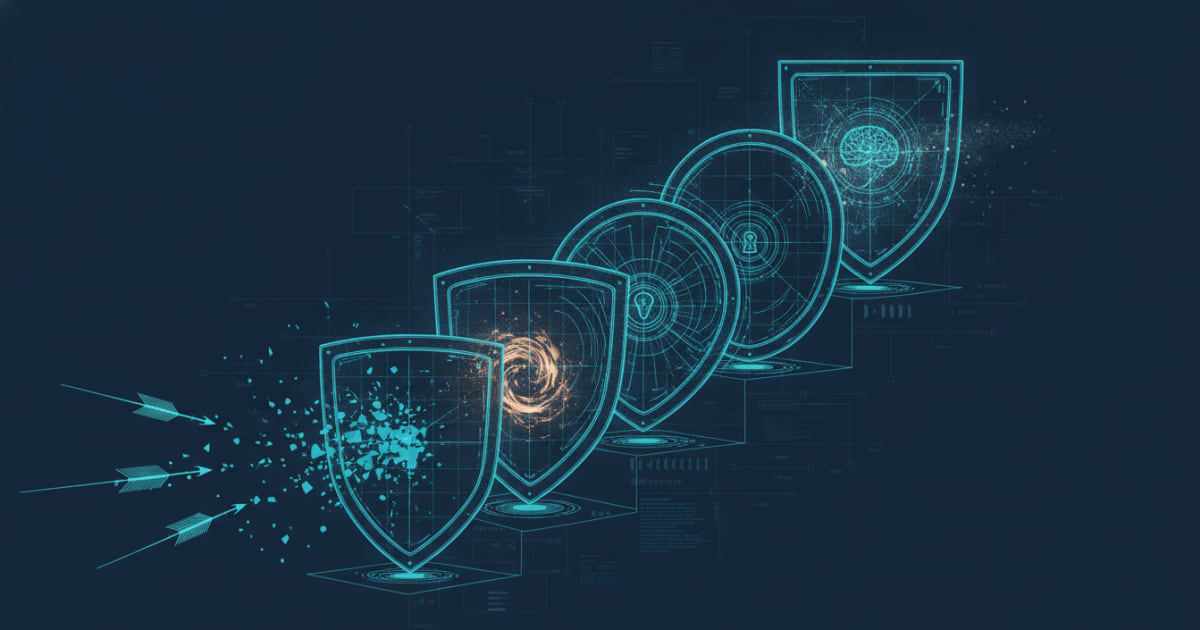
本記事が提示するのは多層防御(defense in depth)の考え方だ。6つの独立したレイヤーを直列に並べ、一つが見逃したものを次が捕まえる:
in ─▶[1 input]─▶[2 grounding]─▶(model)─▶[3 output scrub]─▶[4 verify]─▶[5 judge]─▶[6 confidence/route]─▶ act|escalate
| レイヤー | 役割 | タイミング |
|---|---|---|
| 1 Input | インジェクション、異常入力 | モデル呼び出し前 |
| 2 Grounding | 禁止アクション・スキーマ外出力 | モデル呼び出しの制約 |
| 3 Output scrub | ポリシー違反、PII漏洩 | 生成後 |
| 4 Verification | ビジネスルール違反 | 決定論的コード |
| 5 Judge | 「もっともらしいが誤り」 | 第2モデルによるサンプル確認 |
| 6 Confidence/routing | 残存する不確実性 | 最終ネット |
各ガードレールは同じ小さなインターフェースに従い、独立して追加・削除・テスト・並び替えができる:
class Guardrail(Protocol):
    layer: str
    def check(self, ctx: "Context") -> GuardrailResult: ...
最重要ルールは「fail closed(失敗時は閉じる)」だ。ガードレールがエラーを投げた場合、リクエストを通過させるのではなくブロックまたはエスカレートする。そしてすべてのブロックをログに記録する。guardrail_blocks_total{layer, rule}のメトリクスは、攻撃・リグレッション・悪いデプロイを即座に検出できる最も鋭いプロダクションシグナルの一つだ。
def test_fail_closed_on_error():
    class Boom:
        layer = "x"
        def check(self, ctx): raise GuardrailError("boom")
    result = run_guardrails(ctx, [Boom()], NullMetrics())
    assert result[-1].action == "block"  # エラーしたガードレールはブロック、絶対に通過させない
典型的なアンチパターンも明示されている:fail-open(ガードレールなしより悪い——誤った安心感を与える)、モデルが言葉で回避できるガードレール(「Xをしないでください」というプロンプトはガードレールではない——出力空間をenumやスキーマで制約し、禁止されたものを表現不可能にする)、サイレントブロック(攻撃とバグの区別がつかなくなる)。
PII処理:「境界で処理する」原則
LLMシステムはコンテキストのために豊富なデータを欲しがり、すべての判断の記録を生成する。これは「必要のない個人情報を蓄積しない」という基本的な義務と衝突する。
解決策は境界でPIIを処理すること——入出力時に除去し、生の機密データをストア・ログ・モデルトラフィックに蓄積させない。
class Sensitivity(Enum):
    PUBLIC = 0
    INTERNAL = 1
    PII = 2      # マスク必須、共有メモリ禁止
    SECRET = 3   # 永続化禁止、ログ禁止、モデルへの送信も原則禁止

FIELD_POLICY = {
    "name": Sensitivity.PII, "email": Sensitivity.PII,
    "card_number": Sensitivity.SECRET,
    "amount": Sensitivity.INTERNAL, "category": Sensitivity.PUBLIC,
}
デフォルト拒否が重要だ:FIELD_POLICYに存在しない未知のキーはSensitivity.PIIとして扱う。
台帳(audit ledger)への書き込みには特別な注意が必要だ。決定が「何に基づいていたか」を証明する必要はあるが、機密ペイロードを保持する必要はない。ハッシュと伏字化済みサマリーを保存し、後で再ハッシュして同一性を証明する。
ここで注意点がある:HMAC(鍵付きハッシュ)を使うこと。クレジットカード番号やメールアドレスのような低エントロピーのフィールドは、素のSHA-256ではブルートフォース・レインボーテーブルで逆引き可能だ。テナントごとのキー(KMS管理)でHMAC-SHA256を使う必要がある。また、RFC 8785/JCSのような標準的なcanonical-JSON仕様を一つ決めて全体で使うこと——再ハッシュで同一バイト列が生成されなければ、監査台帳のハッシュチェーンが機能しない。
監査台帳:「ログ」と「台帳」は別物
「なぜシステムは3月にケースXに対してその判断をしたのか?」という問いが来たとき、ログだけでは答えられない。ログはローテートされ、非構造化されており、「真実」ではない。監査台帳は、すべての判断とその理由を記録する追記専用・改ざん検出可能な正規の記録だ。
CREATE TABLE decision_ledger (
  decision_id     TEXT PRIMARY KEY,
  ts              TIMESTAMPTZ NOT NULL,
  tenant_id       TEXT NOT NULL,
  inputs_hash     TEXT NOT NULL,      -- 生ペイロードではなく、canonical入力のキー付きハッシュ
  inputs_summary  JSONB NOT NULL,     -- 伏字化済み、PII不含のサマリー
  model_version   TEXT NOT NULL,
  prompt_version  TEXT NOT NULL,
  decision        JSONB NOT NULL,
  outcome         JSONB,              -- 後から書き込む唯一の可変カラム
  supersedes      TEXT REFERENCES decision_ledger(decision_id),
  prev_hash       TEXT,
  entry_hash      TEXT NOT NULL
);

-- アプリロールはINSERT + SELECTのみ。コードではなくDBで変更を防ぐ
REVOKE UPDATE, DELETE, TRUNCATE ON decision_ledger FROM app_role;
GRANT  UPDATE (outcome) ON decision_ledger TO app_role;  -- outcomeカラムのみ後から書き込み可
修正は上書きではなく追記で行う:誤った判断を修正する場合、既存エントリを編集するのではなく、古いエントリを参照する新しい行を追加する。
seq 1041  decision=approve  conf=0.91  supersedes=NULL
seq 1207  decision=reject   conf=NULL  supersedes=<1041のid>  reason="manual review"
履歴そのものが真実だ。古いエントリが暗黙のうちに誤りになることはなく、明示的に「superseded」となる。
ハッシュチェーンによる改ざん検出も実装する。各エントリのentry_hashは直前エントリのハッシュを含んで計算されるため、1行を改ざんすれば以降のすべてのentry_hashが不一致になる——改ざんを即座に検出できる仕組みだ。
ただしハッシュチェーンにも限界がある。末尾の切り捨て(tail削除:チェーンの末尾から数件ごと削除すれば、残った部分のハッシュは整合したまま)やジェネシスからの完全書き換え(先頭からすべて作り直すこと)は防げない。DBへの書き込みアクセスを持つオペレータレベルの脅威に対応するには、非対称鍵による署名と外部ストレージへのアンカリング(定期的な署名済みチェックポイントの外部公開)が必要だ。
メモリスコーピング:テナント間のデータ漏洩を構造で防ぐ
PII漏洩の見落とされがちな方向が横への漏洩だ——あるユーザーのコンテキストが、別のユーザーへの判断に使われるコンポーネントに到達してしまうケース。これはガードレールではなく、メモリモデルの構造で対処する。
記事では、メモリを以下の4スコープに分類し、スコープをまたいだデータ参照を構造的に禁止する設計を推奨している:
| スコープ | 内容 | 共有範囲 |
|---|---|---|
system |
プロンプトテンプレート・モデルバージョン | 全テナント共通(デプロイ時に設定) |
tenant |
テナント固有ポリシー・設定 | テナント内のみ |
session |
会話コンテキスト | セッション内のみ |
ephemeral |
単一リクエスト内の一時データ | リクエスト内のみ |
各メモリオブジェクトにはスコープとtenant_idが付与され、読み取り時にスコープ境界を超えるアクセスを拒否する。たとえばあるテナントのセッションメモリを別テナントのコンテキスト構築に使うことは、コードレベルで不可能になる。
@dataclass
class MemoryEntry:
    scope: Scope          # SYSTEM / TENANT / SESSION / EPHEMERAL
    tenant_id: str | None # SYSTEMスコープはNone、それ以外は必須
    key: str
    value: Any

def read(self, scope: Scope, tenant_id: str, key: str) -> Any:
    entry = self._store.get((scope, key))
    if entry is None:
        return None
    # テナントスコープ以上のエントリは、tenant_idが一致しなければ返さない
    if scope in (Scope.TENANT, Scope.SESSION) and entry.tenant_id != tenant_id:
        raise ScopeViolation(f"Cross-tenant access denied: {key}")
    return entry.value
もう一つの重要な設計判断は、システムが「出荷」するもの(デプロイ時に設定するもの)と、システムが「獲得」するもの(運用中に学習するもの)を明確に区別することだ。前者はコードレビューとCI/CDを経て変更され、後者は運用中に書き込まれる。この2種類を同じストアに混在させると、後者が前者を意図せず上書きするリスクが生まれる。スコープ設計はこの分離も自然に実現する——systemスコープへの書き込みはデプロイパイプラインのみに許可し、アプリロールからは読み取り専用とする。
記事全体を通じたコアメッセージは一つだ:単一の信頼ポイントに頼るな。ガードレールは多層に、