11月3日、The Next Platformが「Qualcomm Has Eyes On The AI Inference Datacenter With HBC And AI250」と題した記事を公開した。Qualcommが開発した新アーキテクチャ「HBC(High-Bandwidth Computing)」の初代シリコン検証が完了し、HBM4比でTbps/Wの指標において5倍のエネルギー効率を達成したという。AI推論データセンター向けプラットフォーム「Dragonfly AI250」との組み合わせで、NVIDIAがGPUで押さえるAI推論インフラ市場に正面から挑む構えだ。
「メモリウォール」という本質的な問題
AI推論の世界では今、「どれだけ速く計算できるか」よりも「どれだけ速くデータをチップに送り込めるか」の方が性能を左右する局面になっている。これがいわゆる「メモリウォール」と呼ばれる問題だ。計算ユニット(コンピュート)とメモリの間でデータを行き来させる帯域幅が、性能・消費電力・コストのボトルネックになっている。
現在の主なアプローチは2つある。
- オンチップメモリ方式:AIモデルを高速なチップ内メモリに収める
- HBM(高帯域幅メモリ)方式:プロセッサに積層メモリを組み合わせる(NVIDIAのGPUが代表例)
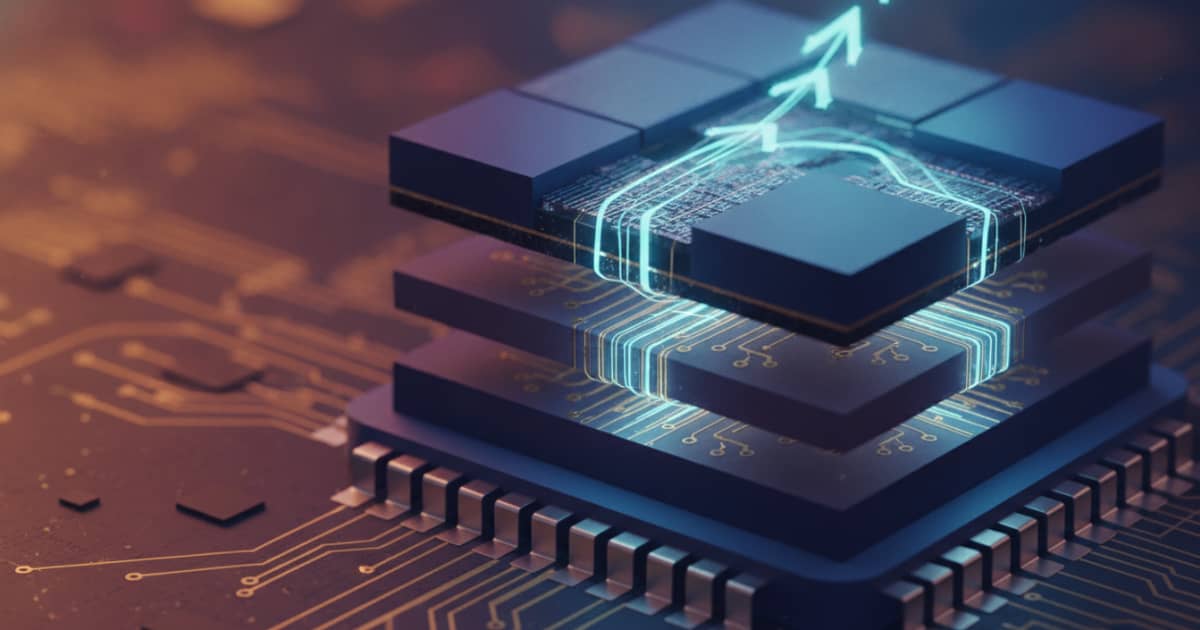
Qualcommが提唱するのは第3の道、NMC(Near-Memory Computing)=HBCだ。NMCとは、従来「メモリをコンピュートに近づける」という方向で行われてきた研究とは逆に、「コンピュートをメモリの近くに移動させる」設計思想を指す。HBCはそのNMCをシリコンレベルで実現した、Qualcommの独自実装である。
HBCの構造:メモリスタックの真下に演算器を置く
QualcommのDatacenter CPU・AI部門VPであるGerardo Giarettaは記者・アナリストに向けて、HBCの仕組みをこう説明している。
「パッケージ内にメモリスタックがあり、そのスタックの下に演算ダイがある。データをパケットで動かす必要がなくなる。メモリと演算の間に非常に高い帯域幅が自動的に確保され、データの移動距離がミリメートルからマイクロメートルに縮まるため、エネルギー効率も大幅に改善する」
具体的な検証結果として、HBCはLPDDRと比較して最大18倍のメモリ帯域幅を達成。さらにHBM4(第6世代高帯域幅メモリ)と比べて、Tbps/Wの指標で5倍のエネルギー効率を示した。この「Tbps/W」という指標は、1ワットあたりに転送できるデータ量(テラビット)で表される帯域幅効率であり、AIアクセラレータの実用的な消費電力評価に広く用いられる。
重要なのはHBCが「帯域幅だけ改善したメモリ」ではない点だ。Giarettaはこう強調している。
「我々がHBCと呼ぶのはHigh-Bandwidth Computeだ。メモリスタックの直下に実際のTFLOPSを持つ演算器がある。帯域幅の改善だけが目的ではなく、コンピュートをメモリのすぐ下に置くことで、帯域幅と演算効率の両方を得る」
AI250との組み合わせと「コプロセッサ」としての役割
第1世代のHBCでは、LPDDRスタックと完全なAIアクセラレータをワンパッケージに収める構成を採用している。AI推論の処理の大部分はHBCパッケージ内で完結し、一部の処理だけが中央のSoC(Dragonfly AI250)に移る設計だ。
Giarettaはこの関係を「コプロセッサ」と表現している。
「HBCを指示して、デコード処理の大部分をHBC内で完結させれば、AI250との間のリンクが相対的に遅くても、エンドツーエンドの性能には影響しない。データではなく『結果』を送り返すだけでいいからだ」
Dragonfly AI250は現在生産を開始しており、2027年上半期にサンプル出荷が予定されている。その後のロードマップとして、Dragonfly C1000 CPUが同じく2027年、Dragonfly AI300のサンプルが2028年に控えている。
「初めて誰かがやったこと」という自信
Qualcommは今回のHBCシリコン検証を、通常のチップ開発とは異なる扱いで公表している。Giarettaはその理由をこう語った。
「Qualcommでは普段、チップのブリングアップ(初期動作確認。新たに製造したシリコンを初めて電源投入し、設計通りに動作するかを検証するプロセス)でブログや事前説明を行うことはない。何千ものチップを作っているが、そうはしない。今回発表したのは、これが完全に新しいテクノロジーだからだ。来年の高歩留まり製造に向けた良い検証でもある」
「これは今まで誰もやったことがない」という自信の裏返しでもある。検証にはATE(Automated Test Equipment:半導体製造工程で標準的に用いられる自動テスト装置)を使用しており、production levelの品質を保証できると主張している。
NVIDIA支配の推論市場という文脈
AI推論のデータセンター市場では現在、NVIDIAがHopper(H100)やBlackwellアーキテクチャのGPUとHBMの組み合わせで圧倒的なシェアを握っており、クラウド各社のAI推論インフラの大半をNVIDIA製品が占める構造が固定化されつつある。この状況が、データセンター事業者やクラウドプロバイダーにとってベンダーロックインへの懸念を生んでいる。
Qualcommが1年以上かけてデータセンターAI市場への参入を進めてきた背景には、こうした構造的な課題がある。HBCとDragonfly AI250を統合したフルスタック推論インフラ「Qualcomm Dragonfly Rack」は、その代替として機能することを狙う一手だ。なお、HBCはAI250以外の製品にも展開される予定だとGiarettaは述べている。
詳細はQualcomm Has Eyes On The AI Inference Datacenter With HBC And AI250を参照していただきたい。