11月4日、Google Cloudが「What's new across Google's Agentic Data Cloud」と題した記事を公開した。AIエージェントの精度を約4倍向上させ、トークン消費を最大75%削減するという数値を掲げ、ストレージ・データベース・カタログ・クエリエンジンの各レイヤーを横断した大規模なアップデートの全容が明かされた。PayPal、Siemens、Walmart、Vodafoneといった企業がすでに本番稼働中とされており、単なるプレビュー段階の話ではない。
エンジニアが注目すべきコアコンセプト:「エージェントファースト」なデータ基盤
今回の発表群を貫くコンセプトは一つだ——AIエージェントが正確に動くには、データ基盤そのものをエージェント向けに再設計する必要がある。
これまでのデータ基盤はあくまで人間のクエリや定期バッチ処理を前提にしていた。エージェントが何百万もの並列推論セッションをリアルタイムに走らせる世界では、従来のアーキテクチャはそのまま通用しない。Google Cloudはこの問題を、ストレージ・データベース・カタログ・クエリエンジンの各レイヤーを横断して一挙に手を打ってきた。
最も面白いポイント:Knowledge Catalogの「自己学習」とAlloyDBのエージェント向けアーキテクチャ
Knowledge Catalog:エージェントの「誤答」問題に正面から挑む
エージェントが間違えるとき、多くの場合その原因はモデルではなくコンテキストの不足だ。Google Cloudが公開している自社内部ベンチマークによれば、Knowledge Catalogを使うことでAIエージェントの精度が約4倍向上し、レイテンシが最大33%低下、トークン消費が最大75%削減されるという。これらはいずれもGoogle Cloud自身が計測・発表した数値であり、独立した第三者評価ではない点に留意が必要だ。
今回のアップデートで追加された自己学習エンリッチメント(プレビュー)は、エージェントがGoogle Workspace、GitHub、Jira、Confluence、SharePointといった非構造化ソースを継続的にマイニングし、コンテキストのギャップを自動的に埋めていく仕組みだ。蓄積された知識はOpen Knowledge Format(OKF)と呼ばれる再利用可能な形式でパッケージ化され、データスチュワードがガバナンスを維持しながら利用できる。
あわせて発表されたKnowledge Catalog Studio(プレビュー)は、コンテキストグラフを視覚的に探索し、エンリッチメントの提案をレビュー・承認するUIだ。バージョン管理とロールバックにも対応しており、「LLMに任せっぱなし」ではなく人間が最終的な管理権限を持つ設計になっている。
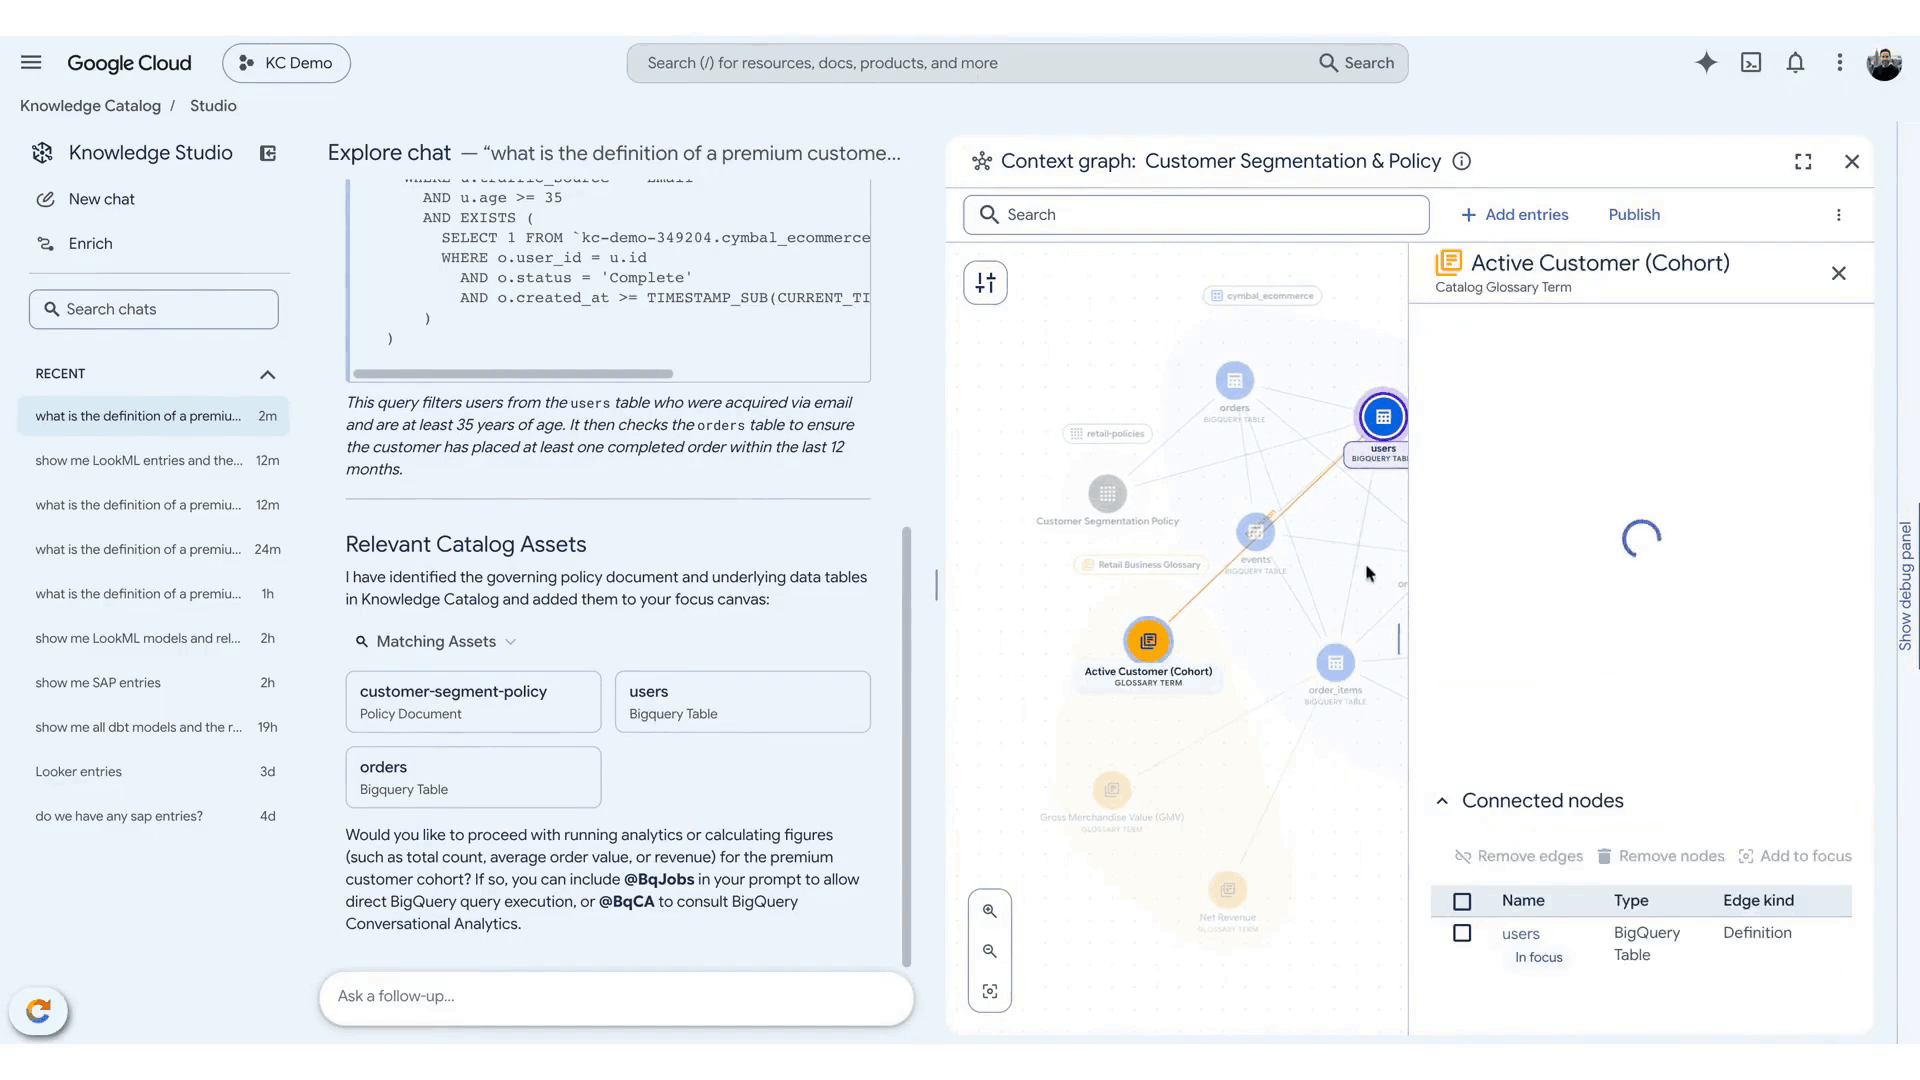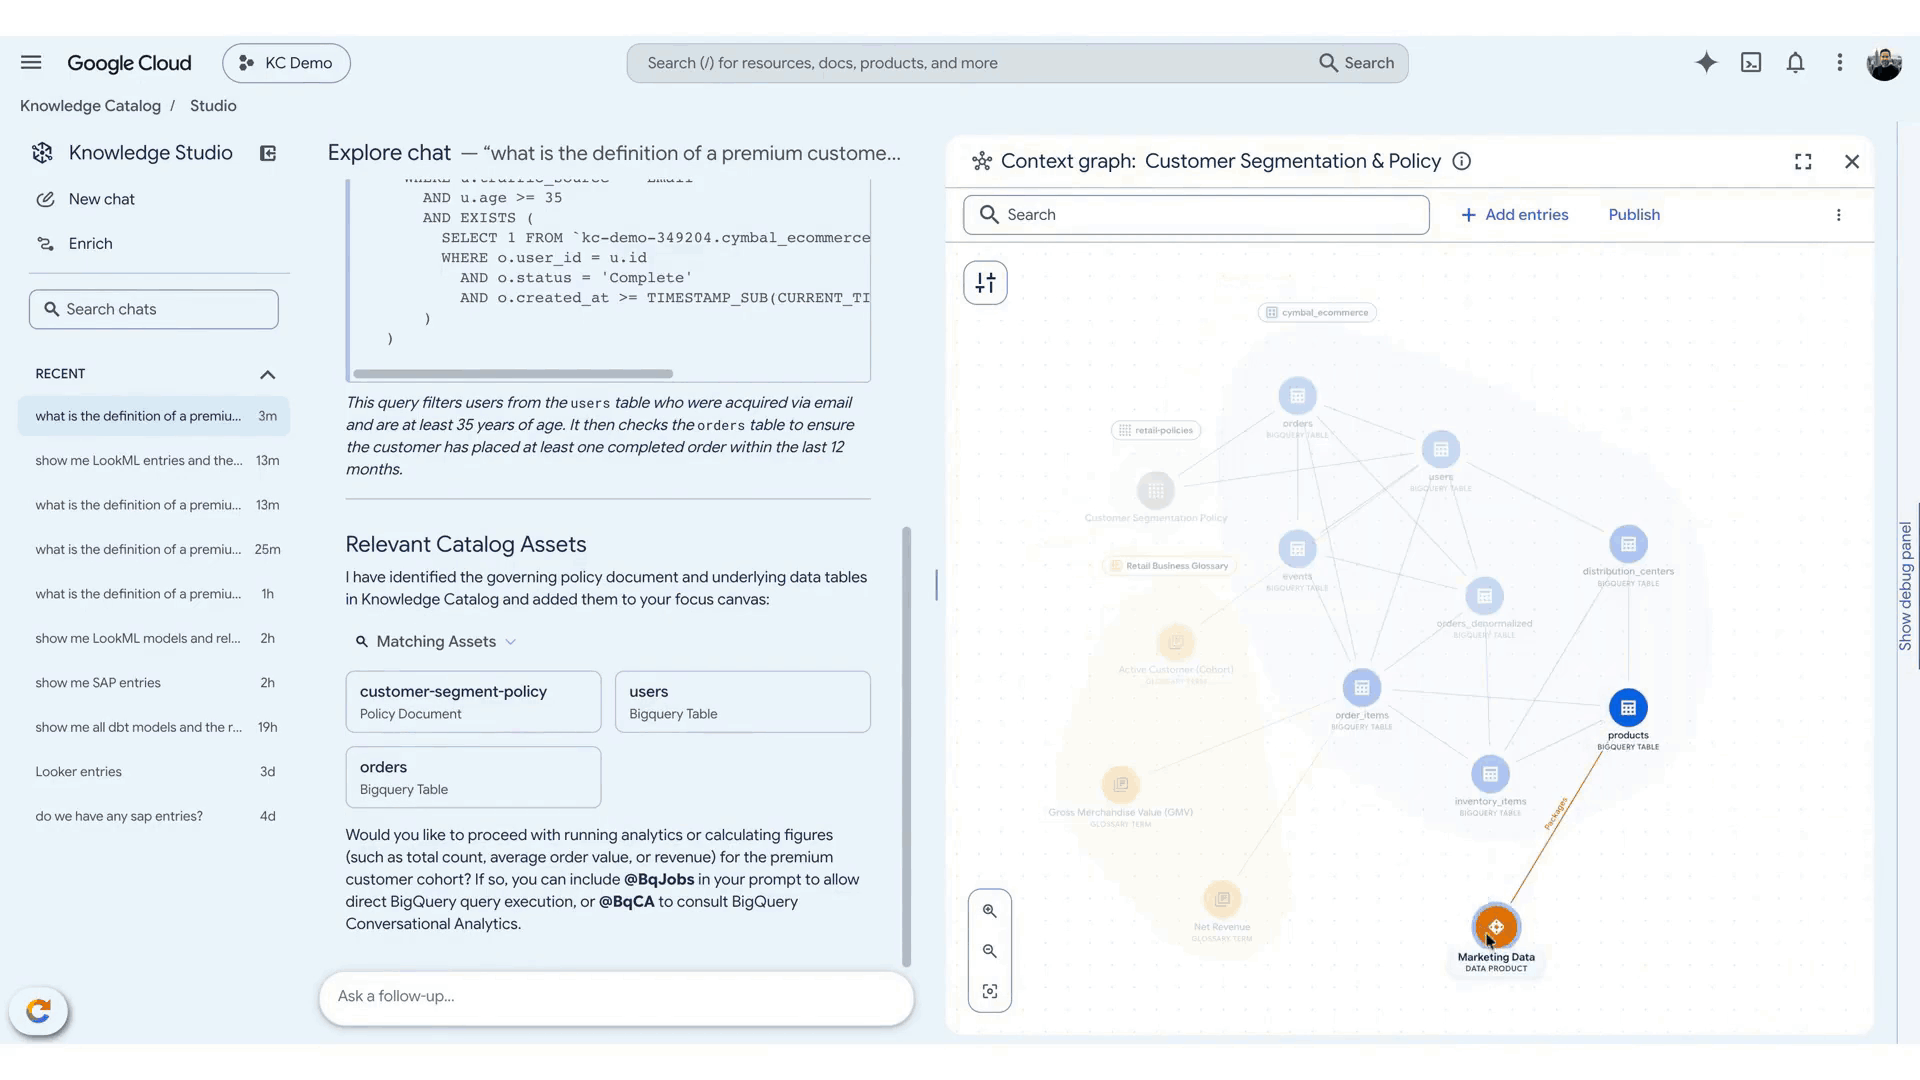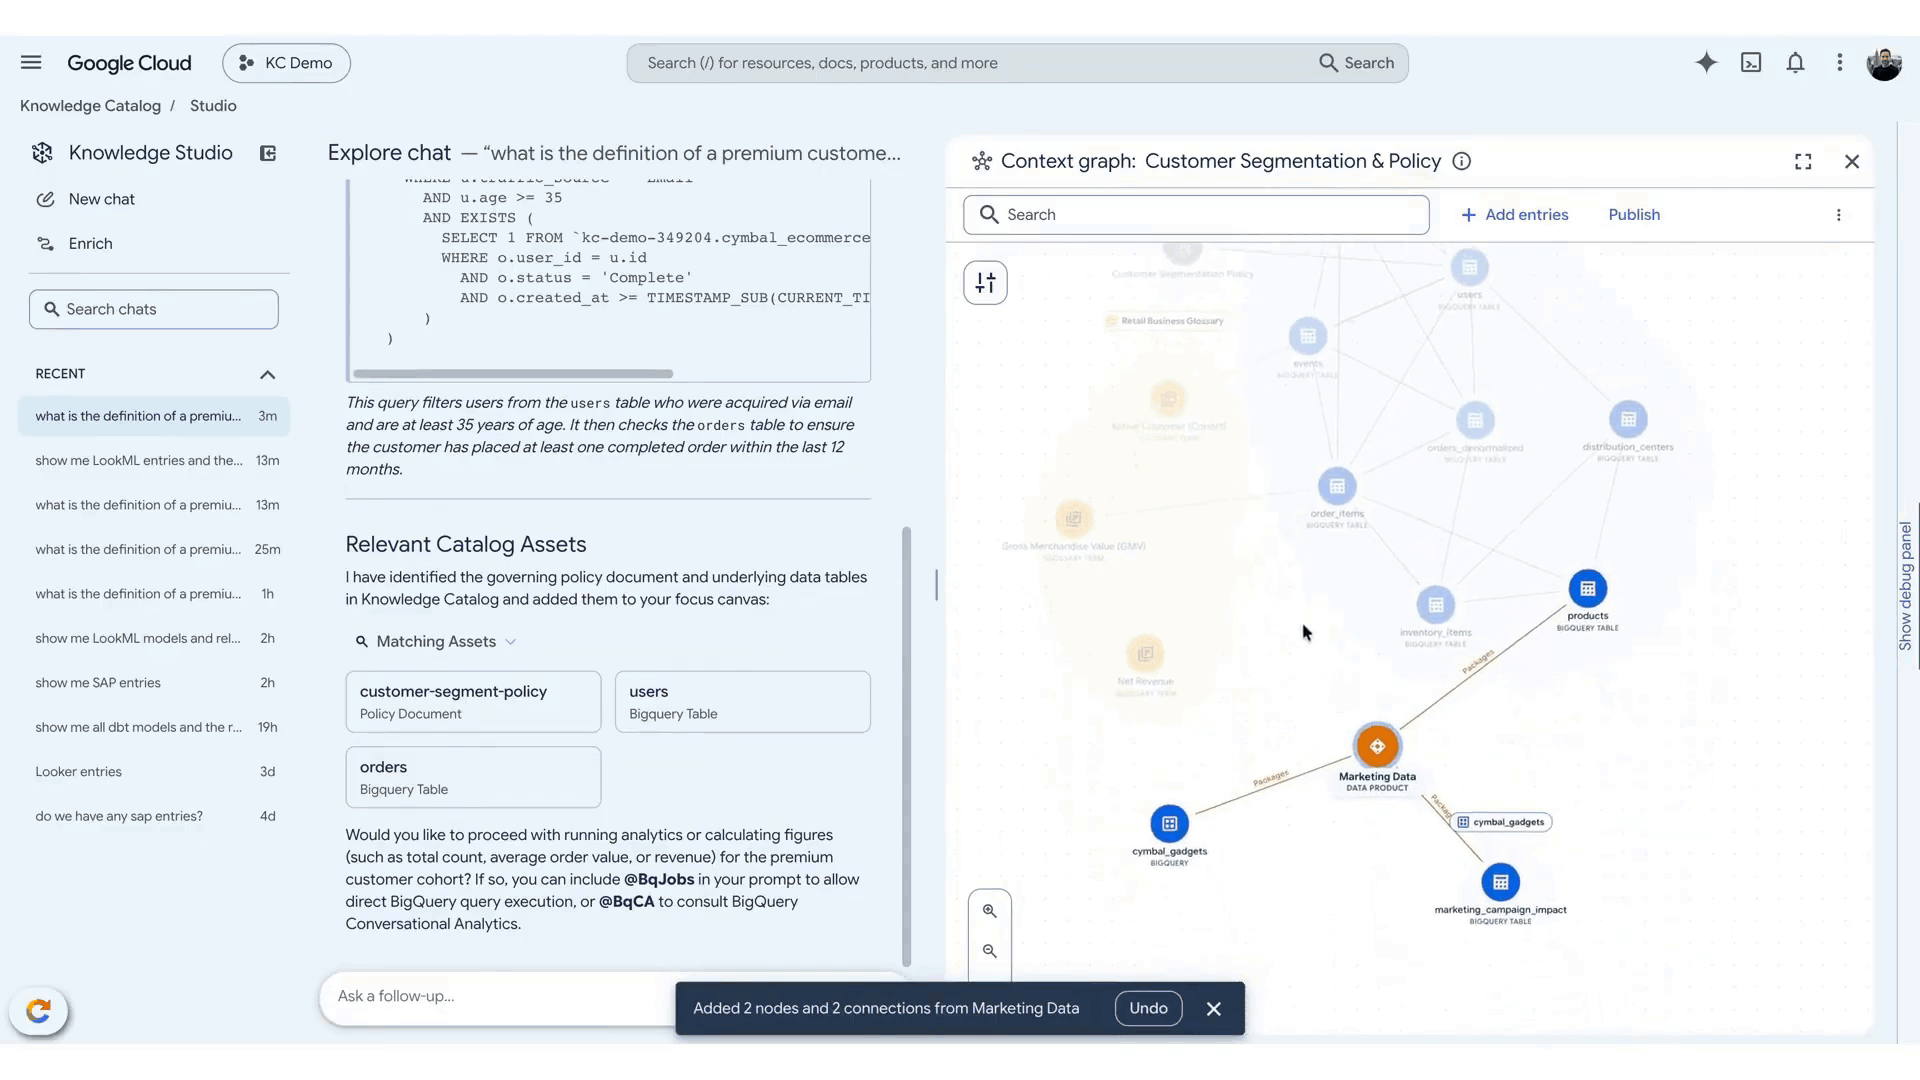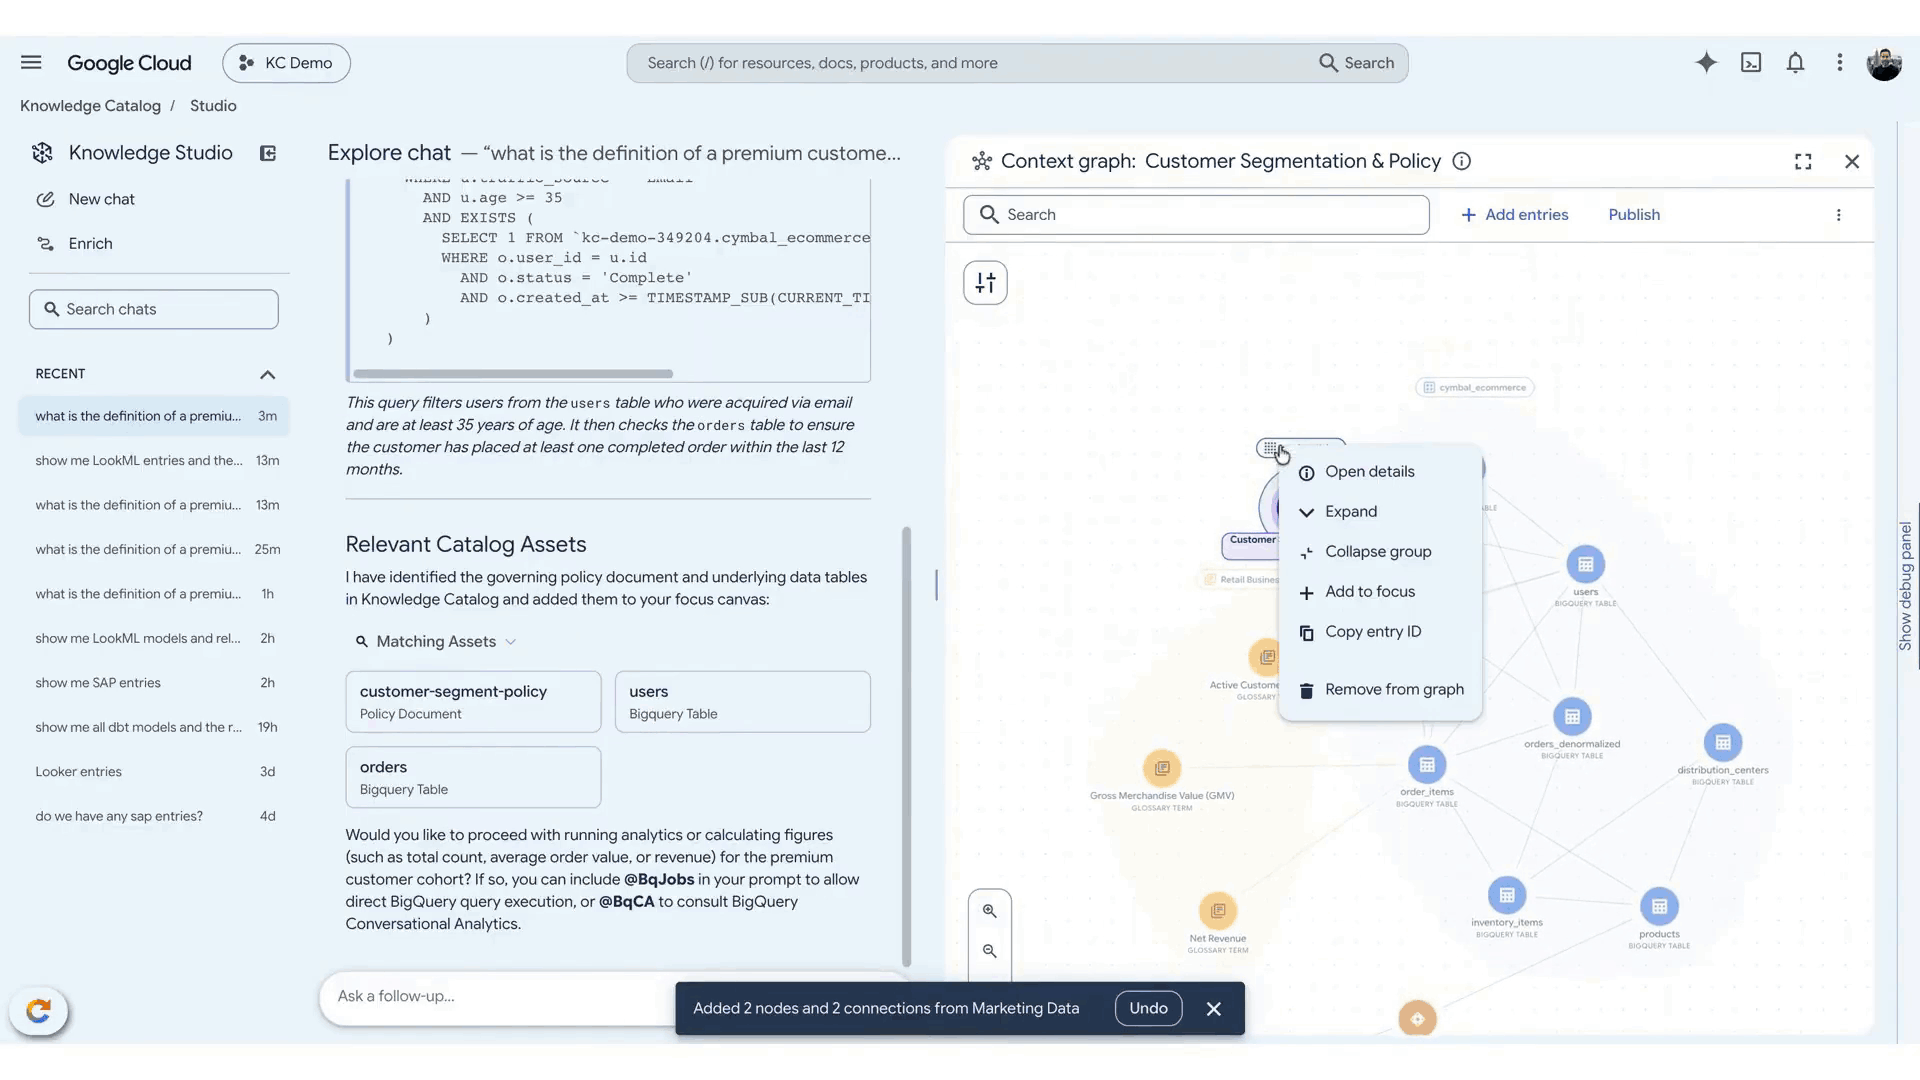
Knowledge Catalog Studioでのコンテキストグラフの視覚的な探索
さらに、Knowledge CatalogがGeminiのデフォルト機能として組み込まれた(プレビュー)。BigQuery、AlloyDB、Cloud SQL、SpannerをGeminiに接続すると、ビジネス用語の解決・信頼できるテーブルの特定・JOIN経路の決定が自動で行われてからSQLが生成される。各ユーザーのアクセス権限の範囲内で処理される点も実運用上の重要ポイントだ。
AlloyDB:3つの異なるユースケースを同時に押さえる
AlloyDB周りのアップデートが今回は特に充実している。
① AlloyDB Express(プレビュー):開発・プロトタイピング用の新エディション。2秒未満のプロビジョニング、スケールゼロへの自動縮退・復帰、プライベートIP接続、1〜2 vCPU/20GBという小さいフットプリントが特徴。コーディングエージェントがデータベースを使い捨て感覚で扱える環境を想定している。
② PostgreSQL for agents in AlloyDB(プレビュー):本番規模のエージェントワークロード向け。数千の並列AIエージェントが同時にライブトランザクショナルデータを参照できるよう、ワークロード分離を実現した。サブミリ秒のI/O、テラビット/秒の集約スキャンスループット、毎秒300万クエリ以上のサポートをうたう。推論セッションがアイドルになると自動でスケールゼロに戻る。
③ AlloyDB直接Icebergアクセス:クラウドストレージ上のApache Icebergテーブルを、ETLやデータコピーなしに単一のPostgreSQLクエリで参照できる。AlloyDBのトランザクションデータとLakehouseの過去データを1つのクエリでJoinできるという点は、「今どきのデータを見つつ過去の集計も参照したい」エージェントのユースケースに直接刺さる。なお、Google Cloudは同等のAmazon PostgreSQL互換サービスと比較して集計クエリが最大7倍高速と主張している(いずれもGoogle Cloud自身による計測値)。
その他の主要アップデート
今回の発表は多岐にわたるが、特にエンジニアが実務で意識しておきたい2点を挙げる。
ボーダレスLakehouseでは、AWS・Azure向けのクロスクラウドインターコネクト&キャッシングがGA(一般提供)になった。プライベート接続で他クラウドのデータをクエリでき、可変エグレス料金はゼロ。Databricks Unity、Snowflake Horizon、AWS Glue向けのオープンIcebergカタログ連携、SAP・Workday・Salesforceとのゼロコピー統合も提供される。Delivery Heroの事例では、Amazon S3テーブルのIcebergデータをBigQueryに連携させることでデータ移動コストを約40%削減したとされている(Google Cloud発表の事例数値)。
Data Agent KitがGAになり、VS Code、Claude Code、Antigravity(AIコーディング支援CLI)といったIDEやCLIからGoogle Data Cloudのツールを直接操作できる。MCP(Model Context Protocol)ツールをネイティブ装備しており、コンソールを行き来するオーバーヘッドをなくす狙いだ。エージェント開発のフィードバックループを短縮するうえで、実務上の影響が大きいアップデートといえる。
BigQueryのクエリ速度向上・GraphのGA・TimesFM/TabFMのネイティブ統合、SpannerのOmni GA、Managed Service for Apache Sparkの改善といったアップデートも同時に発表されているが、詳細は元記事を参照されたい。
詳細はWhat's new across Google's Agentic Data Cloudを参照していただきたい。